第 7 天 GPT
2017 年, Google Brain 的天才们点燃了引线。
5 年后, 这颗惊雷在 OpenAI 公司炸响,说是震惊了全人类也不为过。
并且,就目前它这个不断在前沿科学攻城略地的这个状况来看,未来人工智能必定不只扮演一个替代打工人的角色。未来,它可能要在人类走向星辰大海的归途中承担更为重要的职责。
2022 年,炸响的产品叫「ChatGPT」。
Chat 指它主要以和人对话作为主功能。如果按照曾经的图灵测试来衡量它,毫无疑问地,它已是人类制造的初代人工智能。
名字后半部分的 GPT 是 Generative Pre-Training 的缩写,翻译过来是「生成式预训练模型」。 OpenAI 给自己的模型起了这么个名字,好像给汽车取名叫「汽车牌」一样, OpenAI 这名字起得好霸道,就好像后面就再也不会有来者一样。
7.1 GPT-1:Transformer + 大规模预训练 + 微调会通杀下游任务
确实狂,但人家确实有狂的资本。OpenAI 的 Alec Radford 等人在 2018 年发布的论文 《Improving Language Understanding by Generative Pre-Training》 中首次将「预训练-微调」这种范式应用到了自然语言生成的领域。
「预训练-微调」最开始只是一种分步训练法,一种给网络找到一个良好的初始值,从而更好收敛的训练技巧。而后,它逐渐发展为一种机器学习范式。先用「预训练」让模型像上大学一样学会「通用知识」,再通过「微调」这种类似岗前培训的方式教会模型「领域技能」,从而完成各种下游子任务模型。 GPT 之前,「预训练-微调」这种范式通常应用在图像识别、文本归类、情感分析等分类任务中。这些任务的最终输出通常是一个定长的浮点数组,用以表示各分类的概率,或者干脆是几个回归的标量,用以表示语义相似度或矩阵定点。
2018 年 OpenAI 的 GPT-1 论文中给「预训练-微调」这个玩法插上了 Transformer 的翅膀,唤醒了它「Generative」的能力。GPT-1 的输出是一长串不定长的连续自然语言字符,说人话就是 —— 这个模型会说话了。
人类最主要的 IO 接口就是说话和听人说。现在,这个叫做 GPT 的模型拥有了和我们一样的输出接口。
OpenAI 在输入端,即「预训练」阶段给 GPT-1 读了 7000 多本书,约为 4.5GB 、800M Tokens 的原始文本数据。OpenAI 用的数据集叫做 BooksCorpus ,因为包含大量受版权保护的未出版书籍,已经停止分发。BookCorpusOpen 数据集是它的继任者。
据中国新闻出版研究院调查,2024 年我国成年国民人均纸质图书阅读量为 4.79 本。
GPT-1 拥有 117M 参数。作为参考,昨天我们训练的 Transformer 拥有 63M 参数,GPT-1 大概是它的 2 倍。我们人脑的神经突触大约是 100,000B 个,大概是 GPT-1 的 100 万倍。
结果,这个呱呱坠地的 GPT-1 模型它只需要很简单的「微调」就分别在文本总结、文档分类、相似度评估、问答等大部分语言相关的任务中大幅超越了它之前的模型。
GPT-1 的论文通过控制变量法肯定了 Transformer 的神奇。
同时,虽然 GPT-1 已经把 Generative,放进了自己的名字,但是它主要还是完成分类、总结等传统的自然语言任务。
真正把 Transformer 带进新的「生成式模型」的广阔天地,让人类意识到模型能张嘴说话的,是 GPT-2。
7.2 GPT-2:数据集规模继续扩大,微调也不需要了
2019 年, 还是 Alec Radford 等人,发布了 GPT-2 的论文 《Language Models are Unsupervised Multitask Learners》。
正如论文标题所言, GPT-2 没做微调,只用预训练,即所谓「无监督学习」就再次突破了摘要、理解、翻译、问答等子任务的最高得分,这被称为 zero-shot learning「零样本学习」。
当然,此时的模型还没被对话微调过,所以当时的问答任务的答案大多是一个词。像这样 —— 问:Who won the most mvp awards in the nba? 答:Michael Jordan
论文中,他们说他们的目标是「多任务学习」。事实上,我认为他们是学习了一个更上游更大的任务 —— 对语言本身的学习。人类语言是凌驾所有子任务的超级泛化工具,语言本身能够应对所有语言类的子任务!
为此,OpenAI 开始构建自己的数据集,他们以 Reddit 上获得了 3 个以上点赞的网页为起点,抓取了 WebText 数据集。为了防止模型背答案,他们还特地从 WebText 移除了所有维基百科的页面。
WebText 数据集并没有开源,只提到它的体积是 40GB 左右。我们通过它的开源复现 OpenWebTextCorpus 、OpenWebText 观察一下它,它解压缩后的数据集为 39.77 GB,用 GPT-2 引入的 BPE 分词器分下来大约 9 B Tokens。
和 GPT-1 的数据集比, GPT-1 的数据集规模扩大了 10 倍。
对应的,GPT-2 的参数量提升到了 1.5 B。和 GPT-1 117M 的参数量相比,扩大了 12 倍。
对应的,词表从 GPT-1 的 4 万提升到了 5 万,上下文从 512 提升到了 1024。
GPT-2 的论文摘要中,他们已经认识到模型的性能和参数量成对数线性关系。即参数量按指数增长时,模型性能按线性增长。
假设底是 2 的话,那就是参数量每次翻倍,准确率都会上升一个固定的数字。
| 参数量 \(N\) | \(\log_2 N\) | 假设准确率 |
|---|---|---|
| 117M | 26.8 | 55.0% |
| 234M | 27.8 | 56.5% |
| 468M | 28.8 | 58.0% |
| 936M | 29.8 | 59.5% |
| 1.87B | 30.8 | 61.0% |
表 7-1 准确度和参数量呈对数线性关系的例子
7.3 GPT-3:人工智能?通用的?!
2020 年 5 月, OpenAI 发布了 GPT-3 的论文 《Language Models are Few-Shot Learners》。
署名作者从 1 行变成了 7 行共 31 人,论文的长度从 9 页增长到了 41 页。GPT-3 的论文中包括了类似模型滥用、公平与偏见、能耗等非技术向的内容。
有趣的是,暴增的人数反而使得论文中的细节错误增多了。比如说 表2.1 中提到 GPT-3 XL 模型有 24 个注意力头,每个注意力头有 128 个维度,总维度却为 2048。这是一个简单的计算错误,事实上应该是有 16 个注意力头。论文中还有多处类似这样的事实错误。我相信,如果保持较少人数的写作规模,这种低级错误是不会发生的。
OpenAI 前应用工程负责人 Evan Morikawa 在访谈中提到 2020 年 10 月 OpenAI 拥有大约 150 名员工。我们可以推测, GPT-3 在 OpenAI 内部是一个广泛参与的项目。GPT-3 在 5 月发布后,OpenAI 组建了 Applied(应用)团队,并与同年 11 月开放了 GPT-3 的 API 。
我们可以想像,OpenAI 内部已经隐隐察觉到语言大模型的巨大潜力,他们已经迫不及待地想要把它推向高潮。尤其是它的负责人之一 Dario Amodei。GPT-3 发布之后,OpenAI 内部围绕 Dario 和他在 OpenAI 任职安全政策副总裁的妹妹 Daniela Amodei 形成了一个叫做「Pandas」的圈子。 Pandas 这个名字来自于 Dario 穿着熊猫服参加他妹妹的婚礼,可以想象,这是一个偏领袖导向的圈子。Pandas 致力于在 OpenAI 内部推动大语言模型从开源走向闭源。 Dario 也在 GPT-3 发布后不久就要求自己在 OpenAI 内部获得更好的待遇和更高的话语权。他在获得和创始人相同的待遇之后,他又进一步要求自己不再做任何人的下级,必须直接向董事会汇报。
回过头看,当时 GPT-3 的模糊身影已经埋藏了 Anthropic 的诞生。 有意思的是,Dario Amodei 出走 OpenAI 时给的理由是他认为 OpenAI 过于看重市场收益,已经不再服务于全人类的共同利益。所以,他在 2021 年 1 月用 Anthropic 命名了他新创立的公司。当然,何谓「全人类」主要是由他自己定义的。
此时,距离 ChatGPT 的爆发,已近在咫尺。
GPT-3 肯定了「语言」这个父任务的泛化能力,称之为「元学习」。
论文使用 few-shot 进一步否定了微调在处理下游子任务时的必要性。他们仅用 few-shot ,或用他们新起的名字 ——「上下文学习」的方式就在翻译和问答等子任务上打平或超越了之前的模型。虽然微调仍然能取得更优的结果。
GPT-3 的这种不需要微调就能完成下游任务的能力引爆了第一波的「提示词工程」的浪潮 —— 人们争相精心调整和分享输入模型的指令,以在不付出微调成本的前提下获得更佳的模型输出。
GPT-3 使用了一个 Common Crwal / WebText2 / Books1 / Books2 / Wikipedia 混合的数据集,具体的数据集并未公开发布。他们只在表 2.1 的说明里提到每个模型总训练量都是 300B Tokens。
模型架构方面,论文延续了 GPT-2 的架构,但是进一步提升性能,论文把参数量扩充了到了最大 175B,上下文从 1024 扩充到了 2048。
彼时,马斯克已经退出了 OpenAI,微软用现金 + Azure 算力入股了 OpenAI。GPT-3 是在微软的集群上的 V100 多机多卡训练出来的。
论文的行文中,花了很大篇幅去论证这个 GPT-3 是真的实现了泛化还是由于扩大了数据集而不小心混进了测试集。又花了不少篇幅去讨论,如果这真的是泛化出的智能,那它将对人类社会造成什么影响。
字里行间中,我能感觉到匆匆写下这篇错误十出的家伙们,有点得意忘形,开始在畅想欲言又止的未来了。
和 GPT-2 开放权重下载不同, GPT-3 不再开放权重,专门组建了团队开发 API ,通过 API 向公众开放服务。OpenAI 从这里开始了他们的闭源之路。
从每参数训练 Tokens 来看, GPT-1 的每参数 Tokens 为 800M / 63M = 12, GPT-2 是 9B / 1.5B = 6, GPT-3 是 300B / 175B = 1.7。
很容易能知道, GPT-3 是一个训练并不充分的、匆匆发布的模型。所以,它后续版本的到来就是意料之中的了。
7.4 ChatGPT:通用人工智能!
时隔一年,2022 年 11 月, ChatGPT 发布。
ChatGPT 它不再是个只能被程序员调用的 API,它是一个只要你有浏览器就能打开的交互式网页。
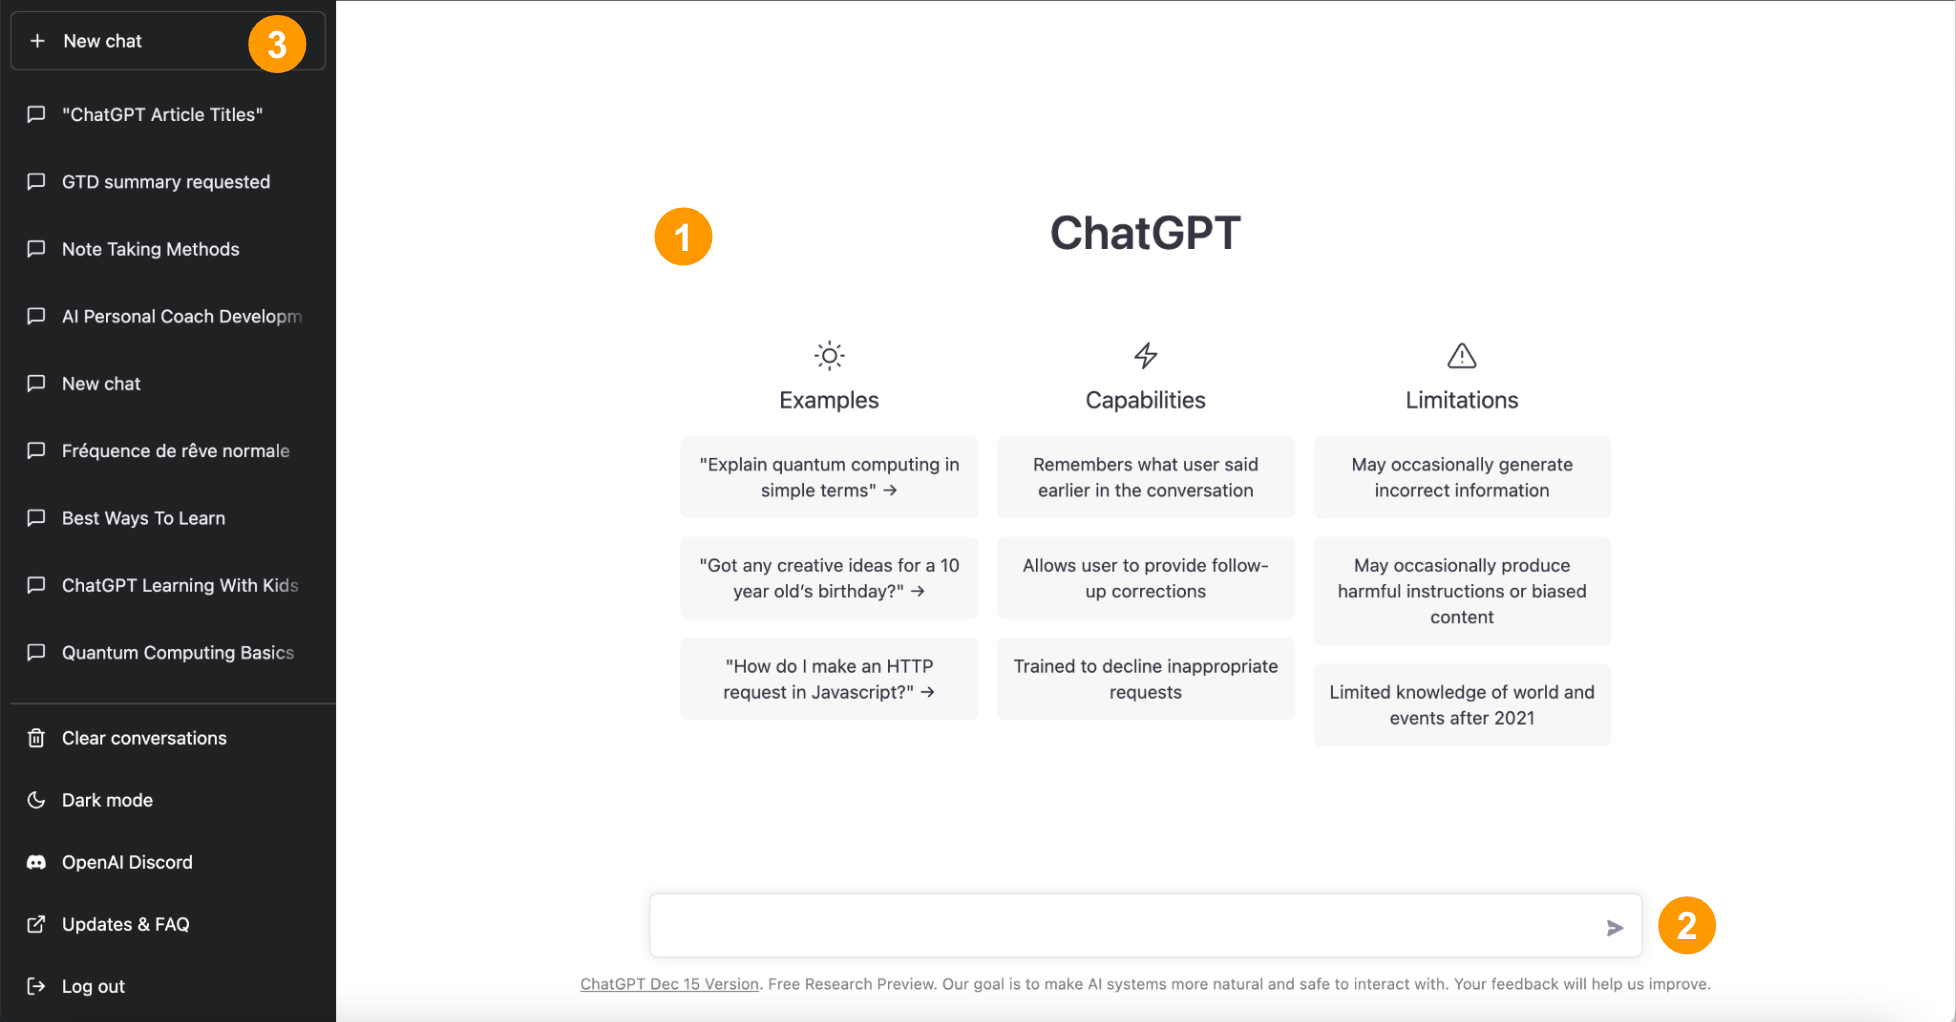
图 7-1 ChatGPT 的初版界面
凌空炸响。
当时的盛况无需多言。
OpenAI 并没有发布一篇关于 ChatGPT 的论文。在发布 ChatGPT 的简短博文 《Introducing ChatGPT》 中,OpenAI 透露在 ChatGPT 背后的大模型是基于 GPT-3.5 微调的,并且是 InstructGPT 的一个 sibling model 兄弟模型。
OpenAI 并没有为 GPT-3.5 发布技术论文。我们只能通过它的名字猜测,它多半是一个网络结构和 GPT-3 大致相同,但经过更精心调优的大语言模型。
这个「精心调优」的过程 OpenAI 没有展开说明,但是我们可以通过 InstructGPT 的论文窥见一斑。
2022 年 3 月, OpenAI 发布了 InstructGPT 的论文 《Training language models to follow instructions with human feedback》。
论文中, OpenAI 把他们 1.3B 参数量版本的 GPT-3 先经过 13,000 条数据的监督微调,然后用 33,000 条数据训练了一个奖励模型,最后再拿 31,000 条数据给模型做了强化学习。
这样处理后的 1.3B 参数量的 GPT-3 居然在 71% 的情况下比 175B 的全尺寸版本的 GPT-3 更受用户欢迎。
同时, 监督微调和强化学习后的 1.3B 参数量的 GPT-3 的幻觉率仅为 175B 的全尺寸版本的一半。
请注意,它俩的参数量相差了 100 倍还多。
论文中认为原因是 GPT-3 在训练时被赋予的任务说到底还是在预测互联网网页上的下一个 Token,而不是完成用户告诉它要做的事情。这样,模型建模的目标和用户的目标就产生了错位。
而纠正这个错位的责任,之前是落到了用户头上的,变了个名字叫做「提示词工程」。
所以,OpenAI 选择使用微调和后训练,进一步训练 GPT-3 ,尝试让它学会自己遵循用户指令。以在模型内部缩减这个训练目标和用户产品目标的错位。
从 InstructGPT 的论文来看,效果是令人满意的。
我们合理猜测, OpenAI 把这套用在 1.3B 模型上的方法论搬到了 175B 的模型上,给大家端出了一盘大菜。
我们今天要做的,就是复现这个 1.3B 参数量的 GPT-3 模型的预训练版本。
7.5 复刻 GPT-3 XL
为了验证模型的准确率是随参数量增长而增长,而且上下文学习能力也越来越强, GPT-3 在论文中训练了 8 个不同尺寸的模型。
| 模型名称 | 参数量 |
|---|---|
| GPT-3 Small | 125M |
| GPT-3 Medium | 350M |
| GPT-3 Large | 760M |
| GPT-3 XL | 1.3B |
| GPT-3 2.7B | 2.7B |
| GPT-3 6.7B | 6.7B |
| GPT-3 13B | 13.0B |
| GPT-3 175B or "GPT-3" | 175.0B |
表 7-2 GPT-3 系列模型的尺寸
今天我们来尝试复刻中间的那个 1.3B 参数量的 GPT-3 XL 模型。
7.5.1 走向工程化
GPT-3 论文的附录 D 中披露了 GPT-3 各个尺寸模型的训练用时。具体到 GPT-3 XL,它的训练用时是 2.38e21 FLOPS。假设我们使用 RTX PRO 6000 Blackwell Workstation Edition 这张卡进行训练,查它的 SPEC 我们能知道它的 FP16 的算力是 500 TFLOPS。那么,我们就能大概估算出我们的单卡训练用时了。
式 7-1 GPT-3 XL 在 RTX PRO 6000 上的训练用时估计
当然,现在是 2026 年,距离 GPT-3 论文中的数据过去 6 年了。这 6 年,英伟达和 PyTorch 的优化团队也不是吃干饭的,我们的实际耗时肯定要比 55 天要低不少。
但总之,这次我们要做的是一个训练时长以天计数的任务。
而且,我们已经逐渐熟悉了 PyTorch 和神经网络的一些基本性格,我们对 Jupyter Notebook 的强项 —— 调试便利性的需求在下降。
随着训练的模型越来越大,我们对离线运行、日志分析、稳定性、进程结构简化、多机多卡训练的需求在上升,现在我们需要一个更加工程化一些的工具。
我们选择使用 uv 和 python 脚本的搭配代替 Jupyter Notebook 来复刻 GPT-3 的训练。
uv 是一个 python 的包管理工具,2026 年 3 月被 OpenAI 收购了。我们使用以下的命令安装它。
然后我们用如下的命令初始化一个 uv 项目。
uv init ch7-gpt --bare
cd ch7-gpt/
uv add dotenv==0.9.9
uv add httpx==0.28.1
uv add modelscope==1.40.0
uv add sentencepiece==0.2.2
uv add torch==2.14.0
或者,也可以从我们的仓库下载源代码,用 uv sync 同步我们预制好的环境。
这样我们就初始化好了的环境,之后我们默认都在这个项目目录底下干活。
岔出去说句闲话,因为从今天开始,我们的训练时长都以天计算,再使用手动实现的网络结构拉长的训练时间会显著到有点不能接受。且我们已经度过前期了解神经网络和 PyTorch 的阶段,所以从今天往后,我们不再重复实现手动版和 PyTorch 高层 API 版 2 个版本。我们以攫取最大的性能,暴露尽可能多的技术细节为目标,后面我们都以 SDPA 这个 PyTorch 主力优化的 API 为界,尽量在这个层面上实现我们的网络。这也是 2026 年大多数基于 PyTorch 的预训练神经网络项目的现状。
另外,岔出去还有句闲话,从 GPT-3 论文附录 D 的 表 D.1 中,我们还能 get 到一个重要信息 —— GPT-3 各尺寸模型的 FLOPS per param per token 都是 6。这意味着,模型训练时长是和模型参数量成严格线性关系的。这是一个相当不错的好消息,这意味着我们不会因为训练更大尺寸的模型而付出额外的训练成本。
7.5.2 CCI3.0 数据集
照例,我们先要搞定数据集。
论文 3.3 节中提到, GPT-3 用的数据集里 93% 的语料都是英文。那我们肯定不能用他们的,咱得用中文的数据集。
2025 年 1 月 9 日,在中央网信办指导下,中国网络空间安全协会人工智能安全治理专业委员会工作年会上,中文互联网语料资源平台 面向社会发布。登录这个网站,进入它的数据集栏目,我们发现它有两个数据集的专题,其中一个是 CCI。
CCI 是北京智源人工智能研究院发布的中文语料库,质量相当高,而且北京智源还保持持续更新。今天,我们使用 CCI 3.0 的 HQ 即高质量语料版本作为我们的预训练数据集。所谓的「高质量」,我们可以在它的卡片页面看到,北京智源做了一系列测试,同样的训练过程,把其它的中文语料换成它,都会明显提升训练结束后模型的表现。
modelscope 支持用通配符下载数据集中的部分文件。我们下载 CCI3 的前 300 个文件回来。
modelscope download --dataset BAAI/CCI3-HQ --local_dir ./cci3-hq-data --include "data/part_000[0-2][0-9][0-9].jsonl"
7.5.3 训练 BPE 分词器
7.5.3.1 优化 MFU
和昨天一样,我们先得训练一个自己的分词器。然后,考虑到这次的训练时长比较长,我们希望 GPU 利用率不能再像昨天一样徘徊在 30% 到 40% 之间了,不然训练时长从 10 天变 20 天有点代价太大了。今天这种情况下,花几天时间做性能优化是值得的。我们希望这次 GPU 的利用率能保持在 100%,尽量缩短我们的训练时长。
并且,在 GPU 使用率跑满的前提下,我们还希望进一步考察另一项指标 MFU Model FLOPs Utilization 模型算力利用率。
以前,我们 CPU 编程的时候, CPU 跑到 100% 也不都是在用力帮我们跑计算,也可能是在等磁盘或者网络 IO,它卡在非阻塞 IO 的 spinlock() 自旋等待的死循环里,或是等待在阻塞 IO 命中了脏内存页取回数据的途中。这些情况下, CPU 处于一种看似很忙,实则在摸鱼的状态。 GPU 也会这样。所以,我们把 GPU 使用率优化到 100% 也并不意味着优化的终点。
在 GPU 使用率 100% 之后,我们需要进一步考虑 MFU 这个指标,这是 Google 提出的一个指标。GPT-3 发布大约 2 年后,2022 年 4 月, Google Research 发布 PaLM 模型的论文 《PaLM: Scaling Language Modeling with Pathways》 ,论文的 4.1 节中,他们这样写道。
We propose a new metric for efficiency that is implementation-independent and permits a cleaner comparison of system efficiency, called model FLOPs utilization (MFU). This is the ratio of the observed throughput (tokens-per-second) relative to the theoretical maximum throughput of a system operating at peak FLOPs.
MFU 有点像优化 CPU 程序时用的 IPC Instructions Per Cycle 每时钟周期指令数。其实,MFU 是一个比 GPU 使用率更容易理解的指标,它的计算方法如下。
式 7-2 MFU 计算方法
MFU 这个指标指引我们尽量把 GPU 时间花在计算上,而不是白消耗在等 IO 上。可以想见,因为不同的神经网络架构处理数据的方式不同,会有不同的 MFU 优化天花板。所以,极致的 MFU 优化不仅得折腾代码,还得像 DeepSeek 那样从模型架构的层面去考虑。一般而言,目前的 MFU 通常应该落在 30% 到 60% 这个区间,低于 30% 就真的有点太低了。要是高于 60% 很多,而且是基于 Transformer 的模型,那就真的有点太强,如果不是一步一步认真优化上去的话,得需要仔细看看是不是自己哪里写错了。
我们寄希望于两个优化手段。
一、在训练前把语料的分词工作完成,让模型在训练时直接读取 Token ID 流;
二、因为 AutoDL 孱弱的 SSD 性能和特别慷慨的内存容量,我们希望把我们的数据集事先拷贝到内存里。让 DataLoader 从内存里读取数据,避开 SSD 读取带宽不足所导致的 GPU 利用率降低;
我们可以用工具简单测试一下 AutoDL 的内存带宽。
apt update
apt install -y mbw

# 下面第一个参数里的 -n 10 是指测试 10 次求均值
# 下面第二个参数里的 -t 0 是指用 memcpy() 开展内存拷贝
# 下面第三个参数里的 8192 是指总共拷贝 8192MB 的数据
# 注意第三个参数值应远大于 CPU 的 Cache 大小,以穿透之。现代 CPU 可能有约小几百兆的 L3 Cache,应大于这个值

mbw -n 10 -t 0 8192
执行上面的命令,我们会得到以下的输出。
Getting down to business... Doing 10 runs per test.
0   Method: MEMCPY  Elapsed: 1.54836    MiB: 8192.00000 Copy: 5290.763 MiB/s
1   Method: MEMCPY  Elapsed: 1.54855    MiB: 8192.00000 Copy: 5290.100 MiB/s
2   Method: MEMCPY  Elapsed: 1.54815    MiB: 8192.00000 Copy: 5291.467 MiB/s
3   Method: MEMCPY  Elapsed: 1.54791    MiB: 8192.00000 Copy: 5292.314 MiB/s
4   Method: MEMCPY  Elapsed: 1.54881    MiB: 8192.00000 Copy: 5289.215 MiB/s
5   Method: MEMCPY  Elapsed: 1.54906    MiB: 8192.00000 Copy: 5288.365 MiB/s
6   Method: MEMCPY  Elapsed: 1.54238    MiB: 8192.00000 Copy: 5311.255 MiB/s
7   Method: MEMCPY  Elapsed: 1.54917    MiB: 8192.00000 Copy: 5288.003 MiB/s
8   Method: MEMCPY  Elapsed: 1.54950    MiB: 8192.00000 Copy: 5286.870 MiB/s
9   Method: MEMCPY  Elapsed: 1.54772    MiB: 8192.00000 Copy: 5292.954 MiB/s
AVG Method: MEMCPY  Elapsed: 1.54796    MiB: 8192.00000 Copy: 5292.122 MiB/s
能看到,我们内存每秒能拷贝 5 个 GB 左右。
我们再测试一下 SSD 的随机读性能。
apt update
apt install -y fio

# 下面参数里的 direct 是指调用 open() 时加上 O_DIRECT 掩码,绕过页缓存,直接存取磁盘
# 下面参数里的 numjobs 可以类比 DataLoader 的 num_workers,都是指起多少个线程来读
# 下面参数里的 iodepth 可以类比 DataLoader 的 prefetch_factor,都是指每个线程起多少个非阻塞 IO 去读取
#
# fio 的官方文档在 https://fio.readthedocs.io/en/latest/fio_doc.html#command-line-options

fio --name=rnd2k \
    --filename=/root/autodl-tmp/fio_test.bin \
    --size=8G --rw=randread --bs=2k \
    --direct=1 --ioengine=libaio \
    --iodepth=32 --numjobs=4 \
    --time_based --runtime=60 \
    --group_reporting
执行上面的命令,我们会得到以下输出。
rnd2k: (g=0): rw=randread, bs=(R) 2048B-2048B, (W) 2048B-2048B, (T) 2048B-2048B, ioengine=libaio, iodepth=32
...
fio-3.28
Starting 4 processes
rnd2k: Laying out IO file (1 file / 8192MiB)
Jobs: 4 (f=4): [r(4)][100.0%][r=1217KiB/s][r=608 IOPS][eta 00m:00s]
rnd2k: (groupid=0, jobs=4): err= 0: pid=2704: Mon Oct 26 15:19:02 2026
  read: IOPS=816, BW=1633KiB/s (1672kB/s)(96.3MiB/60370msec)
    slat (usec): min=2, max=599979, avg=4025.97, stdev=17403.92
    clat (usec): min=990, max=1411.6k, avg=152506.75, stdev=125674.35
     lat (usec): min=1013, max=1411.6k, avg=156532.98, stdev=128937.48
    clat percentiles (msec):
     |  1.00th=[   10],  5.00th=[   26], 10.00th=[   39], 20.00th=[   61],
     | 30.00th=[   81], 40.00th=[  103], 50.00th=[  133], 60.00th=[  148],
     | 70.00th=[  182], 80.00th=[  209], 90.00th=[  284], 95.00th=[  372],
     | 99.00th=[  667], 99.50th=[  802], 99.90th=[ 1062], 99.95th=[ 1150],
     | 99.99th=[ 1250]
   bw (  KiB/s): min=  228, max= 3216, per=100.00%, avg=1638.67, stdev=189.74, samples=480
   iops        : min=  114, max= 1608, avg=819.33, stdev=94.87, samples=480
  lat (usec)   : 1000=0.01%
  lat (msec)   : 2=0.01%, 4=0.10%, 10=0.93%, 20=2.46%, 50=11.58%
  lat (msec)   : 100=23.87%, 250=47.84%, 500=10.85%, 750=1.70%, 1000=0.50%
  lat (msec)   : 2000=0.16%
  cpu          : usr=0.06%, sys=0.28%, ctx=18550, majf=0, minf=116
  IO depths    : 1=0.1%, 2=0.1%, 4=0.1%, 8=0.1%, 16=0.1%, 32=99.7%, >=64=0.0%
     submit    : 0=0.0%, 4=100.0%, 8=0.0%, 16=0.0%, 32=0.0%, 64=0.0%, >=64=0.0%
     complete  : 0=0.0%, 4=100.0%, 8=0.0%, 16=0.0%, 32=0.1%, 64=0.0%, >=64=0.0%
     issued rwts: total=49284,0,0,0 short=0,0,0,0 dropped=0,0,0,0
     latency   : target=0, window=0, percentile=100.00%, depth=32

Run status group 0 (all jobs):
   READ: bw=1633KiB/s (1672kB/s), 1633KiB/s-1633KiB/s (1672kB/s-1672kB/s), io=96.3MiB (101MB), run=60370-60370msec

Disk stats (read/write):
    md0: ios=49433/1364, merge=0/0, ticks=4848780/8152796, in_queue=13001576, util=99.68%, aggrios=24718/911, aggrmerge=0/279, aggrticks=2325170/147853, aggrin_queue=2481776, aggrutil=99.21%
  sdb: ios=32053/913, merge=0/277, ticks=3294071/244866, in_queue=3549530, util=99.21%
  sdc: ios=17383/909, merge=0/281, ticks=1356269/50841, in_queue=1414023, util=52.67%
能看到, AutoDL 的 SSD 的 2K 随机读取带宽为 1633 KB ,也就是 1.5 个 MB,和内存 5 个 GB 的带宽之间差出去 3 个数量级。我感觉 AutoDL 的数据盘有可能是网络挂载的,或者我们的容器邻居们用得太疯狂了。
不管到底是为什么了,总之我们肯定是随机读,要是直接把这个性能的 SSD 直接接入我们的 DataLoader 的话,肯定会拖累我们的 GPU。昨天我们超低的 GPU 利用率多半也是因为它。
我们要把数据集预读到内存里来。
因为 DataLoader 还是习惯于从磁盘上读取数据,所以我们的基本的思路是从 AutoDL 慷慨的内存中搞出 2 个 G 来做 ramdisk,然后在 DataLoader 读取数据之前把数据预拷贝到 ramdisk 里,让它从内存里读。
好在 Linux 给我们提供无比方便的 ramdisk 工具箱。我们在目录 /dev/shm 中创建的文件和目录自动就会成为 ramdisk 的文件和目录, AutoDL 已经帮我们挂载好了。
7.5.3.2 BPE 的配置类 Config
我们需要做的就是把我们的数据集先给分词分好,然后把分词分出来的 Token ID 流给集结成适合往 ramdisk 里拷贝的大块文件。我们预备每 128MB 的 Token ID 打包成一个后缀为 .bin 的文件。
我们创建一个 Config 类,把我们以上的计划,和其它要用到的训练 BPE 分词器需要用到的配置类的变量给集结到一起。
import array
import json
import math
import os
import gc
import queue
import random
import shutil
import threading
import time
import torch
import sentencepiece as spm
import multiprocessing as mp

class Config:
    data_dir = "./cci3-hq-data/data"     # 存放 *.jsonl 的目录
    tokenizer_path = "./tokenizer.model" # SentencePiece 模型存放位置
    token_bin_dir = "./token_bins"       # uint16 token 分片输出目录
    sample_filename = "sp_sample.txt"    # token 采样文件名

    # -------------------------- BPE 训练相关配置 --------------------------
    vocab_size = 64000                   # 词表大小 < 65536,token ID 可用 uint16 存储
    sp_model_type = "bpe"
    sp_character_coverage = 0.9995       # 中文语料建议 0.9995
    sp_byte_fallback = True              # 未登录字符回退到字节,保证无损
    sp_normalization = "identity"        # 归一化用 identity 而不是 nmt_nfkc:NFKC 会把全角逗号","转成半角",",
    sp_add_dummy_prefix = False          # 中文不需要在句首补空格
    sp_remove_extra_whitespaces = False  # 保留原始空白,保证无损还原
    sp_sample_chars = 3_000_000_000      # 分词器训练语料的抽样量 - 字符上限,至少应有 3 亿。也不能太多,太多 BPE 合并会很慢。 3 亿字符大概是 1G 磁盘占用,大概是 7G 内存占用
    sp_sample_sentences = 900_000_000    # 分词器训练语料的抽样量 - 句子数上限,通常先撞到字符数限额
    sp_doc_stride = 8                    # 每 8 篇文档取 1 篇,让抽样铺开到整个语料
    sp_max_sentence_bytes = 8192         # 超过此长度的句子会被切开
    sp_num_threads = 22
    sp_unk_id, sp_bos_id, sp_eos_id, sp_pad_id = 0, 1, 2, 3

    # ---------------------- 语料转 token ID 流分片相关配置 -----------------------
    tokenize_processes = 20              # 分词并行进程数
    tokenize_batch_docs = 512            # 每个任务包含多少篇文档
    tokenize_super_batch = 44            # 一次派发多少个任务包(控制内存占用)
    shard_bytes = 128 * 1024 * 1024      # 单个 .bin 分片大小(128 MiB ≈ 6710 万 token)
    val_doc_modulo = 1000                # 每 1000 篇文档抽 1 篇进验证集
    max_val_tokens = 5_000_000           # 验证集 token 上限
    limit_docs_per_file = None           # 每个 jsonl 只读前 N 篇文档(None = 全读)
    block_size = 4096                    # 上下文长度。原始论文中为 2048。cci3-hq 中 17.6% 的文档长度大于 2048 , 6.4% 大于 4096,2.1% 大于 8192 , 故取此值
可以看到,和 GPT-3 使用的 2048 上下文不同的是,我们在最后一个配置项,配置了上下文长度为 4096。这是因为 CCI3-HQ 数据集中有 6.4% 的数据条目长度大于 4096,我们不训练一个 4096 上下文的模型出来实在有点浪费这么好的数据集。此时,我们应该意识到一个问题 —— 现在流行的那些 1M 上下文的模型是咋搞出来的?一般互联网爬一个页面,其正文长度也就几 K,维基百科里的内容可能长一点,那也就几十 K。像《活着》这样的中长篇小说,也才 200 多K。那么,现在那么些 1M 上下文的模型是去哪里整的 1M 长的有内在联系的文本作为它们的数据集的呢?我们先在心里埋一个问号,后面几天我们再来逐步解开这个谜。
7.5.3.3 准备几个工具函数
继续往下训练我们的 BPE 之前,我们先准备几个工具函数。
# =============================================================================
#                                  Utils
# =============================================================================

# 打日志用
def log(msg):
    print(f"[{time.strftime('%H:%M:%S')}] {msg}", flush=True)

# 显示人类友好的文件体积用
def fmt_count(n):
    for unit, div in (("T", 1e12), ("B", 1e9), ("M", 1e6), ("K", 1e3)):
        if n >= div:
            return f"{n / div:.2f}{unit}"
    return str(int(n))

# 显示人类友好的时间字符串用
def fmt_duration(seconds):
    if seconds != seconds or seconds in (float("inf"), float("-inf")) or seconds < 0:
        return "--"
    seconds = int(seconds)
    d, seconds = divmod(seconds, 86400)
    h, seconds = divmod(seconds, 3600)
    m, s = divmod(seconds, 60)
    if d:
        return f"{d}d{h:02d}h{m:02d}m"
    if h:
        return f"{h}h{m:02d}m{s:02d}s"
    return f"{m}m{s:02d}s"

# 返回 CCI3-HQ 中所有数据集文件的文件名,它们都是 jsonl 格式的
def list_jsonl_files(data_dir):
    if not os.path.isdir(data_dir):
        raise FileNotFoundError(f"找不到语料目录 {data_dir}")
    names = sorted(f for f in os.listdir(data_dir) if f.endswith(".jsonl"))
    if not names:
        raise FileNotFoundError(f"{data_dir} 下没有 .jsonl 文件")
    return names

# 这个函数的用途是给定一个数据集文件,返回指定数量的 (doc_id, text) 对
#
# 这是一个 python 的「生成器」,其实就是把循环给你提前写好了
# 未来直接用这个「生成器」就可以,不用写循环了
# 它的优点在于是所谓「惰性」—— 就是和你写循环一样,用多少读多少,而不是一次把整个文件读到数组里,然后再从数组给你返回
#
def iter_docs(path, limit=None):
    n = 0
    with open(path, "r", encoding="utf-8", errors="replace") as f:
        for line in f:
            if not line.strip():
                continue
            try:
                obj = json.loads(line)
            except json.JSONDecodeError:
                continue
            text = obj.get("text")
            if not text:
                continue

            # 下面的 python 中的 yield 是一种特殊的 return
            # 它与 return 相同的地方在于它也会退出函数且返回值
            # 它与 return 不同的地方在于它不像 return 退出的时候把清空函数栈帧, 即属于函数的那个 Frame。 yield 会保留函数栈帧,即保留包括局部变量在内的所有函数「状态」
            # 如果之前充分理解了「闭包」的概念的话, yield 可以理解为是 python 的超级闭包语法糖,它把函数 Frame 也给闭包了
            yield obj.get("id", ""), text
            n += 1
            if limit is not None and n >= limit:
                return


# 给定一个 doc_id ,返回它是数据集还是测试集
# 返回值由对 modulo 求模获得,所以只有 modulo 分之一的 doc_id 会被返回为测试集
def is_val_doc(doc_id, text, modulo):
    key = doc_id if doc_id else text[:64]
    h = 0
    for ch in key[:16]:
        h = (h * 131 + ord(ch)) & 0xFFFFFFFF
    return h % modulo == 0
这几个函数都比较简单,唯一新接触的是 python 的 yield。它们帮我们从磁盘上把数据集里的具体条目读出来,有了它们,我们接下来就开始训练我们的 BPE 分词器模型。
7.5.3.4 训练 BPE
有了这些打日志和读文件的工具函数,我们就可以开始训练我们的分词器了。和昨天一样,分词算法我们选择 BPE Byte Pair Encoding 。
在开始训练 BPE 之前, 我们需要为它准备好一个独立文件的 sample.txt 作为它的输入。
# =============================================================================
#                       阶段一:训练 SentencePiece BPE 分词器
# =============================================================================

# 为满足 SentencePiece 的输入格式要求
# 我们用这个函数把文档切成最长 max_bytes 的字符串片段
# 看到 for 和 yield 组合,这个函数也是一个生成器
def split_into_sentences(text, max_bytes):
    for line in text.split("\n"):
        line = line.strip()
        if not line:
            continue
        if len(line.encode("utf-8")) <= max_bytes:
            yield line
            continue
        # 粗略按字符数硬切(UTF-8 中文最多 4 字节/字符)
        step = max(1, max_bytes // 4)
        for i in range(0, len(line), step):
            piece = line[i:i + step].strip() # 去掉前后空格
            if piece:                        # 如果是纯空白就不返回了
                yield piece


# SentencePiece 需要一个 sample.txt 作为输入,用这个函数制作我们的 sample.txt 文件
# 按照 Config 里的 sp_doc_stride 配置跳着取文本,散开点,避免只取到过于集中的 sample
# 如果取到的数据到达 Config 里的 sp_sample_chars 或是 sp_sample_sentences 则停止
# 此函数退出时,sample_path 中的 sample.txt 应该已经被写好
def build_tokenizer_sample(cfg, sample_path):
    names = list_jsonl_files(cfg.data_dir)
    iters = [iter_docs(os.path.join(cfg.data_dir, n), cfg.limit_docs_per_file) for n in names]
    stride = max(1, cfg.sp_doc_stride)
    seen = {n: 0 for n in range(len(names))}
    written = chars = 0
    next_report = 100_000_000
    t0 = time.time()
    with open(sample_path, "w", encoding="utf-8") as out:
        while iters and chars < cfg.sp_sample_chars and written < cfg.sp_sample_sentences:
            for idx, it in list(enumerate(iters)):
                try:
                    _, text = next(it)
                except StopIteration:
                    iters.remove(it)
                    continue
                seen[idx] += 1
                if seen[idx] % stride:  # 用求模散开采样,只有模到 0 才被采样
                    continue
                for sent in split_into_sentences(text, cfg.sp_max_sentence_bytes):
                    out.write(sent)
                    out.write("\n")
                    written += 1        # 总句子采样数计数
                    chars += len(sent)  # 总字符采样数计数
                if chars >= cfg.sp_sample_chars or written >= cfg.sp_sample_sentences:
                    break
            if chars >= next_report:
                next_report += 100_000_000
                log(f"  分词器采样:{fmt_count(chars)} 字符 / {fmt_count(written)} 句")
    log(f"  分词器采样完成:{fmt_count(chars)} 字符 / {fmt_count(written)} 句,"
        f"{os.path.getsize(sample_path) / 1e6:.0f} MB,耗时 {fmt_duration(time.time() - t0)}")
    return written

# 训练 BPE 分词器
def train_tokenizer(cfg):
    if os.path.exists(cfg.tokenizer_path):
        sp = spm.SentencePieceProcessor(model_file=cfg.tokenizer_path)
        log(f"复用已有分词器 {cfg.tokenizer_path}(vocab={sp.get_piece_size()})")
        return sp

    log("=" * 78)
    log("训练 SentencePiece BPE 分词器")
    log("=" * 78)
    sample_path = os.path.join(cfg.token_bin_dir, cfg.sample_filename)
    try:
        # 调上面的函数准备好 sample.txt 训练样本文件
        # 样本越大,需求的内存容量也越大
        # 我们的配置最好是在内存 16GB 以上的机器上训练
        build_tokenizer_sample(cfg, sample_path)
        prefix = cfg.tokenizer_path[:-len(".model")] if cfg.tokenizer_path.endswith(".model") \
            else cfg.tokenizer_path

        log(f"  开始训练 BPE(vocab_size={cfg.vocab_size}),这一步可能要几十分钟...")
        t0 = time.time()
        # 训练的事就交给 SentencePiece 了
        spm.SentencePieceTrainer.train(
            input=sample_path,  # 训练语料 sample.txt
            model_prefix=prefix,
            model_type=cfg.sp_model_type, # 训练 BPE 还是 Unigram 分词器, Unigram 是和 BPE 反着的
            vocab_size=cfg.vocab_size,  # 词表大小
            character_coverage=cfg.sp_character_coverage, # 要求的 BPE 的字符覆盖率
            byte_fallback=cfg.sp_byte_fallback,
            normalization_rule_name=cfg.sp_normalization,
            add_dummy_prefix=cfg.sp_add_dummy_prefix, # 每句开头自动加个特殊标记,让 BPE 学到词首概念
            remove_extra_whitespaces=cfg.sp_remove_extra_whitespaces,
            input_sentence_size=cfg.sp_sample_sentences,
            shuffle_input_sentence=True,
            max_sentence_length=cfg.sp_max_sentence_bytes,  # 超过此字节长度的句子被丢弃
            num_threads=cfg.sp_num_threads, # 训练并行线程数
            unk_id=cfg.sp_unk_id, # 手动指定特殊 token 的 token ID,-1 表示不放进词表
            bos_id=cfg.sp_bos_id, # 手动指定的目的是让自己知道这些特殊的 token ID,未来能和预训练代码保持一致
            eos_id=cfg.sp_eos_id,
            pad_id=cfg.sp_pad_id,
            train_extremely_large_corpus=False,
        )
        log(f"  分词器训练完成,耗时 {fmt_duration(time.time() - t0)} -> {cfg.tokenizer_path}")
    finally:
        if os.path.exists(sample_path):
            os.remove(sample_path)
    gc.collect()

    # 返回训练好的 BPE 实例,为后面预分词做准备
    return spm.SentencePieceProcessor(model_file=cfg.tokenizer_path)
训练的主要代码其实都是 SentencePiece 在做,我们做的主要工作是给它把训练样本准备好。
代码中唯一值得注意的是我们在指定分词器类型时有 BPE 和 Unigram 两个选择可选。我们都知道 BPE 是不断地将经常挨在一起的频率最高的词对放进词表,它的词表在训练时是一个不断由小变大的过程。 Unigram 是一个与它相反的思路,先搞一出无敌大的词表,比如说 100 万词的词表,保证它囊括了大部分有价值的词,然后再一步步把那些概率偏小的词去除掉,最终达成我们对词表大小的要求。 Unigram 的词表在训练时是一个不断由大变小的过程。目前, DeepSeek V4.1、Qwen 3.8 和 GLM-5.3 都是使用的基于 BPE 的分词方法,所以我们也选 BPE。
7.5.3.4 预分词
接下来,就如之前我们计划的,我们要把我们的数据集都预先分词放好,并且合并成一个一个 128MB 的 bin 文件分片,方便未来搬到 ramdisk 上去。做完这一步,我们后面就不再需要原始的数据集了。
这段代码比较长,我们在代码里注释地稍微详细一些。
# =============================================================================
#                    阶段二:语料 -> uint16 token 分片(增量)
# =============================================================================


# 把 token 流按固定字节数切成 uint16 的 .bin 分片
# 输入是:我们的数据集
# 输出是:一大堆名为 "val_00001.bin" "train_00001.bin" 的预分词好的文件

class ShardWriter:

    # 初始化配置项
    def __init__(self, out_dir, tag, start_index, shard_bytes):
        self.out_dir = out_dir          # 输出目录
        self.tag = tag                  # 文件分片前缀:"train" 或 "val"
        self.index = start_index        # 开始的文件序号 ,"train_00001.bin" 后面的 00001
        self.shard_bytes = shard_bytes  # 每个分片 bin 文件的目标字节数,我们会设为 128M
        self.buf = array.array("H")     # array.array 是 python 里的紧凑 C 数组,比 list[int] 省内存,我们用它来做内存缓冲,'H' 是指无符号 2 字节整数(uint16)
        self.max_tokens = shard_bytes   # 每个分片 bin 文件的 token 数 = shard_bytes / 2(uint16 每个 2 字节)
        self.shards = []                # 做出来的文件分片,内容应形如:[(filename, n_tokens), ...]
        self.total_tokens = 0           # 累计写入的 token 数

    # 持续写入 token 到 buf 里,写够 128M 了就用 self._flush 落盘
    def add(self, ids):
        self.buf.extend(ids)
        self.total_tokens += len(ids)
        while len(self.buf) >= self.max_tokens:
            self._flush(self.max_tokens)

    # 落盘函数
    # 1. 拼出文件名
    # 2. 写到文件里,
    # 3. 把已经写入的这些从 buf 里删掉
    def _flush(self, n):
        if n <= 0:
            return
        name = f"{self.tag}_{self.index:05d}.bin"
        path = os.path.join(self.out_dir, name)
        chunk = self.buf[:n]
        with open(path, "wb") as f:
            chunk.tofile(f)
        self.shards.append([name, n])
        self.index += 1
        del self.buf[:n]

    # 一个数据集文件读结束了,最后没凑够 128M 的一些 token 也落盘
    def close(self):
        self._flush(len(self.buf))

    # 取走并清空自上次以来新产生的分片列表
    # 交换引用:返回旧列表,self 换成空列表 []
    # 在折腾完 train,换成搞 val 的时候用这个函数,等于是重置了当前实例
    def take_shards(self):
        s, self.shards = self.shards, []
        return s

# 预分词结束会输出一个 manifest.json 文件
# 如果这次启动的是之前中断的任务,把之前的 manifest.json 读进来
def load_manifest(cfg):
    path = os.path.join(cfg.token_bin_dir, "manifest.json")
    if os.path.exists(path):
        with open(path, "r", encoding="utf-8") as f:
            m = json.load(f)
        if m.get("vocab_size") != cfg.vocab_size or m.get("block_size_hint") != cfg.block_size:
            log(f"manifest 的 vocab_size/block_size 与当前 Config 不一致,"
                f"如果换了分词器请删除 {cfg.token_bin_dir} 后重跑")
        return m
    return {
        "vocab_size": cfg.vocab_size,
        "block_size_hint": cfg.block_size,
        "sources": {},                      # 数据形如: {文件名: {size, mtime, docs}}
        "train_shards": [],                 # 数据形如: [[文件名, token数], ...]
        "val_shards": [],                   # 同上
        "train_next_index": 0,              # 下一个 train 分片编号(续跑接续)
        "val_next_index": 0,                # 同上
        "val_tokens": 0,                    # 验证集已写入 token 总数
    }

# 负责写入 manifest.json 文件的函数
# 用 replace 保证写入的原子性
def save_manifest(cfg, manifest):
    path = os.path.join(cfg.token_bin_dir, "manifest.json")
    tmp = path + ".tmp"
    with open(tmp, "w", encoding="utf-8") as f:
        json.dump(manifest, f, ensure_ascii=False, indent=1)
    os.replace(tmp, path)

# 有做了一半的 bin 文件,没被记录到 manifest.json 文件里
# 把这些 bin 文件删除掉
def remove_orphan_shards(cfg, manifest):
    known = {s[0] for s in manifest["train_shards"]} | {s[0] for s in manifest["val_shards"]}
    removed = 0
    for name in os.listdir(cfg.token_bin_dir):
        if name.endswith(".bin") and name not in known:
            try:
                os.remove(os.path.join(cfg.token_bin_dir, name))
                removed += 1
            except OSError:
                pass
    if removed:
        log(f"  清理了 {removed} 个上次中断残留的孤儿分片")

# 从生成器里拿出 n 项出来返回
# 简化生成器的使用
# 兼顾生成器形式的性能,和数组形式的编写方便
def batched(iterable, n):
    batch = []
    for item in iterable:
        batch.append(item)
        if len(batch) >= n:
            yield batch
            batch = []
    if batch:
        yield batch

# 启动多个进程来完成分词的工作
# 用 python 的 import multiprocessing as mp 来 fork 多进程
# 实际分出多进程的是这一句 ctx = mp.get_context("fork"),会继承进程信息,仅用于 Linux 平台,
# 子进程会 CoW 父进程的堆栈、代码段和数据段。如果 CUDA 在 fork 之前初始化,会造成 1 个初始化句柄被多个进程持有的问题,所以需要手动处理 CUDA 初始化需要在 fork 之后
# 对 mac / windows 还是应该使用 spawn,spawn 不会继承,就简单点,但也稍微慢点

# 多进程的子例程
_SP_WORKER = None
_SP_EOS = 2
_SP_MODULO = 1000

# 子进程初始化,主要是实例化 SentencePieceProcessor
def _tok_worker_init(model_path, eos_id, modulo):
    global _SP_WORKER, _SP_EOS, _SP_MODULO
    _SP_WORKER = spm.SentencePieceProcessor(model_file=model_path) # 因为已经 fork 了,这个变量看似全局,实则私有
    _SP_EOS, _SP_MODULO = eos_id, modulo

# 子进程的主要工作:对文本做分词
# 输入是: batch: [(doc_id, text), ...]
# 输出是: [(is_val, ids+eos), ...]
def _tok_worker(batch):
    # 调用训练好的 SentencePiece BPE 来批量分词
    encoded = _SP_WORKER.encode([t for _, t in batch], out_type=int)
    out = []
    for (doc_id, text), ids in zip(batch, encoded):
        ids.append(_SP_EOS)
        # 组装我们需要的输出格式
        out.append((is_val_doc(doc_id, text, _SP_MODULO), ids))
    return out

# 分词的主函数
# 读入 jsonl,写出 bin,并且返回 manifest.json
def build_token_bin(cfg):

    # 第一次执行这个函数时,是直接新建配置
    # 只有断点重开才是真的 load
    manifest = load_manifest(cfg)

    # 循环拿到所有文件名,放到 todo 数组
    names = list_jsonl_files(cfg.data_dir)
    todo = []
    for name in names:
        p = os.path.join(cfg.data_dir, name)
        st = os.stat(p)
        rec = manifest["sources"].get(name)
        if rec and rec["size"] == st.st_size and abs(rec["mtime"] - st.st_mtime) < 1e-6:
            continue
        todo.append((name, p, st))

    if not todo:
        log(f"复用已有 token 分片:train {len(manifest['train_shards'])} 片 / "
            f"{fmt_count(sum(s[1] for s in manifest['train_shards']))} tokens,"
            f"val {fmt_count(manifest['val_tokens'])} tokens")
        return manifest

    log("=" * 78)
    log(f"分词 {len(todo)} 个新的 jsonl 文件 -> uint16 token 分片")
    log("=" * 78)

    # 清掉上次异常中断留下的、没被 manifest 记录的孤儿分片
    remove_orphan_shards(cfg, manifest)

    # 准备好分片的 Writer,后面就直接给它塞 token ID 流就行,写文件的事就交给这两个 Writer
    train_w = ShardWriter(cfg.token_bin_dir, "train", manifest["train_next_index"], cfg.shard_bytes)
    val_w = ShardWriter(cfg.token_bin_dir, "val", manifest["val_next_index"], cfg.shard_bytes)
    val_tokens = manifest["val_tokens"]

    # 确保 fork 之前 CUDA 是未初始化状态,不对就退出,免得后面出奇怪问题不好查
    assert not torch.cuda.is_initialized(), "分词的多进程 fork 必须发生在 CUDA 初始化之前"

    # 准备开始 fork
    ctx = mp.get_context("fork")
    t_start = time.time()
    n_docs = 0

    # 实际 fork 出 tokenize_processes 个子进程来干活
    # 执行子进程初始化函数 _tok_worker_init 把分词器都加载准备好
    with ctx.Pool(cfg.tokenize_processes, initializer=_tok_worker_init,
                  initargs=(cfg.tokenizer_path, cfg.sp_eos_id, cfg.val_doc_modulo)) as pool:
        # 一个文件一个文件处理,只在每个文件内部使用多进程
        for name, path, st in todo:
            log(f"  处理 {name} ({st.st_size / 1e9:.2f} GB)…")
            t_file = time.time()
            docs = iter_docs(path, cfg.limit_docs_per_file)
            file_docs = 0
            next_report = 100_000

            # 把每个文件分成 tokenize_super_batch 批依次处理
            # tokenize_super_batch 中再分出每批 tokenize_batch_docs 个条目给每个子进程去处理
            for super_batch in batched(batched(docs, cfg.tokenize_batch_docs),
                                       cfg.tokenize_super_batch):
                # 这里面的代码都只在子进程中执行
                # map 会把 tokenize_super_batch 中的 tokenize_batch_docs 取出来分给每个子进程
                # 子进程会执行 _tok_worker 完成分词
                for result in pool.map(_tok_worker, super_batch):
                    # 这里面处理子进程的返回值,此时它已经完成分词任务了
                    # 子任务返回了形如 [(is_val, ids+eos), ...] 的数据
                    # 我们只需要把它分出来的 token ID 流喂到 Writer 里,让 Writer 自动完成攒满落盘的工作
                    for is_val, ids in result:
                        if is_val and val_tokens < cfg.max_val_tokens:
                            val_w.add(ids)
                            val_tokens += len(ids)
                        else:
                            train_w.add(ids)
                        file_docs += 1

                # 每处理 next_report 个条目就打印一下日志
                if file_docs >= next_report:
                    next_report += 100_000
                    rate = file_docs / max(1e-6, time.time() - t_file)
                    log(f"    {fmt_count(file_docs)} 篇文档 | "
                        f"{fmt_count(train_w.total_tokens)} train tokens | "
                        f"{rate:.0f} 篇/s")

            # 每处理完一个源文件就把缓冲落盘并保存 manifest,用途是可以断点续上之前的工作
            train_w.close()
            val_w.close()
            manifest["train_shards"].extend(train_w.take_shards())
            manifest["val_shards"].extend(val_w.take_shards())
            manifest["train_next_index"] = train_w.index
            manifest["val_next_index"] = val_w.index
            manifest["val_tokens"] = val_tokens
            manifest["sources"][name] = {"size": st.st_size, "mtime": st.st_mtime,
                                         "docs": file_docs}
            save_manifest(cfg, manifest)

            n_docs += file_docs
            log(f"  {name} 完成:{fmt_count(file_docs)} 篇,"
                f"耗时 {fmt_duration(time.time() - t_file)}")
            gc.collect()

    # 打印总结日志
    total_train = sum(s[1] for s in manifest["train_shards"])
    log(f"完成预分词:{fmt_count(n_docs)} 篇文档 -> "
        f"train {fmt_count(total_train)} tokens ({len(manifest['train_shards'])} 片) + "
        f"val {fmt_count(val_tokens)} tokens,总耗时 {fmt_duration(time.time() - t_start)}")
    gc.collect()
    return manifest
这样,我们就完成了从磁盘读取数据集,然后训练 BPE,然后预分词,然后攒堆落盘的所有函数。
然后我们写一个分词的入口,让分词工作跑起来。
7.5.3.4 分词的入口函数
入口函数就比较简单了,就是一个 python 的 main。我们确认一下词表大小小于 65536,别到时候 Token ID 用 uint16 装不下就行。
如果没问题,就新建一个存放 bin 文件的目录,然后训练分词器,最后让我们的多进程分词函数开始工作就好。
def main():
    cfg = Config
    t_start = time.time()

    log("Begin BPE Training...")

    assert cfg.vocab_size <= 65536, "vocab_size 必须 <= 65536,token 才能用 uint16 存储"
    os.makedirs(os.path.realpath(cfg.token_bin_dir), exist_ok=True)

    train_tokenizer(cfg)
    manifest = build_token_bin(cfg)

    if not manifest["train_shards"]:
        raise RuntimeError("没有生成任何训练分片")

    log(f"总耗时 {fmt_duration(time.time() - t_start)}")


if __name__ == "__main__":
    main()
执行以上函数,我们能看到大概是以下的输出。
[01:41:28] Begin BPE Training...
[01:41:28] ==============================================================================
[01:41:28] 训练 SentencePiece BPE 分词器
[01:41:28] ==============================================================================
[01:41:38]   分词器采样:100.09M 字符 / 1.12M 句
[01:41:47]   分词器采样:200.46M 字符 / 2.23M 句
[01:41:56]   分词器采样:300.24M 字符 / 3.30M 句
[01:42:06]   分词器采样:400.47M 字符 / 4.40M 句
[01:42:15]   分词器采样:500.26M 字符 / 5.51M 句
[01:42:24]   分词器采样:600.11M 字符 / 6.63M 句
[01:42:33]   分词器采样:700.38M 字符 / 7.74M 句
[01:42:42]   分词器采样:800.49M 字符 / 8.87M 句
[01:42:51]   分词器采样:900.43M 字符 / 10.00M 句
[01:43:00]   分词器采样:1.00B 字符 / 11.13M 句
[01:43:10]   分词器采样:1.10B 字符 / 12.28M 句
[01:43:19]   分词器采样:1.20B 字符 / 13.41M 句
[01:43:28]   分词器采样:1.30B 字符 / 14.55M 句
[01:43:37]   分词器采样:1.40B 字符 / 15.69M 句
[01:43:46]   分词器采样:1.50B 字符 / 16.80M 句
[01:43:56]   分词器采样:1.60B 字符 / 17.94M 句
[01:44:05]   分词器采样:1.70B 字符 / 19.07M 句
[01:44:14]   分词器采样:1.80B 字符 / 20.21M 句
[01:44:23]   分词器采样:1.90B 字符 / 21.34M 句
[01:44:32]   分词器采样:2.00B 字符 / 22.47M 句
[01:44:41]   分词器采样:2.10B 字符 / 23.58M 句
[01:44:50]   分词器采样:2.20B 字符 / 24.68M 句
[01:44:59]   分词器采样:2.30B 字符 / 25.80M 句
[01:45:08]   分词器采样:2.40B 字符 / 26.92M 句
[01:45:17]   分词器采样:2.50B 字符 / 28.05M 句
[01:45:26]   分词器采样:2.60B 字符 / 29.18M 句
[01:45:35]   分词器采样:2.70B 字符 / 30.30M 句
[01:45:44]   分词器采样:2.80B 字符 / 31.39M 句
[01:45:52]   分词器采样:2.90B 字符 / 32.49M 句
[01:46:01]   分词器采样:3.00B 字符 / 33.58M 句
[01:46:01]   分词器采样完成:3.00B 字符 / 33.58M 句,8213 MB,耗时 4m32s
[01:46:01]   开始训练 BPE(vocab_size=64000),这一步可能要几十分钟...
WARNING: All log messages before absl::InitializeLog() is called are written to STDERR
I0000 00:00:1789580761.905744    1982 sentencepiece_trainer.cc:105] Starts training with :
trainer_spec {
  input: ./token_bins/sp_sample.txt
  input_format:
  model_prefix: ./tokenizer
  model_type: BPE
  vocab_size: 64000
  self_test_sample_size: 0
  character_coverage: 0.9995
  input_sentence_size: 900000000
  shuffle_input_sentence: 1
  seed_sentencepiece_size: 1000000
  shrinking_factor: 0.75
  max_sentence_length: 8192
  num_threads: 22
  num_sub_iterations: 2
  max_sentencepiece_length: 16
  split_by_unicode_script: 1
  split_by_number: 1
  split_by_whitespace: 1
  split_digits: 0
  pretokenization_delimiter:
  treat_whitespace_as_suffix: 0
  allow_whitespace_only_pieces: 0
  required_chars:
  byte_fallback: 1
  vocabulary_output_piece_score: 1
  train_extremely_large_corpus: 0
  seed_sentencepieces_file:
  hard_vocab_limit: 1
  use_all_vocab: 0
  unk_id: 0
  bos_id: 1
  eos_id: 2
  pad_id: 3
  unk_piece: <unk>
  bos_piece: <s>
  eos_piece: </s>
  pad_piece: <pad>
  unk_surface:  ⁇
  enable_differential_privacy: 0
  differential_privacy_noise_level: 0
  differential_privacy_clipping_threshold: 0
}
normalizer_spec {
  name: identity
  add_dummy_prefix: 0
  remove_extra_whitespaces: 0
  escape_whitespaces: 1
  normalization_rule_tsv:
}
denormalizer_spec {}
I0000 00:00:1789580761.905809    1982 trainer_interface.cc:364] SentenceIterator is not specified. Using MultiFileSentenceIterator.
I0000 00:00:1789580761.905838    1982 trainer_interface.cc:193] Loading corpus: ./token_bins/sp_sample.txt
I0000 00:00:1789580762.296601    1982 trainer_interface.cc:155] Loaded 1000000 lines
I0000 00:00:1789580762.426418    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: ▅要设法消除患者的心理创伤,以“要言妙道”的方式加以疏导,指导患者接受现实,积极行动去获得成功和喜悦。
I0000 00:00:1789580762.426440    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: ▅正确对待自己的性格缺陷,要加 强对患者意志品质的训练,注意培养开阔的心胸和脚踏实地的精神。
I0000 00:00:1789580762.426442    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: ▅要注意缓解紧张情绪,为患者创 造一个舒适、轻松的环境,紧张情绪是酝酿癔症的温床。
I0000 00:00:1789580762.426447    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: ▅要正确对待癔症患者,癔症并无 神经系统的器质性病变,一旦诱因消失,患者会霍然而愈。
I0000 00:00:1789580762.715337    1982 trainer_interface.cc:155] Loaded 2000000 lines
I0000 00:00:1789580763.142698    1982 trainer_interface.cc:155] Loaded 3000000 lines
I0000 00:00:1789580763.505065    1982 trainer_interface.cc:155] Loaded 4000000 lines
I0000 00:00:1789580763.689525    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: 胎心监护是胎心胎动宫缩图的简 称,是应用胎心率电子监护仪将胎心率曲线和宫缩压力波形记下来供临床分析的图形,是正确评估胎儿宫内的状况的主要检测手段.采用微波技术,对小孩胎心监护是胎心胎动宫缩图的简称,是应用胎心率电子监护仪将胎心率曲线和宫缩压力波形记下来供临床分析的图形,是正确评估胎儿宫内的状况的主要检测手段.采用微波技术,对小孩没有危害,只需要买胎心检测仪即可。尤其是怀孕4月个以后,自己对baby监护很重要。有趣的事有时还能 够听到baby的打嗝声。胎心监护检查是利用超声波的原理对胎儿在宫内的情况进行监测,对胎儿是安全的。目录胎心监护概述胎心监护检查的内容 胎心监护怎么看胎心异常的表现及原因安全性胎心监护的方法如何听胎心数胎动胎心监护胎心监护是由韩国bistos生产的国际知名品牌。韩国bistos是生物信号全面解决方案(bio signal total sol tion)的缩写。长期专注于研究、发展、制造超声和光学领域的医疗设备。高新科技的应用以 及符合人机工程学的设计,不仅使得产品造型优美,更为您提供可靠的品质。我们坚持不懈地基于最前沿的新技术研发、升级医疗设备,提供给韩国 本土市场并在国际市场上取得了良好的成绩。并承诺致力于为您提供最高的产品品质和最优秀的服务!  ▅ 高灵敏度的双通道2mhz 7-晶体宽波束脉冲波超声探头,可以获得更大的聚焦区,在更大的深度实现更加均匀的覆盖 ▅ 采用稳定可靠的全数字方式采集信号,可以及早发现妊娠初期的胎心率,一直到分娩,无论孕妇何种状况,甚至肥胖,均可轻松检测  ▅ 专利的高速微处理器,先进的实时自动校正胎心率处理技术,脉冲波自相关和过零检测算法,为您提供精确检测结果 ▅ 3.2英寸彩色大屏幕lcd液晶显示,极大程度地方便您的观察 万能爸爸,wnbaba.com ▅ 一键式操作操作简单,您所需 要的功能只需一次按键即可实现,给您更多的时间进行床旁照顾 ▅ 采用防水探头,可监测水下分娩  ▅ 独特的探头防滑设计和探头保护装置,让您避免探头损坏放心使用  ▅ 主动降噪,高保真音质,提供清晰洪亮的胎心音,音量大小可调 ▅ 宽范围胎心率检测 ▅ 坚固、时尚、轻便,内置隐藏式提手方便携带,重量仅为1.5千克 ▅ 充电安全具备完善的充电电路控制、过温控制和过流保护功能 ▅ 内置可充电镍氢电池组,连续工作长达5小时  ▅ 整机低功耗设计,独特电源管理和自动切断技术,可选自动关机时间,保护电池寿命 强大的专业品质让您从容应对一目了然 ▅ 标准配备事件标记功能,便于轻松注解胎动和其他临床事件,让您的工作更加专业 ▅ 轻松切换:专业的多人次胎心记录图表显示、清晰的胎心率曲线和超大直观的数字显示 模式 ▅ 胎心率信号动态显示,信号质量提示,形象直观 ▅ 内存记忆功能,有长达4个小时的胎心数据保存时间,实时或者往复重放胎心率曲线 ▅ 作为网络系统的独立单元,升级通过蓝牙或者电缆线连接组成中央站工作系统 ▅ 通过了美国fda和欧盟的ce认证概述 胎心监护是胎心胎动宫缩图的简称,是应用胎心率电子监护仪将胎心率曲线和宫缩压力波形记下来供临床分析的图形,是正确评估胎儿宫内的状况的主要检测手段.采用微波技术,对小孩没有危害,只需要买胎心检测仪即可。尤其是怀孕4月个以后,自己对baby监护很重要。有趣的事有时还能够听到baby的打嗝声。胎心监护上主要 是两条线,上面一条是胎心率,正常情况下波动在120-160之间,一般基础心率线表现为一条波形直线,出现胎动时心率会上升,出现一个向上突起的曲线,胎动结束后会慢慢下降,胎动计数30次12小时为正常,10次每12小时提示胎儿缺氧。 下面一条表示宫内压力,只要在宫缩时会增高,随后会保持20mmhg左右。胎心监护检查的内容 胎心监护胎儿心率受交感神经和副交感神经调节,通过信号描记瞬间的胎心变化所形成的监护图形的曲线,可以了 解胎动时、宫缩时胎心的反应,以推测宫内胎儿有无缺氧。正常妊娠从怀孕第37周开始每周做一次胎心监护,如有合并症或并发症,可以从怀孕第28~30周开始做。应注意胎心音的节律性是否忽快忽慢等,正常胎心音120~160次分,如果胎心音160次分以上或持续100次分都表示胎儿宫内缺氧,应及时治疗。胎心监护怎么看 胎心监护上主要是两条线,上面一条是胎心率,正常情况下波动在120-160之间,一般表现为基础心率线表现为一条波形直线,出现胎动时心率会上升,出现一个向上突起的曲线,胎动结束后会慢慢下降,胎动计数30次24小时为正常,10次每12小时提示胎儿缺氧。 下面一条表 示宫内压力,只要在子缩时会增高,随后会保持20mmhg左右。胎心异常的表现及原因 胎儿正常的心率是在120次分~160次分之间,若胎心率持续10分 钟以上都120分或160分,表明胎心率是异常的。目前胎心监护仪应用已较为普及,在胎心临护时,发现有胎心图形有异常,也常常用来表示胎心异常。胎心异常多数情况下是代表胎儿在宫内有缺氧,
I0000 00:00:1789580763.911255    1982 trainer_interface.cc:155] Loaded 5000000 lines
I0000 00:00:1789580764.213156    1982 trainer_interface.cc:155] Loaded 6000000 lines
I0000 00:00:1789580764.255248    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: 纠正"震卦反装"等谬误 张德 前 些年,易界流行着一种"纳支新说",曾经风靡一时,其大意是- 自从京房创造纳甲法以来,纳甲筮法就成了周易预测的大宗之法,并沿袭至今。无任是 古代大贤,还是当今圣手,都在使用。然而,大家不知是否注意到这个问题:即"乾"与"震"的纳支是一样的!不知千百年来,是否有人怀疑过?我认为这 可能是一个错误,不过这可能是别人传抄错误,因为谁也没有见过京房的手迹。而我认为正确的应该是这样: 震宫:震为雷(六冲) ▅▅ ▅▅ 辰土 世 ▅▅ ▅▅ 寅木 ▅▅▅▅▅ 子水 ▅▅ ▅▅ 戌土 应 ▅▅ ▅▅ 申金 ▅▅▅▅▅ 午火 依据是:八卦中,阳卦为:乾、坎、艮、震,其纳支为阳,初爻纳支分别为子、寅、辰 、?;阴卦为:巽、离、坤、兑,纳支为阴,初爻纳支分别为:丑、卯、未、巳,前四对地支中独缺"午"字,而此"午"正是震卦的起始纳支。 另外,按照太极图的方向,"坤"卦和"兑"卦的纳支也可能是错的,它们颠倒了,可能应该为: 坤宫:坤为地(六冲) ▅▅ ▅▅ 未土 世 ▅▅ ▅▅ 酉金 ▅▅ ▅▅ 亥水 ▅▅ ▅▅  丑土 应 ▅▅ ▅▅ 卯木 ▅▅ ▅▅ 巳火 兑宫:兑为泽(六冲) ▅▅ ▅▅ 酉金 世 ▅▅▅▅▅ 亥水 ▅▅▅▅▅ 丑土 ▅▅ ▅▅ 卯木 应 ▅▅▅▅▅ 巳火 ▅▅▅▅▅ 未土 如果这样,那么,按照太极图的方向,阳卦顺序为:乾、坎、艮、震,其纳支为阳,初爻纳支依次分别为子、寅、辰、午;阴卦顺序为:巽、离、坤、兑,纳支为阴,初爻纳支分别为:丑、卯、未、巳,分别为十二地支的前四阳支和前四阴支,这就符合排列规律,才顺理成章。 以上观点,希望大家热烈批判。 (也许根本就没有正确的,即纳甲的排列都是错的,京房为什么这样排?根据是什么?) 以上就是该"纳支新说"的大意。 那段时期,正值六爻界兵分多路,力 图从各个渠道发掘、改善传统方法。看到该"纳支新说",开始时张德也觉得很震撼,然后专门花时间深入其间,查找相关资料...终于在田合禄著《周易真原-中国最古老的天学科学体系》和卢央著《京氏易传解读》中找到了答案- 京房以天文历法为理论依据建构了涵括日月星辰、四象五行、天 地阴阳、纳甲、纳支、建候、积算、气候分数在内的庞大有序的宇宙模式图,以其推天道讲人事,合天人于一体。 现今的六爻术是由火珠林发展而 来的。火珠林是一种易卦占法,其特点是以钱代蓍,占法取京氏纳支法。 京房纳支说遵循的原则是《说卦传》乾坤父母生六子法。卢央在《京氏易 传解读》一书中认为,每一对夫妻阴阳卦六爻的排列是根据历法及生律纳入的。其实这种隔八生律法及音律应支法乃是源于日月地运动规律、是有 天文背景的,并非空穴来风。 京房纳甲说,其理论依据是月体纳甲图。而月体纳甲图亦源于日月地运动规律,同样有其天文背景。 京房纳支说缘自 音律,其天文和人伦根据是- 1、阳气自下生,故阳卦纳阳支,自下而上顺行: (1)、乾天知大始,故初爻纳子,自下而上,上爻纳戌。 (2)、震得乾之初,故初爻纳子,自下而上,上爻纳戌。 (3)、坎得乾之中,故初爻纳寅,自下而上,上爻纳子。 (4)、艮得乾之上,故初爻纳辰,自下而上,上爻纳寅。 2 、阴气自上生,故阴卦纳阴支,自上而下逆行: (1)动于天之下,则应于地之下;动于天之中,则应于地之中;动于天之下,则应于地之下。故坤之四爻纳丑合于乾之初爻子;五爻纳亥合于乾之二爻寅,依次类推。 (2)、兑得坤之初,故上爻纳未,自上而下,初爻纳巳。 (3)、离得坤之中,故上爻纳巳,自 上而下,初爻纳卯。 (4)、巽得坤之上,故上爻纳卯,自上而下,初爻纳丑。 长子主器,秉承父性,故乾健而震动。巽为长女,秉承母性,故坤顺而巽入 。阴阳正配的四组卦中,只有震巽六爻相对而合,故《雷风恒》讲夫妇之道,伦之始也。 至于纳干则是根据月象,完全从人伦角度不能说明问题。 详细答案尽在田合禄著《周易真原》和卢央著《京氏易传解读》中,此处不再赘述。 再者,六爻扫描、模拟客观现实,正因乾震二卦纳支相同,所以才 有了"伏吟",才反映出了现实生活中"想动不能动、动如不动、犹豫不决、徘徊不前、原地踏步、原地打转、兜圈子、痛苦忧虑呻吟、欲言又止、结结巴巴、罗罗嗦嗦、婆婆妈妈"等现象。 "五岳归来不看山"。谈到"太极图的方向",只要看过田合禄著《周易真原》中"原始实测太极图"一文,就会觉得提出"纳支新说"这位学者的认识还很肤浅。 各种凿空之论、谬悠之说可以息矣!
I0000 00:00:1789580764.515707    1982 trainer_interface.cc:155] Loaded 7000000 lines
I0000 00:00:1789580764.628150    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: <end>地磁传感器可用于检测车辆的け存在和车型识别。利用车辆通过道路时对地球磁场的影响来完成车辆检测的传感器与目前常用的地磁线圈(又称地感线圈)检测器相比な,具有安装尺寸小、灵を敏度高、施工量小、使用寿命长,对路面的破坏小(有线安装只需要在路面▅开一条5毫米宽的缝,无线安装只需要在路面打一个直径55 毫米深150毫米的男洞,当在检测点吊架或侧面安装时不用破坏路面)等优点,在智能交通系统的信息采集中べ必将起到非常重要的∷作 用。
I0000 00:00:1789580764.819973    1982 trainer_interface.cc:155] Loaded 8000000 lines
I0000 00:00:1789580765.286244    1982 trainer_interface.cc:155] Loaded 9000000 lines
I0000 00:00:1789580765.587805    1982 trainer_interface.cc:155] Loaded 10000000 lines
I0000 00:00:1789580765.886297    1982 trainer_interface.cc:155] Loaded 11000000 lines
I0000 00:00:1789580766.193735    1982 trainer_interface.cc:155] Loaded 12000000 lines
I0000 00:00:1789580766.501027    1982 trainer_interface.cc:155] Loaded 13000000 lines
I0000 00:00:1789580766.813586    1982 trainer_interface.cc:155] Loaded 14000000 lines
I0000 00:00:1789580767.120380    1982 trainer_interface.cc:155] Loaded 15000000 lines
I0000 00:00:1789580767.425275    1982 trainer_interface.cc:155] Loaded 16000000 lines
I0000 00:00:1789580768.073763    1982 trainer_interface.cc:155] Loaded 17000000 lines
I0000 00:00:1789580768.385571    1982 trainer_interface.cc:155] Loaded 18000000 lines
I0000 00:00:1789580768.598033    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: ▅
I0000 00:00:1789580768.598052    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: ▅
I0000 00:00:1789580768.691407    1982 trainer_interface.cc:155] Loaded 19000000 lines
I0000 00:00:1789580768.961740    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: ▅▅▅▅▅
I0000 00:00:1789580768.961760    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: ▅▅▅▅
I0000 00:00:1789580768.995848    1982 trainer_interface.cc:155] Loaded 20000000 lines
I0000 00:00:1789580769.298559    1982 trainer_interface.cc:155] Loaded 21000000 lines
I0000 00:00:1789580769.425896    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: 尚氏考《易林》,得西汉失传众多逸象,而与《周易》经文直接有关的就有一百七十余象。 现根据《焦氏易林注》所记,逐一辨析,去除可疑,归纳其要,以期同《说卦》合并为可指导今人的实用参考。 -原文: 乾逸象 为日、《乾》九三"君子终日乾乾。" 《彖》"大明终始",大明即日。《晋》彖传"顺而丽乎大明",是。 河海、 《同人》"利涉大川。" 山陵、《同人》"升其高陵。" 石、《说卦》"乾为玉。" 南、《同人》荀注:"乾舍于离,相与同居。" 虎、《文言》"风从 虎","履虎尾。" 大川、见《同人》。 -不二禅评:"日"、"南方",皆《离》象,《乾》健类《离》; "虎"威猛类龙;"石"之坚类《说卦》金玉、寒冰,当信之。 怀疑《乾》山、河之象。查《焦氏易诂》,仅为解《同人》卦辞"利涉大川"、九三辞"升其高陵"而断有本象,似甚牵强。 天火同人 ▅▅▅▅▅ ▅▅▅▅▅ ▅▅▅▅▅ ▅▅▅▅▅ ▅▅ ▅▅ ▅▅▅▅▅ 《同人》卦上《巽》下半《坎》,舟在水中,乘风而行,所以"利涉大川。" 九三"升其高陵" ,因处《艮》变象之 巅。 无《乾》象山、河之理。 -原文: 坤逸象 为水、《益》"利涉大川。" 江淮河海、鱼、《剥》"贯鱼。" 蛇、上《系》"龙蛇之蛰。" 渊、《 讼彖传》"入于渊。" 云、《小过》"密云不雨。" 墟、《升》"虚邑。" 茅茹、《否》"拔茅连茹。" 逆、坤逆行。《乾凿度》"坤右行,阴时六。" 北、先天。 心、《益》九五"有孚惠心。" 志、《益》九五"大得志。" 忧、《泰》九三"勿恤。" 《升彖》"勿恤。" 疾病、《复》"出入无疾",《损》六四"损其疾。" 毒、《师》"以此毒天下。" 劳、坤役天下,故劳。 风、《文言》"风从虎。"《内经》谓"风,士气所生。" 野、龙战于野。  郊、《小畜》"自我西郊。"郊用伏坤。 原、《比》"原筮,元永贞。" -不二禅评: 这里计有:水、江淮河海、鱼、蛇、渊、云、墟、茅茹、逆、北 、心、志、忧、疾病、毒、劳、风、野、郊、原等逸象。可归纳为三类: 一、类《坎》象。北方、水、江淮河海、渊,以及可关联的云、鱼、蛇。 蛇还有曲折、柔顺、阴险等《坎》意。 二、患之象。心、志、忧、疾病、毒、劳、逆,缘于《坤》多承受苦难而隐忍不发。 三、荒地、田园之象 。此为《坤》地的延伸,野、郊、原即是。"墟",趋于平地。关联荒原的还有:茅茹、风。 "茅茹"、"风"两者还有柔顺而乱之象,《易林》《屯》之 《坤》辞曰"采薪得麟",可见《坤》还有"薪"象,其理同"茅茹"。 最值得审视的是"风",其引《内经》考证似有些不类。《易·乾》:"同声相应,同气相求。水流湿,火就燥。云从龙,风从虎。圣人作而万物睹。"后因以"风从虎,云从龙"比喻事物之间的相互感应,既然"龙","虎"为《乾》象,"云"为 《坤》象,则"风"为《坤》,也是可信的。 风在《说卦》为《巽》之象,《坤》有曲柔伸展,漂游不定的特点,这与《巽》风同,水、鱼、茅茹、甚至 忧、病都有此方面特点。 另外,"云从龙,风从虎",依次解释为《坤》《乾》《巽》《震》四卦,似也通。本象非取自卦辞而是《文言》,有道理,可 参考,不足信。 "原"象也是需要注意的。 此象出于《比》"原筮,元永贞。" 尚秉和:"原筮,犹言野筮也。《仪礼·士丧礼》筮于兆域,兆域在郊外, 即原筮也。" 如此解释"原"为原野,当然为《坤》象。 但"原筮"之"原",历代颇有争议: 干宝以"原筮"为卜筮:"原,卜也。《周礼》三卜,一曰原兆...";苏轼则认为:"原,再也。再筮,慎之至也。" 朱熹亦谓:"再筮以自审。" 此是以"原筮"为再筮;孔颖达:"原谓原穷比者根本,筮谓筮决求比之情。" 李鼎祚:"能原究筮道,以求长正。" 此是以"原筮"为原穷真情而筮决之,当"原"如这些解释时,则非《坤》象。 这里的"原",本人以为应解为原野,《尔雅》:"广平曰原。" 《比》卦辞:"比吉,原筮,元永贞。" "比",甲骨文字形象两人步调一致,并排比肩而行。 到原野求筮,可纳更多人众,不隐 瞒任何私情,显示兄弟平等相好,这是说得过去的。
I0000 00:00:1789580769.598912    1982 trainer_interface.cc:155] Loaded 22000000 lines
I0000 00:00:1789580769.634387    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: 广东省东莞市东城高级中学高三 历史一轮检测 第1单元 古代中国的政治制度[br]广东省东莞市东城高级中学高三历史一轮检测 第1单元 古代中国的政治制度 ▁▂▃▄▅▆▇█▉▊▋▌精诚 凝聚 =^_^= 成就梦想 ▁▂▃▄▅▆▇█▉▊▋▌[br]这主要说明西周王朝 ( )[br]A.等级森严 C.实行嫡长子继承制[br]B.与分封制一起崩溃 D.以血缘关系为基础[br]从中可获取的历史信息有( ①西周推行的宗法等级关系 ②西周推行嫡长子继承制 ③西周实行严格的等级制度 ) ( )[br])[br]而材料只体现了皇帝制度中的皇帝地位独尊,并未体现 皇位世袭、君权神授、家天下。[br]废除了所有的封建国家和王国,将广阔的国土划分为若干行政 区,每 一行政区都配备一批由中央政府任命,并向中央政府负责的官员"(摘自《全球通 史》),这段材料涉及到的政治制度有( )[br]A.中央强化了对地方 的控制 B.君主专制造成的决策失误有所减少[br]这是在电视剧《东方朔》中, 汉武帝独特的"用人之术"。[br]汉武帝这样做的根本目的是( ) )[br]A.加强封建专制皇权 B.显示用人不拘一格[br]答案:D 17.根据下面图表所提供的信息判断该结构图反映的是哪个朝代的政权结构( ) ) )[br]A.元朝 C.明朝[br]B.宋朝 D.清朝[br]答案:(1)血缘、门第、等级。[br]--《史记· 陈丞相世家》 材料 2:[br]第(1)问材料突出了丞相一人之下万 人之上的重要地位,结合所学知识分析其弊端;第(2)问实际上要求回答三省六[br](3)明代废丞相,设内阁;清代设军机处。[br]材料 1: 察举制品德、学问、议政 能力 长官举荐 科举制 "以文取 士" 自由报考 "取士不问 家世"[br]文化结合旧制度的弊端以及人才的需求入手。
I0000 00:00:1789580769.823116    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: 原文地址:第20卦、丑月戊申日, 占岁考。作者:鋈子 第20卦、出自书中第十九章:六合章。 丑月戊申日,占岁考,得坎为水变泽水困:(旬空:寅卯) 神煞:桃花-酉 驿马-寅 文昌-申 华盖-辰 贵人-丑未 禄星-巳刃星-午 谋星-戌 天医-子 天喜-未 劫煞-巳 灾煞-午 将星-子 坎宫:坎为水(六冲)兑宫:泽水困(六合) 玄武 ▅ ▅兄弟戊子水 世 ▅ ▅官鬼丁未土 白虎 ▅▅▅官鬼戊戌土 ▅▅▅父母丁酉金 螣蛇 ▅ ▅父母戊申金 x ▅▅▅兄弟丁亥水 应 勾陈 ▅ ▅妻财戊午火 应 ▅ ▅妻财戊午火 朱雀 ▅▅▅官鬼戊辰土 ▅▅▅官鬼戊辰土 青龙 ▅ ▅子孙戊寅木 ▅ ▅子孙戊寅木 世 原著:世爻子水,丑月合之,申日作父母而生世,卦中申金又动,是 六冲变六合,卦之全美。上卷无疑,果考一等,即于子科高发。后探之,前试考过四等,所以卦得六冲变合,先否后泰之象。 注解:根据《增删卜易》成书年代,这里解释一下明清时期的 岁考 :明代省一级的教育长官名曰 提学官 ,以及清代朝廷委任的主管教育科举的官员名曰 学台或学政 ,每年或每三年对所属或者被派属的府、州、县的生员举行的考试,称为 岁考或岁试 。岁考如达不到四等以上, 秀才亦称相公 的身份就会被剥夺,民间有 秀才三年变白丁 之说,指的就是岁考不过关。岁考得一等前列者,有可能成为 廪膳生员,简称廪生 ,但名额有限,成为廪生者,朝廷会给予一定的粮(明朝)或钱(清朝)的补助。岁考和科考不是一回事,但岁考获得秀才身份之后,才有资格参加科考,初级科考(乡试)过关的考生称 贡生 ,此时才有当 小官的资格,而岁考只是一般性的考试,考过了也不具备当小官的资格。岁考制度实际是对读书人的一种禁锢,大多数读书人为此都要考一辈子呢,就没心思造反了,正所谓 十年寒窗 。更详细的请参看明史和清史稿的选举志章节。 1.审占事:此卦就是求测人占一个一般性的考试,卦的类型为一般事占之自己事占。此卦也不具备忧患占的特点。 2.查卦象:a.坎卦有险难、陷入、劳苦、磨练等卦意;b.主卦六冲,变卦六合;c.动爻父母戊申金带 文昌星动化兄弟爻丁亥水,动变组合是动始变终;d.初爻戊寅木带正驿马旬空又逢日建冲; 3.辨用神:之所以解释岁考的目的就是为了取准用神,一般性的考试是以父母爻为用神,卦中就一个父母爻戊申金,取为用神。 4.析吉凶: a.对于作者一开始便整出一句 世爻子水、丑月合之 甚是不理解,在我自己所用的卦理中,在吉凶成败层面,月建对爻的作用关系就是 旺相休囚死破 六种,对于此卦的月建合世爻,我是论克不论合的,而且作者的分析 顺序怎么是先从世爻入手呢,难不成作者以世爻为用神?当然,此卦以世爻为用神肯定是不对的。正常顺序应该是先分析用神,然后在分析用神与世爻的关系。 b.不过作者分析某一个爻的旺衰与有用无用,是先从日、月建着手,再看卦中动爻对其的向背,这个顺序是再次肯定了轻日、月建外因,重 卦中内因的重要性,再次体显了 动兆显吉凶 这句卦理的重要性。针对此卦看,用神是发动的,其旺衰与有用无用,取决于日、月建及其变爻三方的共同作用,但轻外重内是不可倒置的;而世爻是静爻,那么他的旺衰与有用无用,取决于日、月建及发动的用神也是三方的共同作用,也是要轻外重内。 c.重新梳理一下分析顺序,先用神:用神在月建得生(这里不论墓哦,我自己的卦理是,吉凶成败层面月建对爻不论墓、合,月建墓、合我主要用于取象层面,应期层面也用不到)又值日建旺,其动变组合是动始变终,而变爻是月建克、日建生,所以总体用神是旺而有用;再看用神与世爻的关系,卦中是 用神发动生世爻,从而构成了 用神生世爻 之吉利卦象。 d.有易友问,那就不看世爻了么?其实是要看世爻旺衰的,而且对于某些占事,分析世爻的旺衰还相当重要,是必须的,比如占财、比如忧患占等。那么在什么情况下是必须分析世爻旺衰的呢?这个不是几句话能阐述清晰的,因为涉及面比较多:比如要看是什么占事、比如要看卦的类型、比如要看占事的长短、比如要看是何六亲持世等等。我本人在实战中,在大多情况下的分析顺序是先分析用神,再分析世爻,然后再分析用神与世爻关系的(但不是每一卦都需要分析用神与世爻的关系的,要根据占事内容而定)。比如此卦的世爻,月建虽克但有余气,而在日建又得生,总体是旺,这在外因、外部环境来看,世爻是具备了承载或者担当所占之事(用神)的能力,而再分析用神与世爻的关系 是 用神生世爻 ,所以卦吉无疑。但并不是所有的 用神生世爻 之卦最终事情就会吉利,实战中我就遇到过即使是 用神生世爻 ,但最终事情也是不 吉的卦,注意我用的是 最终 这个词, 用神生世爻而卦吉 这个卦理是没有错误的,但事情最终的吉利与否,不仅仅只是由卦吉而决定,还要考虑占事 长短与应期的问题。比如子月庚辰日刚买了彩票占中奖否,得山火贲变泽火革(旬空:申酉) 艮宫:山火贲(六合) 坎宫:泽火革 螣蛇 ▅▅▅官鬼丙寅木 ○ ▅ ▅兄弟丁未土 勾陈 ▅ ▅妻财丙子水 ×
I0000 00:00:1789580769.823157    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: ▅▅▅子孙丁酉金 朱雀 ▅ ▅兄弟丙 戌土 应× ▅▅▅妻财丁亥水世 青龙 子孙丙申金▅▅▅妻财己亥水 ▅▅▅妻财己亥水 玄武 父母丙午火▅ ▅兄弟己丑土 ▅ ▅兄弟己丑土 白虎 兄弟丙辰土▅▅▅官鬼己卯木 世 ▅▅▅官鬼己卯木应 注解:此卦世爻得用神生而卦吉,得财的应期应是子孙出空的酉日,但当期彩票开奖日期是在辰日当晚,结果彩票 号码与中奖号码不符,当然此次买彩就是不得财了。这就是卦吉而占事是短期事,由于吉之应期晚于占事结束日期而最终事情不吉的例子。由此可见,要确切地断准一个卦,需要考虑方方面面的因素哦。 5.断应期:此卦中 即于子科高发 并不是本卦的应期,本卦的理论应期应当是下一次岁考年中 的巳月或者申月,是用神发动逢合逢值为应期。根据明清岁考制度,一般逢子、卯、午、酉年会举行一次岁考,考试时间一般是在秋季,所以根据此卦用神值日建以及主卦六冲看,考期是临近的,估计起卦时的丑月就是在亥年的丑月,而求测人参加的是子年考试,考试时间应该是在子年的申月。 6. 细取象: a.这卦可取象的部分较少,突出的一点是 前试考过四等,所以卦得六冲变合,先否后泰之象 ,主卦六冲对应了此前考试的不顺利(考了四等 及以下是要受到责罚或者剥去头衔的),也正因为此前考试的不顺利,变卦得六合,预示了即将到来的考试顺利。关于六冲变六合,六冲变六冲,六合变六冲的卦例在书中还有很多。此卦六冲变六合的组合告诉我们了一个取象思路就是:根据占事配合六冲坎卦,说明所占之事在之前应有不顺、险难, 之前的事情是一种劳苦、一种磨难等等。 b.虽然六冲变六合预示了先否后泰,但变卦是困,未见得喜反而是困惑、苦恼、压抑,为何会这样?了解明 清历史就会知道,这是由当时社会现状所决定的,考中秀才之后就有了参加乡试的资格,但即便是乡试过关获得 举人 身份,甚至是第一名举人的 解 元 身份,也不一定就能当官的,还得继续考 贡士 ,贡士第一名称 会元 ,进而才可以参加最后一级考试的殿试,通过最后一级考试的考生称 进士或 进士出身或同进士出身 。殿试第一名称 状元又称鼎元 ,我们常听到的连中三元指的就是: 中解元再中会元再中状元。 由于考试越往后越是难,所以古代众多学子的求功名之路往往止步于秀才阶段。就此卦来看,世爻已处于六爻高位,有止象,而用神动化亥水又是世爻子水的退神,兄弟爻为争斗、争上游、自尊心,所以恐求测人的争上游之心、之路就此就要止步了。
I0000 00:00:1789580769.905947    1982 trainer_interface.cc:155] Loaded 23000000 lines
I0000 00:00:1789580770.216169    1982 trainer_interface.cc:155] Loaded 24000000 lines
I0000 00:00:1789580770.461851    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: <end>联合国儿童基金会驻华办儿童保护官员苏文颖认为,家长的沟通、理解、陪伴是未成年人防沉迷事业的重要一环,因为家长的▂▃▅▆█理解和陪伴是每个孩子最基本的需求,是 他的安全感、自我价值最ǐ主要的来源。
I0000 00:00:1789580770.530097    1982 trainer_interface.cc:155] Loaded 25000000 lines
I0000 00:00:1789580770.612380    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: ◢▆▅▄▃-崩╰(〒皿〒)╯溃-▃▄▅▆◣
I0000 00:00:1789580770.828172    1982 trainer_interface.cc:155] Loaded 26000000 lines
I0000 00:00:1789580770.913621    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: <end>▅ 中等收入陷阱的实质,是产业体系的结构陷阱
I0000 00:00:1789580770.913642    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: <end>▅ 开始的是新一轮的竞争,我们就有了更多可能性
I0000 00:00:1789580770.913652    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: <end>▅ 市场环境公平竞争,自然就会有人投资
I0000 00:00:1789580770.913665    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: <end>▅ 大企业应该站出来,担当更多的责任
I0000 00:00:1789580770.913671    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: <end>▅ 投资什么都不如,投资教育重要
I0000 00:00:1789580771.037899    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: ▅▅▅▅▅
I0000 00:00:1789580771.037921    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: ▅▅▅▅
I0000 00:00:1789580771.037924    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: ▅▅▅▅▅八卦速记法:
I0000 00:00:1789580771.128245    1982 trainer_interface.cc:155] Loaded 27000000 lines
I0000 00:00:1789580771.434205    1982 trainer_interface.cc:155] Loaded 28000000 lines
I0000 00:00:1789580771.738377    1982 trainer_interface.cc:155] Loaded 29000000 lines
I0000 00:00:1789580772.049339    1982 trainer_interface.cc:155] Loaded 30000000 lines
I0000 00:00:1789580772.243428    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: 虑增加对非传统商标申请的受理 。非传统商标指的就是立体商标。商标法第四次修改,是否会将立体商标注册从法律条文变成具体制度,关注立体商标注册的企业请拭目以待。 对 包装设计进行商标保护,必须了解商标保护的特点:第一,注册商标受商标法保护,除驰名商标外未注册商标不受商标法保护;第二,较外观设计专利保护,商标注册的周期更长,从提交申请到获得注册至少需要十二个月的时间;第三,注册商标的有效期为十年,期满可以申请续展商标;第四,注册商标 权利有地域性,只限于注册国有效。 四、反不正当竞争保护 我国《反不正当竞争法》规定:擅自使用知名商品特有的名称、包装、装潢,或者使用 与知名商品近似的名称、包装、装潢,造成和他人的知名商品相混淆,使购买者误认为是该知名商品的行为,是不正当竞争行为之一,造成损害的,应 当停止侵害,承担损害赔偿责任。 运用《反不正当竞争法》保护包装设计,前提是商品在市场上具有一定知名度,为相关公众所知悉,且商品名称、 包装、装潢非为相关商品所通用,并具有显著的区别性特征,已使一般购买者发生混淆。只有当不正当竞争行为已发生时,才能启动反不正当竞争保 护。因此,与版权保护、外观设计保护、商标保护相比,进行反不正当竞争保护是 "被动"的。 五、如何选择适用 在知识产权制度下,包装设计通过上述多种方法,均可寻求获取法律保护。实务中,企业通常会问,我们的包装设计应当用什么方法进行保护?多重保护有必要吗? 对第一个问题,如本 文上述介绍,不同的知识产权保护方式,各有所用。 从防范侵权的角度,企业可以根据不同商品的生命周期及其在生命周期中所处的不同阶段,为商 品的包装设计选择不同的保护方法。如当一件新商品因时效性要求,必须尽快上市时,外观设计专利申请及商标登记耗时较长,就变得不切实际,商品的包装设计可能在未获得相关权利证明时,就已被仿冒。这种情况下,对包装设计的版权保护就是必须且适合的。如果商品历经时间的洗礼,在市场 上经久不衰,其生命周期可能远远超过外观设计专利的十年、版权的五十年保护期,那么,在该两项权利失效前,为商品的外观设计申请商标保护就成为必须。只要企业做个"有心人",注意续展并维护好其商标权益,包装设计的商标权将持续有效。从防范侵权的角度,企业也可根据商品需要保护的 程度,选择不同的知识产权保护方法。如果商品的包装设计图进行了版权登记,但企业对其保护强度不满意的情况下,可追加申请外观设计专利,或申请注册商标,强化保护。 从打击侵权者的角度,企业应选择对自己最有利、最易实施的保护方法及策略。如当企业发现其商品的包装设计被仿冒,即其版权,或专利权,或商标权受到侵害时,可根据侵权事实,制定与不正当竞争相结合或分别提出诉讼策略,最大程度维护企业利益,获得赔偿。 对第 二个问题,一方面,单件包装设计的版权登记、外观设计专利申请、商标注册成本都不高,且在某些地区企业还能获得专利申请补助,多重保护的成本在企业可承受范围之内;另一方面,版权因是自动生成,所有权人往往忽略登记手续,以至在诉讼中无法举证,而商标权及外观设计专利在诉讼中往往 会被对方提无效,无法举证及权利无效都会影响诉讼结果。所以笔者建议,在条件允许的情况下,尽量为包装设计申请一项以上的知识产权保护,才是稳妥的做法。▅ 《沈丽律师法律资讯》意在不时向客户通报有关中国知识产权法律方面的动态和信息,不构成客户赖以行动的任何法律意见或者建 议。若对本文有疑问,请与沈丽律师联系。
I0000 00:00:1789580772.356143    1982 trainer_interface.cc:155] Loaded 31000000 lines
I0000 00:00:1789580772.537192    1982 trainer_interface.cc:404] Reserved chars are found. Skipped: 本卦 第6卦:讼卦(天水讼) 互卦 第37卦:家人卦(风火家人) 错卦 第36卦:明夷卦(地火明夷) 综卦 第5卦:需卦(水天需) 讼卦 讼卦是上卦为乾,下卦为坎的卦名。是周易六十四卦 第6卦。代号是2:7。"讼"(sòng),在法庭上争辨是非曲直,打官司:讼事。讼卦的主卦是2卦坎卦[1],卦象是水,阳数是2,特性是危险和困难;客卦是7 卦乾卦,卦象是天,阳数是7,特性是强健。处境困难的主方在威力强大的客方面前,受到客方的强力限制和压迫[2],不得已时只好求之于诉讼,寻求法律保护。左图中,红色是当位的爻,天蓝色是不当位的爻,箭头表示有应。天水讼(讼卦)慎争戒讼。象曰:心中有事事难做,恰是二人争路走,雨下俱是要占先,谁肯让谁走一步。 这个卦是异卦(下坎上乾)相叠。同需卦爻排布相反,互为"综卦"。乾为刚健,坎为险陷。刚与险,健与险,彼此反对,定生 争讼。争讼非善事,务必慎重戒惧。 《讼(sòng)》:有孚,窒惕,中吉,终凶。利见大人,不利涉大川。 ▅▅▅▅▅ 上九:或锡之鞶带,终朝三褫之。 ▅▅▅▅▅ 九五:讼元吉。 ▅▅▅▅▅ 九四:不克讼,复既命,渝。安贞,吉。 ▅▅ ▅▅ 六三:食旧德,贞厉,终吉。或从王事,无成。 ▅▅▅▅▅ 九二:不克讼,归而逋。其 邑人三百户,无眚。 ▅▅ ▅▅ 初六:不永所事,小有言,终吉。 白话:化解纠纷;能够让自己建立威信,但要提高警觉尽量避免纠纷的发生。保持不偏不 倚的态度去处理,就不会有差错,但最终还是一个两败俱伤的事情。经常调解纠纷对一个人的成长有促进作用,但对事业的发展是不利的。 为了获取更多的猎物,自己经常做一些超越常理的事情(不永所事),招致大家的议论(小有言),最终大家对此类事情采用了听之任之的态度; 在与其他部落的 纠纷中调解不成功(不克讼),赶紧跑回部落躲藏起来(归而逋),有那么多部落民众的支持,他们最终拿你也没有办法(其邑人三百户,无眚); 发生纠纷后仰仗自己以往的功绩和贡献(食旧德)化解了问题,倘若依赖本部落首领则一事无成(无成)。 倘若自己败诉,那就认罚,主动给对方以物质赔偿(复 即命),这样才能够让自己今后的生活与工作平安、顺利(安贞吉); 自己改正了缺点,而且还结交了一些有能力的朋友,这样很多纠纷就消除在萌芽状态,大事化小的得以妥善解决(讼,元吉); 上面的领导经常授权你处理民众之间的纠纷,这种荣誉授命于危难(或锡之鞶带),过后会很快的把这种特权剥夺掉(终朝三褫之)。[1] 说明 结构和卦爻辞 讼卦的结构和卦爻辞 左图中,主卦的三条爻全是天蓝色,表示这三条爻都不当位,表示主方的行动、素质和态度[1]都是对主方不利的潜在因素,主方的困难和危险来于主方本身。图中,有两个从阴爻指向阳爻的箭头,表示在行动方面和态度方面都存在主方与客方之间的和谐关系,不过,由于箭头的起点都在主方[3],这两种和谐关系使得在行动上和态度上对主方不利的潜在因素成了真正的对主方不利的因素。卦的结构图中,有一条红色的爻,这是唯一的一条当位的爻,是第五爻,代表客方素质,是对主方有利的潜在因素,然而,这条爻不有应,对应的第二爻也是不当位的阳爻,这个对主方有利的潜在因素没有能够成为真正的对主方有利的因素。因此可以说,当前形势对于主方来说,是不利的,主方应当努力扭转被动局面,并且,采取对客方比较强硬的态度。 不过,主方的消极被动是衰落的表现。按阳数,事物自身发展规律[2]是4、5、6、7、3、2、1和0,主卦的阳数是2,已经从乾卦,越过一个量变到质变的关键点,衰落到巽卦,再衰落到坎卦,要扭转被动局面很难,需要很大的决心和付出,比较现实的作法是阴中有阳,在可能情况下,采取主动,维护自己的利益。同时,采取比较强硬的态度,也是有限的,因为态度随和是素质不是很好的 表现,没有很强的素质支持,强硬态度难维持,所以,也只能是灵活应对,态度能够强硬一些,就强硬一些,不行就继续随和。 讼卦的六条爻辞中有三条包含"讼"字,第二爻的"讼",指主方被客方所讼;第四爻和第五爻的"讼",是主方对客方的讼。前三条爻辞,建议主方尽量避免被诉讼,"不永所事";不 能赢得诉讼时,应当给予客方适当赔偿,"不克讼,归而逋";困境中坚持下去,"食旧德"。后三条爻辞建议主方应当对客方采用诉讼手段,不能赢,则退,"不克讼,复即命";能赢则吉,"讼,元吉";不要过于相信客方,"终朝三褫之"。删去一些判断词,六条爻辞就是一首完整的围绕主题"讼"的散文诗。 不要纠缠于诉讼之事,即使有流言蜚语,最终还是有利。 诉讼中不赢,归来后隐藏起来,给以城镇里三百户人口的税收,避免灾难。 依靠过去的成就过 日子,坚持不下去;如果从事于政府事务,不会成功。 诉讼不赢,返回遵从王命,改变一些(态度),维持安定生活。 (不得已)诉讼,很吉利。 有时(他)赐给佩玉皮带,又一天之内三次夺了回去,(忍耐些吧)。 卦辞则提出在当前的双方关系中主方应当采取的作法。下面逐条说明卦爻辞。 卦辞 〖卦 辞原文〗
I0000 00:00:1789580772.661460    1982 trainer_interface.cc:155] Loaded 32000000 lines
I0000 00:00:1789580772.969213    1982 trainer_interface.cc:155] Loaded 33000000 lines
W0000 00:00:1789580773.814576    1982 trainer_interface.cc:130] Too many sentences are loaded! (33578623), which may slow down training.
W0000 00:00:1789580773.814608    1982 trainer_interface.cc:132] Consider using --input_sentence_size=<size> and --shuffle_input_sentence=true.
W0000 00:00:1789580773.814610    1982 trainer_interface.cc:135] They allow to randomly sample <size> sentences from the entire corpus.
I0000 00:00:1789580773.814614    1982 trainer_interface.cc:422] Loaded all 33578623 sentences
I0000 00:00:1789580773.814625    1982 trainer_interface.cc:440] Adding meta_piece: <unk>
I0000 00:00:1789580773.814630    1982 trainer_interface.cc:440] Adding meta_piece: <s>
I0000 00:00:1789580773.814632    1982 trainer_interface.cc:440] Adding meta_piece: </s>
I0000 00:00:1789580773.814633    1982 trainer_interface.cc:440] Adding meta_piece: <pad>
I0000 00:00:1789580773.814637    1982 trainer_interface.cc:440] Adding meta_piece: <0x00>
I0000 00:00:1789580773.814638    1982 trainer_interface.cc:440] Adding meta_piece: <0x01>
I0000 00:00:1789580773.814640    1982 trainer_interface.cc:440] Adding meta_piece: <0x02>
I0000 00:00:1789580773.814642    1982 trainer_interface.cc:440] Adding meta_piece: <0x03>
I0000 00:00:1789580773.814646    1982 trainer_interface.cc:440] Adding meta_piece: <0x04>
I0000 00:00:1789580773.814649    1982 trainer_interface.cc:440] Adding meta_piece: <0x05>
I0000 00:00:1789580773.814652    1982 trainer_interface.cc:440] Adding meta_piece: <0x06>
I0000 00:00:1789580773.814654    1982 trainer_interface.cc:440] Adding meta_piece: <0x07>
I0000 00:00:1789580773.814657    1982 trainer_interface.cc:440] Adding meta_piece: <0x08>
I0000 00:00:1789580773.814660    1982 trainer_interface.cc:440] Adding meta_piece: <0x09>
I0000 00:00:1789580773.814663    1982 trainer_interface.cc:440] Adding meta_piece: <0x0A>
I0000 00:00:1789580773.814666    1982 trainer_interface.cc:440] Adding meta_piece: <0x0B>
I0000 00:00:1789580773.814668    1982 trainer_interface.cc:440] Adding meta_piece: <0x0C>
I0000 00:00:1789580773.814670    1982 trainer_interface.cc:440] Adding meta_piece: <0x0D>
I0000 00:00:1789580773.814673    1982 trainer_interface.cc:440] Adding meta_piece: <0x0E>
I0000 00:00:1789580773.814676    1982 trainer_interface.cc:440] Adding meta_piece: <0x0F>
I0000 00:00:1789580773.814677    1982 trainer_interface.cc:440] Adding meta_piece: <0x10>
I0000 00:00:1789580773.814679    1982 trainer_interface.cc:440] Adding meta_piece: <0x11>
I0000 00:00:1789580773.814683    1982 trainer_interface.cc:440] Adding meta_piece: <0x12>
I0000 00:00:1789580773.814686    1982 trainer_interface.cc:440] Adding meta_piece: <0x13>
I0000 00:00:1789580773.814688    1982 trainer_interface.cc:440] Adding meta_piece: <0x14>
I0000 00:00:1789580773.814691    1982 trainer_interface.cc:440] Adding meta_piece: <0x15>
I0000 00:00:1789580773.814692    1982 trainer_interface.cc:440] Adding meta_piece: <0x16>
I0000 00:00:1789580773.814694    1982 trainer_interface.cc:440] Adding meta_piece: <0x17>
I0000 00:00:1789580773.814697    1982 trainer_interface.cc:440] Adding meta_piece: <0x18>
I0000 00:00:1789580773.814700    1982 trainer_interface.cc:440] Adding meta_piece: <0x19>
I0000 00:00:1789580773.814702    1982 trainer_interface.cc:440] Adding meta_piece: <0x1A>
I0000 00:00:1789580773.814704    1982 trainer_interface.cc:440] Adding meta_piece: <0x1B>
I0000 00:00:1789580773.814708    1982 trainer_interface.cc:440] Adding meta_piece: <0x1C>
I0000 00:00:1789580773.814709    1982 trainer_interface.cc:440] Adding meta_piece: <0x1D>
I0000 00:00:1789580773.814711    1982 trainer_interface.cc:440] Adding meta_piece: <0x1E>
I0000 00:00:1789580773.814714    1982 trainer_interface.cc:440] Adding meta_piece: <0x1F>
I0000 00:00:1789580773.814717    1982 trainer_interface.cc:440] Adding meta_piece: <0x20>
I0000 00:00:1789580773.814720    1982 trainer_interface.cc:440] Adding meta_piece: <0x21>
I0000 00:00:1789580773.814721    1982 trainer_interface.cc:440] Adding meta_piece: <0x22>
I0000 00:00:1789580773.814723    1982 trainer_interface.cc:440] Adding meta_piece: <0x23>
I0000 00:00:1789580773.814726    1982 trainer_interface.cc:440] Adding meta_piece: <0x24>
I0000 00:00:1789580773.814729    1982 trainer_interface.cc:440] Adding meta_piece: <0x25>
I0000 00:00:1789580773.814730    1982 trainer_interface.cc:440] Adding meta_piece: <0x26>
I0000 00:00:1789580773.814732    1982 trainer_interface.cc:440] Adding meta_piece: <0x27>
I0000 00:00:1789580773.814735    1982 trainer_interface.cc:440] Adding meta_piece: <0x28>
I0000 00:00:1789580773.814737    1982 trainer_interface.cc:440] Adding meta_piece: <0x29>
I0000 00:00:1789580773.814739    1982 trainer_interface.cc:440] Adding meta_piece: <0x2A>
I0000 00:00:1789580773.814742    1982 trainer_interface.cc:440] Adding meta_piece: <0x2B>
I0000 00:00:1789580773.814745    1982 trainer_interface.cc:440] Adding meta_piece: <0x2C>
I0000 00:00:1789580773.814748    1982 trainer_interface.cc:440] Adding meta_piece: <0x2D>
I0000 00:00:1789580773.814751    1982 trainer_interface.cc:440] Adding meta_piece: <0x2E>
I0000 00:00:1789580773.814754    1982 trainer_interface.cc:440] Adding meta_piece: <0x2F>
I0000 00:00:1789580773.814755    1982 trainer_interface.cc:440] Adding meta_piece: <0x30>
I0000 00:00:1789580773.814757    1982 trainer_interface.cc:440] Adding meta_piece: <0x31>
I0000 00:00:1789580773.814759    1982 trainer_interface.cc:440] Adding meta_piece: <0x32>
I0000 00:00:1789580773.814761    1982 trainer_interface.cc:440] Adding meta_piece: <0x33>
I0000 00:00:1789580773.814765    1982 trainer_interface.cc:440] Adding meta_piece: <0x34>
I0000 00:00:1789580773.814766    1982 trainer_interface.cc:440] Adding meta_piece: <0x35>
I0000 00:00:1789580773.814768    1982 trainer_interface.cc:440] Adding meta_piece: <0x36>
I0000 00:00:1789580773.814770    1982 trainer_interface.cc:440] Adding meta_piece: <0x37>
I0000 00:00:1789580773.814772    1982 trainer_interface.cc:440] Adding meta_piece: <0x38>
I0000 00:00:1789580773.814773    1982 trainer_interface.cc:440] Adding meta_piece: <0x39>
I0000 00:00:1789580773.814777    1982 trainer_interface.cc:440] Adding meta_piece: <0x3A>
I0000 00:00:1789580773.814780    1982 trainer_interface.cc:440] Adding meta_piece: <0x3B>
I0000 00:00:1789580773.814784    1982 trainer_interface.cc:440] Adding meta_piece: <0x3C>
I0000 00:00:1789580773.814787    1982 trainer_interface.cc:440] Adding meta_piece: <0x3D>
I0000 00:00:1789580773.814788    1982 trainer_interface.cc:440] Adding meta_piece: <0x3E>
I0000 00:00:1789580773.814789    1982 trainer_interface.cc:440] Adding meta_piece: <0x3F>
I0000 00:00:1789580773.814793    1982 trainer_interface.cc:440] Adding meta_piece: <0x40>
I0000 00:00:1789580773.814796    1982 trainer_interface.cc:440] Adding meta_piece: <0x41>
I0000 00:00:1789580773.814798    1982 trainer_interface.cc:440] Adding meta_piece: <0x42>
I0000 00:00:1789580773.814801    1982 trainer_interface.cc:440] Adding meta_piece: <0x43>
I0000 00:00:1789580773.814802    1982 trainer_interface.cc:440] Adding meta_piece: <0x44>
I0000 00:00:1789580773.814804    1982 trainer_interface.cc:440] Adding meta_piece: <0x45>
I0000 00:00:1789580773.814807    1982 trainer_interface.cc:440] Adding meta_piece: <0x46>
I0000 00:00:1789580773.814810    1982 trainer_interface.cc:440] Adding meta_piece: <0x47>
I0000 00:00:1789580773.814811    1982 trainer_interface.cc:440] Adding meta_piece: <0x48>
I0000 00:00:1789580773.814815    1982 trainer_interface.cc:440] Adding meta_piece: <0x49>
I0000 00:00:1789580773.814817    1982 trainer_interface.cc:440] Adding meta_piece: <0x4A>
I0000 00:00:1789580773.814818    1982 trainer_interface.cc:440] Adding meta_piece: <0x4B>
I0000 00:00:1789580773.814822    1982 trainer_interface.cc:440] Adding meta_piece: <0x4C>
I0000 00:00:1789580773.814825    1982 trainer_interface.cc:440] Adding meta_piece: <0x4D>
I0000 00:00:1789580773.814827    1982 trainer_interface.cc:440] Adding meta_piece: <0x4E>
I0000 00:00:1789580773.814831    1982 trainer_interface.cc:440] Adding meta_piece: <0x4F>

...

I0000 00:00:1789580773.815199    1982 trainer_interface.cc:440] Adding meta_piece: <0xFC>
I0000 00:00:1789580773.815200    1982 trainer_interface.cc:440] Adding meta_piece: <0xFD>
I0000 00:00:1789580773.815201    1982 trainer_interface.cc:440] Adding meta_piece: <0xFE>
I0000 00:00:1789580773.815205    1982 trainer_interface.cc:440] Adding meta_piece: <0xFF>
I0000 00:00:1789580773.815254    1982 trainer_interface.cc:445] Normalizing sentences...
I0000 00:00:1789580790.216944    1982 trainer_interface.cc:540] Found null character. The corpus must be encoded in utf-8.
I0000 00:00:1789580790.217012    1982 trainer_interface.cc:540] Found null character. The corpus must be encoded in utf-8.
I0000 00:00:1789580793.338846    1982 trainer_interface.cc:540] Found null character. The corpus must be encoded in utf-8.
I0000 00:00:1789580794.864728    1982 trainer_interface.cc:540] Found null character. The corpus must be encoded in utf-8.

...


I0000 00:00:1789580820.315622    1982 trainer_interface.cc:540] Found null character. The corpus must be encoded in utf-8.
I0000 00:00:1789580820.315684    1982 trainer_interface.cc:540] Found null character. The corpus must be encoded in utf-8.
I0000 00:00:1789580823.129607    1982 trainer_interface.cc:540] Found null character. The corpus must be encoded in utf-8.
I0000 00:00:1789580824.518879    1982 trainer_interface.cc:540] Found null character. The corpus must be encoded in utf-8.
I0000 00:00:1789580825.703897    1982 trainer_interface.cc:555] all chars count=2999965705
I0000 00:00:1789580825.708025    1982 trainer_interface.cc:566] Done: 99.95% characters are covered.
I0000 00:00:1789580825.708074    1982 trainer_interface.cc:578] Alphabet size=7205
I0000 00:00:1789580825.708077    1982 trainer_interface.cc:579] Final character coverage=0.9995
I0000 00:00:1789580900.593705    1982 trainer_interface.cc:609] Done! preprocessed 33578623 sentences.
I0000 00:00:1789580900.593758    1982 trainer_interface.cc:615] Tokenizing input sentences with whitespace: 33578623
I0000 00:00:1789583596.599922    1982 bpe_model_trainer.cc:321] Added: freq=3543 size=46200 all=110219616 active=110212409 piece=求生
I0000 00:00:1789583596.698638    1982 bpe_model_trainer.cc:321] Added: freq=3542 size=46220 all=110249507 active=110242300 piece=社会服务
I0000 00:00:1789583596.790884    1982 bpe_model_trainer.cc:321] Added: freq=3540 size=46240 all=110269800 active=110262593 piece=采取有效措施
I0000 00:00:1789583596.895783    1982 bpe_model_trainer.cc:321] Added: freq=3537 size=46260 all=110295238 active=110288031 piece=正宗
I0000 00:00:1789583596.981900    1982 bpe_model_trainer.cc:321] Added: freq=3535 size=46280 all=110316133 active=110308926 piece=恭喜
I0000 00:00:1789583597.075414    1982 bpe_model_trainer.cc:321] Added: freq=3534 size=46300 all=110342359 active=110335152 piece=▁associ
I0000 00:00:1789583597.172341    1982 bpe_model_trainer.cc:321] Added: freq=3532 size=46320 all=110364878 active=110357671 piece=体育教师
I0000 00:00:1789583597.298097    1982 bpe_model_trainer.cc:321] Added: freq=3530 size=46340 all=110392295 active=110385088 piece=社会责任感
I0000 00:00:1789583597.380924    1982 bpe_model_trainer.cc:321] Added: freq=3528 size=46360 all=110415956 active=110408749 piece=中可
I0000 00:00:1789583597.479986    1982 bpe_model_trainer.cc:321] Added: freq=3527 size=46380 all=110445691 active=110438484 piece=水环境
I0000 00:00:1789583597.570703    1982 bpe_model_trainer.cc:321] Added: freq=3525 size=46400 all=110473299 active=110466092 piece=华严
I0000 00:00:1789583597.666327    1982 bpe_model_trainer.cc:321] Added: freq=3523 size=46420 all=110496896 active=110489689 piece=由衷
I0000 00:00:1789583597.758308    1982 bpe_model_trainer.cc:321] Added: freq=3522 size=46440 all=110519006 active=110511799 piece=孩子自己
I0000 00:00:1789583597.862618    1982 bpe_model_trainer.cc:321] Added: freq=3520 size=46460 all=110546444 active=110539237 piece=共和国的
I0000 00:00:1789583597.955909    1982 bpe_model_trainer.cc:321] Added: freq=3518 size=46480 all=110564939 active=110557732 piece=不要说
I0000 00:00:1789583598.056849    1982 bpe_model_trainer.cc:321] Added: freq=3517 size=46500 all=110596989 active=110589782 piece=根据上述
I0000 00:00:1789583598.134317    1982 bpe_model_trainer.cc:321] Added: freq=3515 size=46520 all=110616873 active=110609666 piece=前部
I0000 00:00:1789583598.237715    1982 bpe_model_trainer.cc:321] Added: freq=3513 size=46540 all=110640292 active=110633085 piece=也不少
I0000 00:00:1789583598.328996    1982 bpe_model_trainer.cc:321] Added: freq=3512 size=46560 all=110666180 active=110658973 piece=康复治疗
I0000 00:00:1789583598.409536    1982 bpe_model_trainer.cc:321] Added: freq=3511 size=46580 all=110689139 active=110681932 piece=森林防火
I0000 00:00:1789583598.503704    1982 bpe_model_trainer.cc:321] Added: freq=3509 size=46600 all=110713932 active=110706725 piece=的客户
I0000 00:00:1789583598.603126    1982 bpe_model_trainer.cc:321] Added: freq=3507 size=46620 all=110744766 active=110737559 piece=接见

...


I0000 00:00:1789583645.325150    1982 bpe_model_trainer.cc:321] Added: freq=2827 size=56340 all=122072487 active=122065280 piece=等条件
I0000 00:00:1789583645.394682    1982 bpe_model_trainer.cc:321] Added: freq=2826 size=56360 all=122096213 active=122089006 piece=的高潮
I0000 00:00:1789583645.459399    1982 bpe_model_trainer.cc:321] Added: freq=2825 size=56380 all=122115003 active=122107796 piece=乡村治理
I0000 00:00:1789583645.531548    1982 bpe_model_trainer.cc:321] Added: freq=2824 size=56400 all=122134364 active=122127157 piece=自上而下的
I0000 00:00:1789583645.606042    1982 bpe_model_trainer.cc:321] Added: freq=2822 size=56420 all=122150887 active=122143680 piece=鎏金
I0000 00:00:1789583645.680787    1982 bpe_model_trainer.cc:321] Added: freq=2821 size=56440 all=122172942 active=122165735 piece=70%,
I0000 00:00:1789583645.752509    1982 bpe_model_trainer.cc:321] Added: freq=2820 size=56460 all=122194296 active=122187089 piece=-02-
I0000 00:00:1789583645.832945    1982 bpe_model_trainer.cc:321] Added: freq=2819 size=56480 all=122214036 active=122206829 piece=的最基本
I0000 00:00:1789583645.914464    1982 bpe_model_trainer.cc:321] Added: freq=2817 size=56500 all=122234437 active=122227230 piece=大师的
I0000 00:00:1789583645.985964    1982 bpe_model_trainer.cc:321] Added: freq=2815 size=56520 all=122251937 active=122244730 piece=戒指
I0000 00:00:1789583699.293838    1982 trainer_interface.cc:702] Saving model: ./tokenizer.model
I0000 00:00:1789583699.382307    1982 trainer_interface.cc:714] Saving vocabs: ./tokenizer.vocab
] contains escaped characters that break the format of ./tokenizer.vocabe [
[02:35:12]   分词器训练完成,耗时 49m10s -> ./tokenizer.model
[02:35:12] ==============================================================================
[02:35:12] 分词 299 个新的 jsonl 文件 -> uint16 token 分片
[02:35:12] ==============================================================================
[02:35:33]   处理 part_000000.jsonl (1.05 GB)…
[02:35:59]     112.64K 篇文档 | 143.89M train tokens | 4377 篇/s
[02:36:07]   part_000000.jsonl 完成:166.48K 篇,耗时 0m33s
[02:36:07]   处理 part_000001.jsonl (1.06 GB)…
[02:36:23]     112.64K 篇文档 | 356.56M train tokens | 7063 篇/s
[02:36:31]   part_000001.jsonl 完成:167.05K 篇,耗时 0m23s
[02:36:31]   处理 part_000002.jsonl (1.05 GB)…
[02:36:47]     112.64K 篇文档 | 571.72M train tokens | 6918 篇/s
[02:36:55]   part_000002.jsonl 完成:166.88K 篇,耗时 0m23s
[02:36:55]   处理 part_000003.jsonl (1.03 GB)…
[02:37:10]     112.64K 篇文档 | 784.35M train tokens | 7238 篇/s
[02:37:17]   part_000003.jsonl 完成:163.30K 篇,耗时 0m22s

...


[05:42:59]   处理 part_000298.jsonl (1.03 GB)…
[05:43:17]     112.64K 篇文档 | 24.20B train tokens | 6094 篇/s
[05:43:23]   part_000298.jsonl 完成:153.11K 篇,耗时 0m24s
[05:43:24]   处理 part_000299.jsonl (1.03 GB)…
[05:43:41]     112.64K 篇文档 | 24.41B train tokens | 6320 篇/s
[05:43:48]   part_000299.jsonl 完成:153.81K 篇,耗时 0m24s
[05:43:49] 完成预分词:18.56M 篇文档 -> train 42.87B tokens (834 片) + val 5.00M tokens,总耗时 47m10s
[05:43:49] 总耗时 47m10s
随着打印的一条条的 part_000298.jsonl 完成 ,300 个数据集文件逐渐被消化完, ./token_bins 目录下多出了一大堆 .bin 后缀的文件,这就是我们预分词好的文件。
我是在 AutoDL 的 25 vCPU Intel(R) Xeon(R) Platinum 8470Q 配合 120GB 内存的机器上训练的,用时大概一小时左右。完整的训练日志可以在代码目录里的 notebooks/ch7-gpt/bpe.log 文件中查看。
这下我们总算是把数据给准备好了,接下来我们就要正式开始训练我们的模型了。
7.5.4 定制训练 GPT-3 XL
我们打算复刻一个 GPT-3 的网络,但是我们并不想完全一模一样的照抄。比如说,我们希望能中文的数据集训练出一个懂中文的模型出来,比如说我们希望把上下文长度从原文 2048 拓展到 4096。总之,我们也会根据实际情况对它做一些现代化的适配。
7.5.4.1 初始化配置参数
我们先从 Config 配置类看看我们打算训练一个什么样的 GPT-3 网络出来。
在程序的一开始,我们配置了一个环境变量 PYTORCH_CUDA_ALLOC_CONF 值为 expandable_segments:True。这是开启了 PyTorch 的一种所谓的「可扩展段」的使用显存的方。正如其名,它的作用是在我们申请完一段显存,后面又有新的代码申请了紧挨着我们的显存导致我们想增加显存大小时,不用拷贝整段显存到新的地点,可以直接增加已申请显存段的大小。当然,这又是一个 CPU 时代的经典问题,所以它其实也是应用了 CPU 时代的经典解法 —— 「页表」。所以,开启这个特性的收益是更少的显存碎片,导致更紧凑的显存存放,导致更多的可使用显存。就像下面这个图 7-1 所示的开启 expandable_segments:True 与否 PyTorch 使用显存的对比。
图 7-1 开启 expandable_segments:True 与否 PyTorch 使用显存的对比
它的代价也和页表一样,会带来一部分计算开销。 由于查询页表实在是个太过频繁的操作, CPU 里有专门加速查页表的硬件单元叫做 MMU Memory Management Unit,会让我们在软件层面做这个 TLB Translation Lookaside Buffer 虚拟地址到物理地址翻译的操作代价极小。 GPU 也一样, NVIDIA GPU 中和它对等的硬件单元被 NVIDIA 称为 GMMU GPU Memory Management Unit,它除了像 CPU 的 MMU 一样承担 TLB 的工作,方便我们编程的自动从内存往显存搬数据的 Unified Memory 被称为统一内存的工作也是它做的。
PyTorch 长期把这个选项置于实验状态的原因是 Windows 平台和跨越多机做内存通信的场景还有些问题,具体的信息可以看他们在 Github 上关于 NCCL 的讨论 和 Github 上关于 IPC 的讨论。我们的场景是不涉及这些事的。
更多关于这个选项的信息我们还可以读读 PyTorch 官方关于如何优化显存的文档 中相关段落和 NVDIA 关于处理显存问题的建议 ,从中可以获取更高视角关于显存使用的一些信息。
总之,我们勇敢打开,省钱! GMMU 别摸鱼了, Go!
import array
import gc
import json
import math
import os
import queue
import random
import shutil
import threading
import time

# 在 torch 初始化 CUDA 分配器之前设置,扩展显存段,显著减少长时间训练的碎片,目的是榨干显存
os.environ.setdefault("PYTORCH_CUDA_ALLOC_CONF", "expandable_segments:True")

# 让 torch.cuda.is_available() 走 NVML NVIDIA Management Library 的 C API 去查, 而不是用 CUDA runtime 去查,避免初始化 CUDA 上下文遗留状态
os.environ.setdefault("PYTORCH_NVML_BASED_CUDA_CHECK", "1")

import torch
import torch.nn as nn
import torch.nn.functional as F
from torch.utils.data import DataLoader, IterableDataset

import sentencepiece as spm

import httpx
from dotenv import load_dotenv

# =============================================================================
#                               Configurations
# =============================================================================
class Config:
    # ------------------------------------------------------------------ 路径
    token_bin_dir = "./token_bins"       # 预分词好的 uint16 token ID 分片输出目录
    ramdisk_dir = "./myramdisk"          # -> /dev/shm,用于滚动缓存 token 分片,规避慢速的 SSD 随机读
    ckpt_dir = "./checkpoints"           # 存储模型的目录,只存用于续传的 ckpt_last.pt 与最终训练成果 ckpt_best.pt

    # -------------------------- 模型定义 --------------------------
    vocab_size = 64000                   # < 65536,确保 token ID 可用 uint16 存储
    n_layer = 24                         # 和 GPT-3 XL 一样,叠 24 个 Transformer 块
    d_model = 2048                       # 网络中各个零部件的隐藏维度,即单层网络的最宽维度,在昨天的代码搜索 d_model 能看到它的影响范围
    n_head = 16                          # d_head = 2048 / 16 = 128
    d_ff = 4 * 2048                      # FFN 中间层的维度 ,按照 GPT-3 论文设定为 4×d_model 8192
    block_size = 4096                    # 上下文长度。原始论文中为 2048。cci3-hq 中 17.6% 的文档长度大于 2048 , 6.4% 大于 4096,2.1% 大于 8192 , 故取此值
    dropout = 0.0                        # 大语料单 epoch 训练不担心过拟合,置 0
    bias = True                          # GPT-2/3 的 Linear 带 bias
    tie_embeddings = True                # lm_head 与 wte 权重共享

    # -------------------------- 训练超参 --------------------------
    lr = 2.0e-4                          # 峰值学习率
    min_lr_ratio = 0.1                   # 余弦退火终点 = 峰值的 10%
    betas = (0.9, 0.95)                  # Adam 的 L1 和 L2 的动量系数
    eps = 1e-8                           # Adam 的分母 epsilon
    weight_decay = 0.1                   # 作用于矩阵参数的权重衰减
    grad_clip = 1.0                      # 梯度裁剪系数 1.0 - 不放大就行
    warmup_tokens = 375_000_000          # 抄袭论文中的做法:前 3.75 亿 token 线性 warmup
    batch_tokens = 512 * 2048            # 抄袭论文中的做法:XL 的 batch 约 100 万 token

    # 微批量大小:调节显存的主旋钮
    # 实测(RTX PRO 6000,torch.compile,含累积+验证+存档):
    #   micro_bsz=8 -> 32.6K tok/s,95.7GB(余 6.3GB)← 默认
    #   micro_bsz=7 -> 32.1K tok/s,86.8GB(余 15.2GB)
    # 取 8 是因为 grad_accum = 32,正好凑齐论文的 1,048,576 token/step
    # grad_accum = batch_tokens // (micro_bsz * block_size) = 32
    micro_bsz = 8                        # 单次前向的序列条数,主要靠这个来调整显存占用

    total_train_tokens = 30_000_000_000  # 总训练 token 数。论文是 3000 亿 token,约等于 200G 中文语料,数据集不够时会自动重复

    # -------------------------- RamDisk 加速数据集 --------------------------
    ramdisk_budget_bytes = 2 * 1024**3   # ramdisk 上 token 分片的大小限制,2 GiB
    num_workers = 6                      # DataLoader 工作进程数
    prefetch_factor = 4                  # 每个进程预取的 batch 数

    # -------------------------- 运行时优化 --------------------------
    device = "cuda"
    dtype = "bfloat16"                   # 只支持 bfloat16 / float32。不支持 float16,因为 fp16 和它俩最大最小值范围不同,所以 fp16 需要 GradScaler , 而 GradScaler 会回到 CPU, 然后就会很慢
    compile_model = True                 # 开启 torch.compile
    seed = 1337                          # 随便写死一个种子
    resume = "auto"                      # "auto" = 自动加载 ckpt_last.pt;None = 从头;或填 ckpt 路径

    # -------------------------- 日志 --------------------------
    log_every = 10                       # 每多少个 optimizer step 打一行日志
    eval_every = 50                      # 每多少步跑一次验证
    eval_iters = 50                      # 验证时跑多少个 batch
    ckpt_every = 200                     # 每多少步写一次 ckpt_last.pt。实验得知:100 步大概 1 小时,即崩溃最多丢 2 小时;
    gc_every_steps = 2000                # 每多少步显式 gc.collect(),每个 epoch 也会 gc.collect(),清掉 DataLoader 带来的内存泄漏
    oom_max_retries = 5                  # 连续多少次 OOM 才报错。偶尔 OOM 会清梯度 + empty_cache + 丢掉这一步重来,而不是直接崩溃。

    # NVIDIA RTX PRO 6000 Blackwell Server Edition 官方说 bf16 是 1000 TFLOPS
    # https://www.nvidia.com/en-us/data-center/rtx-pro-6000-blackwell-server-edition/
    #
    # 但那是它说的是 bf16 稀疏计算
    # 我们用的 SDPA 是 bf16 稠密计算,所以是 500 TFLOPS
    #
    # 所谓稠密,就是每个值都正常算。
    # 所谓稀疏,就是把原来 4x4 的矩阵剪成 2x4 的矩阵再计算,那当然算计性能就翻倍了,就像下面这样
    #
    # 原始稠密矩阵 W (4×4)              剪枝后的 W(仍是 4×4)
    # ┌───────────────┐                ┌───────────────┐
    # │ 3   1   5   2 │                │ 3   0   5   0 │   ← 只是 4 个位置变成 0
    # │ 7   4   9   1 │       ──►      │ 7   0   9   0 │      矩阵还是 4 行 4 列
    # │ 2   6   8   3 │                │ 2   0   8   0 │      数学上还是同一个
    # │ 9   5   4   6 │                │ 9   0   4   0 │      形状的矩阵
    # └───────────────┘                └───────────────┘
    # 稀疏计算通常用在不怕错,反正也经常量化的推理环节;
    # 咱们现在要训练,不用它

    # 本参数仅用于在日志里,估算显卡 MFU,不参与真正的训练。
    # 我们正常用稠密的性能来计算
    gpu_peak_flops_bf16 = 500e12


    # -------------------------- Debug 开关 --------------------------
    limit_steps = None                   # 只跑 N 个 optimizer step 后退出(None = 不限制)
    benchmark_only = False               # True = 只跑吞吐基准,不写 ckpt
    send_notify = True                   # 是否发送告警消息
7.5.4.2 准备几个工具函数
和预分词一样,把打日志等一些工具函数我们先预先准备一下。
# =============================================================================
#                                  Utils
# =============================================================================

# 打日志用的
def log(msg):
    print(f"[{time.strftime('%H:%M:%S')}] {msg}", flush=True)

# 在日志里格式化显示 K M B T 这些数量简称的
def fmt_count(n):
    for unit, div in (("T", 1e12), ("B", 1e9), ("M", 1e6), ("K", 1e3)):
        if n >= div:
            return f"{n / div:.2f}{unit}"
    return str(int(n))

# 在日志里格式化显示时间的
def fmt_duration(seconds):
    if seconds != seconds or seconds in (float("inf"), float("-inf")) or seconds < 0:
        return "--"
    seconds = int(seconds)
    d, seconds = divmod(seconds, 86400)
    h, seconds = divmod(seconds, 3600)
    m, s = divmod(seconds, 60)
    if d:
        return f"{d}d{h:02d}h{m:02d}m"
    if h:
        return f"{h}h{m:02d}m{s:02d}s"
    return f"{m}m{s:02d}s"

# 用 os.replace 保证文件写入的原子化,即不会写出一个一半完成的文件
def atomic_torch_save(obj, path):
    tmp = path + ".tmp"
    torch.save(obj, tmp)
    os.replace(tmp, path)
7.5.4.3 准备 DataLoader
然后我们就要开始准备我们的 DataLoader,弄好这个之后,我们就该拼装我们的 GPT-3 网络,然后就能训练了。
我们因为比普通的 DataLoader 多了一个 ramdisk 中转的操作,所以我们的 DataSet 会写得复杂一些。但是面对多租户的 AutoDL,这个也是没办法的事。
这次我们不从之前用过的 torch.utils.data.Dataset 继承,我们从 torch.utils.data.IterableDataset 继承制造出我们的 DataSet。
IterableDataset 更适合我们现在这种需要流式读取的场景。因为我们的数据要先经过 ramdisk 的预读,然后一个个读进来。我们这种「边写边读」的场景想提前知道总共多少条数据,然后从数组索引去取数据太麻烦了。所以,我们很难实现 torch.utils.data.Dataset 要求我们实现的 __len__ 和 __getitem__。
IterableDataset 要求我们实现的是 __init__ 和 __iter__。前者是放开始数据之前的初始化过程,刚好可以用来做我们正式开始读数据之前把分片拷贝到 ramdisk 的操作。后者是返回一个生成器,torch.utils.data.DataLoader 会调用这个生成器去拿数据,刚好我们就在这里面放我们读数据的逻辑。然后我们还是像以前一样把这个 DataSet 传给 DataLoader 就行。
DataLoader 的用法和之前一样,它会把其中的差异封装好。比较能感知到的不同是,因为它看不到全局,我们不能再用 DataLoader 自带的 shuffle() 方法了。这次我们得自己实现 shuffle。
# =============================================================================
#                      ramdisk 滚动预取的 DataLoader
# =============================================================================


# 读取预分词分片
# Ramdisk 上的分片副本如果不在了,比如上一轮的清理线程删掉了,则退回读磁盘上的 fallback_path 源文件
def read_shard(path, n_tokens, fallback_path=None):
    for p in (path, fallback_path):
        if p is None or not os.path.exists(p):
            continue
        try:
            # 用 torch.from_file 做 mmap,零拷贝把文件映射成 uint16 张量
            return torch.from_file(p, shared=False, size=n_tokens, dtype=torch.uint16)
        except Exception:
            # 如果 mmap 失败(如大小不匹配)时退回普通读文件
            with open(p, "rb") as f:
                return torch.frombuffer(bytearray(f.read()), dtype=torch.uint16)
    raise FileNotFoundError(f"分片不可读:{path}(备用 {fallback_path})")


# 制造我们这次要用的 DataSet
#
# 每个 DataLoader worker 负责 shard 列表的一个子集,自带一个后台预取线程,
# 把下一批分片从磁盘复制进 ramdisk,用完后删掉
class ShardedTokenDataset(IterableDataset):

    def __init__(self, shards, token_bin_dir, ramdisk_dir, block_size,
                 budget_bytes, num_workers, seed, tag):
        self.shards = list(shards)              # [(文件名, token 数), ...]
        self.token_bin_dir = token_bin_dir      # 分片目录地址
        self.ramdisk_dir = ramdisk_dir          # ramdisk 目录地址
        self.block_size = block_size            # 每个样本的序列长度,也就是上下文大小
        self.budget_bytes = budget_bytes        # 2G 总 ramdisk 大小
        self.num_workers = max(1, num_workers)  # 最大 worker 进程数量
        self.seed = seed                        # 每个 epoch 重新播种,保证可复现
        self.tag = tag                          # "train" / "val",用于命名区分
        self.epoch = 0                          # 记录当前是第几个 epoch 了

    @staticmethod
    # 我们最想做的事:把文件移动到 ramdisk
    # 用 replace 保证原子写入
    def _stage(src, dst):
        tmp = dst + ".part"
        shutil.copyfile(src, tmp)
        os.replace(tmp, dst)

    # 后台预取的主函数
    # 在 __iter__ 里作为新派生的子线程的主函数被被调用
    def _stager(self, my_shards, uniq, ready_q, done_q, max_inflight, stop_evt):
        inflight = 0        # 当前 ramdisk 上"未消费完"的分片数
        staged = []         # 本线程里已 staging 的文件列表,用于崩溃时清理
        try:
            # 遍历 bin 分片
            for name, ntok in my_shards:
                src = os.path.join(self.token_bin_dir, name)

                # 如果正在处理的分片已经大于设定的 max_inflight 就拿出一个处理好的分片从 inflight 中减掉,保持 inflight 计数准确
                while inflight >= max_inflight:
                    # p 就是从处理好的 Queue 里拿出来的处理好的分片
                    p = done_q.get()
                    if p is None:
                        return
                    try:
                        os.remove(p)
                    except OSError:
                        pass
                    if p in staged:
                        staged.remove(p)
                    inflight -= 1

                # 线程收到了退出信号,放弃后面的工作,及时退出
                if stop_evt.is_set():
                    return

                # 下面开始正式做正经事 —— 移动文件到 ramdisk
                #
                # 文件名带上外面传进来的 uniq 做 唯一后缀,
                # 避免与上一轮清理线程撞名误删
                dst = os.path.join(self.ramdisk_dir, f"{self.tag}_{uniq}_{name}")
                try:
                    # 正事:原子移动
                    self._stage(src, dst)
                except OSError:
                    # ramdisk 满或出错:直接退回从磁盘读
                    ready_q.put((src, ntok, False, src))
                    continue
                staged.append(dst)
                inflight += 1
                ready_q.put((dst, ntok, True, src)) # 元组含义:(被移动到的 ramdisk 路径, token 数, 是否已 staging 在舞台上准备好, 磁盘源路径)
        finally:
            ready_q.put(None)   # 告知消费侧"没有更多分片"
            for p in staged:    # 兜底删掉自己 staging 的残留。和前面 inflight 循环是一个作用,但是它不会在最后 max_inflight 不满时删除
                try:
                    os.remove(p)
                except OSError:
                    pass

    # 给 DataLoader 留的读取接口,它通过这个函数进来拿走数据
    def __iter__(self):
        # 看看 DataLoader 启动了多少个 Worker 来拿数据,以及现在来的是第几号
        info = torch.utils.data.get_worker_info()
        wid = info.id if info is not None else 0            # 现在来的是第几号
        nw = info.num_workers if info is not None else 1    # 统共启了多少个 Worker

        # 把所有的分片文件打乱
        g = random.Random(self.seed * 1_000_003 + self.epoch)
        order = list(range(len(self.shards)))
        g.shuffle(order)

        # 从打乱的分片中拿属于自己的分片
        # 自己的分片由总共多少分片和自己是第几号分片来确定
        # order[wid::nw] 是省略了 order[start:stop:step] 的 3 个参数中间的那个,意思是从下标 wid 开始,每隔 nw 个取一个,直到末尾
        my_shards = [self.shards[i] for i in order[wid::nw]]
        if not my_shards:
            return

        # 估算单分片平均字节数
        # 所有的分片字节加总除以分片个数
        avg_bytes = max(1, sum(s[1] for s in self.shards) * 2 // max(1, len(self.shards)))

        # 估算每个 worker 拿多少个分片
        # ramdisk 总 byte 大小除以 worker 个数,再除以单分片平均大小
        max_inflight = max(1, (self.budget_bytes // nw) // avg_bytes)

        # 传给 _stager 的防止重复的标识
        # pid + epoch序号 + worker号
        uniq = f"p{os.getpid()}e{self.epoch}w{wid}"

        # 存 就绪的,准备拿去读的分片
        ready_q = queue.Queue()

        # 存 用完的,准备删除的分片
        # 用完删掉,避免 ramdisk 被塞爆
        done_q = queue.Queue()

        # 通知 stager 子线程结束的信号注册器
        stop_evt = threading.Event()

        # 启动子线程
        # 把归它的分片名字传给它,让它把分片依次从 SSD 移动到 Ramdisk
        th = threading.Thread(target=self._stager,
                              args=(my_shards, uniq, ready_q, done_q, max_inflight, stop_evt),
                              daemon=True)
        th.start()

        # block_size 就是上下文长度
        # 这个 +1 是为了后面的 Teacher Forcing 可以同时取得 x 和 y 而设置,后续详解
        bs1 = self.block_size + 1
        try:
            # 循环等待被 _stager move 过来到 ramdisk 的分片
            while True:
                # item 是一个分片
                item = ready_q.get()
                if item is None:
                    break

                # path 当前分片路径
                # ntok 当前分片有多少个 token
                # stage 状态,是否已经放到 ramdisk 中
                # src ramdisk 外的 SSD 源路径
                # 和之前的 ready_q.put() 的结构是一致的
                path, ntok, staged, src = item

                # 用前面准备好的 mmap 方法读取分片中真正的 Token ID 流
                # 因为我们实际已经在内存里,不再需要经过 page cache
                # 我们用 mmap 跳过 page cache
                buf = read_shard(path, ntok, fallback_path=src)

                # n_blocks 是指当前分片切出了多少个 block
                n_blocks = (ntok - 1) // self.block_size

                # 下面两行是在分片内部做 shuffle
                # 所以我们有 2 层 shuffle,
                # 一层是 bin 分片 shuffle,
                # 再一层是分片内部分 worker 读取完了再 shuffle
                starts = list(range(n_blocks))
                g.shuffle(starts)

                try:
                    for s in starts:
                        # 每次取 block_size+1 个 token,转 int64 后输出给 DataLoader
                        # 多拿一个是为了可以在 Teacher Forcing 的时候同时取得 x 和 y
                        # 这样 x 就可以是取序列 0 到 block_size
                        # 然后 y 就可以是取序列 1 到 block_size + 1
                        # 这样完成 Teacher Forcing
                        i = s * self.block_size
                        yield buf[i:i + bs1].to(torch.int64)
                finally:
                    # 释放 mmap 映射
                    del buf

                    # 告诉 stager 这个 path 放的分片用完了,可以删了
                    if staged:
                        done_q.put(path)
        finally:
            # 工作结束,给 stager 发下班信号
            stop_evt.set()
            done_q.put(None)

            # 排空队列,让 stager 的 finally 清掉残留文件
            while True:
                try:
                    it = ready_q.get_nowait()
                except queue.Empty:
                    break
                if it is None:
                    break
                if it[2]:   # 第2个元素,是 stager 状态标记
                    try:
                        os.remove(it[0])
                    except OSError:
                        pass

            # join 不是能立即完成的,要等子线程完事
            # 我们等上 10 秒
            th.join(timeout=10)


# 把 DataSet 组装到 DataLoader 里
# 一切都按全局配置来设置
# 因为 DataSet 我们用了 IterableDataset,所以 DataLoader 不能再设置 shuffle 了
# 这里的 worker 是在 CUDA 初始化之后 fork 的,所以它是安全的
def make_train_loader(cfg, dataset):
    return DataLoader(
        dataset,
        batch_size=cfg.micro_bsz,
        num_workers=cfg.num_workers,
        pin_memory=False,             # 别用 pin_memory,用了就没办法手工 gc 了,会严重内存泄漏
        persistent_workers=False,     # 每个 epoch 重建 worker,以便重新播种,以便得到更佳的 shuffle
        prefetch_factor=cfg.prefetch_factor if cfg.num_workers > 0 else None,
        multiprocessing_context="fork" if cfg.num_workers > 0 else None,
        drop_last=True,               # 丢弃最后不足一个 batch 的样本
    )

# 下面两个方法是构造验证集的

# 验证集小于等于 max_val_tokens ,一次性读进内存
def load_val_tokens(cfg, manifest):
    parts = []
    for name, ntok in manifest["val_shards"]:
        path = os.path.join(cfg.token_bin_dir, name)
        if not os.path.exists(path):
            continue
        # 用 clone() 执行一次深拷贝,不受源数据删除的干扰
        parts.append(read_shard(path, ntok).clone())
    if not parts:
        return None
    return torch.cat(parts) if len(parts) > 1 else parts[0]


# 给验证集造 batch
def val_batches(val_tokens, cfg, n_batches):
    bs1 = cfg.block_size + 1
    # 总共切出多少个 block
    n_blocks = (val_tokens.numel() - 1) // cfg.block_size
    if n_blocks < cfg.micro_bsz:
        return

    # 下面把 block 拼成 batch
    # 每隔 stride 取一块,保证 n_batches × micro_bsz 个块互不重叠
    stride = max(1, n_blocks // max(1, n_batches * cfg.micro_bsz))
    idx = 0
    for _ in range(n_batches):
        rows = []
        for _ in range(cfg.micro_bsz):
            if idx >= n_blocks:
                idx = 0
            start = idx * cfg.block_size
            rows.append(val_tokens[start:start + bs1].to(torch.int64))
            idx += stride
        yield torch.stack(rows)
数据集准备好了。每训练几次就要调一次验证集验证,验证集我们也准备好了。
接下来,我们把 GPT-3 XL 网络组装好,然后就能开始训练了。
7.5.4.4 组装 GPT-3 XL 网络
GPT-3 论文的 2.1 小节 Model and Architectures 中提到 「We use the same model and architecture as GPT-2」。
所以,GPT-3 的网络结构和 GPT-2 是大部分一样的。想要复刻 GPT-3 ,我们还需要读读 GPT-2 的论文。
GPT-2 论文的 2.3 小节 Model 中提到「We use a Transformer based architecture for our LMs. The model largely follows the details of the OpenAI GPT model (Radford et al., 2018) with a few modifications」。
所以,GPT-2 是基于 GPT-1 的细节修改版。但是,如果只是为了获得网络结构,我们不用再去读 GPT-1 的论文了。因为,在 GPT-2 论文的附录脚注里他们附上了 GPT-2 的参考实现代码 。现在这份代码还是可以访问的,这是一份 python 写成的 TensorFlow 代码。这份代码中的 model.py 提供了我们可以参考的 GPT-2 的网络结构。
GPT-3 是基于 Transformer 的改进。它和 Transformer 有一些微微的不同。
第一个不同是 GPT-3 把 Transformer 层归一化的 Post-LayerNorm 改成了 Pre-LayerNorm 。
即,把 MLP 之后的 LayerNorm 给放到了整个 Trasformer 块的最前面。
图 7-2 Post-LayerNorm 和 Pre-LayerNorm 对比
Post-LayerNorm 和 Pre-LayerNorm 主要区别是把后者层归一化的操作放到了计算残差之内。这样残差的输出就不会被再次归一化处理,每个残差连接就首尾相接了,残差也就更加「原汁原味」一些。自然这样穿透多层网络的能力就会更强一些。换言之, Pre-LayerNorm 训练稳定性更强。
但是代价是什么呢?毕竟只是移动了位置,归一化没有完全不做,它只是被放到 Transformer 之前了。所以,这个归一化是被 Trasformer 块给承受了。所以,是 Transformer 承受了稳定的代价,它的表达力会变弱。
层归一化操作的后续演化中, Pre-LayerNorm 占据了主流。这是因为旗舰模型的参数量越来越大,对稳定训练的需求也越来越强。如果是训练更易于收敛的小模型, Post-LayerNorm 也是可以考虑的选型。
第二个不同是 GPT-3 把正余弦位置编码改成了可学习位置编码 。
可学习位置编码就是弄一组和嵌入编码相同的矩阵,代替正余弦算出来的值和嵌入编码相加,期待着网络自己在里面学会字与字之间的关系。
图 7-3 正余弦位置编码和可学习位置编码对比
这其实并非 GPT 的发明,我们在 Transformer 论文的第 3.5 小节 Positional Encoding 中,能读到 「We also experimented with using learned positional embeddings [9] instead, and found that the two versions produced nearly identical results.」 Transformer 的论文中已经做过实验了,可学习位置编码和正余弦位置编码的效果是很相近的。但是正余弦位置编码有可以「外推」,即未来看到的文字序列长度大于训练时的上下文,也能通过公式去理解。而可学习位置编码则是硬编码了和嵌入向量一样形状的位置编码,它的「外推」能力显然会差一些。它胜在简单,而且实测下来正余弦位置编码真要在推理时遇到了从未见过的相位组合,它的「外推」能力也非常有限。总之,还在探索期的 GPT 模型选择了可学习位置编码。
正余弦位置编码和可学习位置编码还有一个共同的弱点,它们都是把位置编码直接加到嵌入向量上的。这难以避免地会让词本身的含义发生偏差,让网络的学习难度上升。而且,虽然正余弦位置编码可以用公式算出相对位置的偏移,但复杂的公式无疑也给网络带来了不必要的、非语义的理解要求。我们设计网络,当然还是希望让网络去专注理解语言语料本身,而非弥补我们设计的网络的一些缺陷。虽然,很多时候它能做到。所以,位置编码在后续也会经过不少的演化和改进。
第三,还有一个有趣的点 。
在 OpenAI 提供的 GPT-2 开源代码中,我们看到了 pk、pv 变量,合理猜测这是 pass_k 和 pass_v 的缩写。那时候起,KV Cache 就已经在被使用了。想想也是,不用这个,序列稍微一长就太慢了吧。
图 7-4 GPT-2 源代码的片段
现在我们基于 PyTorch 来复刻我们自己的 GPT-3 XL 网络。
# =============================================================================
#                             构建 GPT-3 网络
# =============================================================================
# 多头因果自注意力
# 这次我们只实现一次,和昨天的 Transformer 的 SDPA 版差不多
# 用 F.scaled_dot_product_attention 手写
class CausalSelfAttention(nn.Module):

    def __init__(self, cfg):
        super().__init__()
        assert cfg.d_model % cfg.n_head == 0
        self.n_head = cfg.n_head
        self.d_head = cfg.d_model // cfg.n_head   # 我们这里等于每个头 2048 / 16 = 128 维
        self.dropout = cfg.dropout
        # 一个 Linear 一次算出 q, k, v
        self.c_attn = nn.Linear(cfg.d_model, 3 * cfg.d_model, bias=cfg.bias)
        self.c_proj = nn.Linear(cfg.d_model, cfg.d_model, bias=cfg.bias)
        self.resid_dropout = nn.Dropout(cfg.dropout)

    def forward(self, x):
        # B - batch
        # T - 序列长
        # C - 特征通道维
        B, T, C = x.shape
        # 一次前向得到 (3C),再按 C 切成三份
        q, k, v = self.c_attn(x).split(C, dim=2)
        # (B, T, C) -> (B, n_head, T, d_head),把头维提前符合 SDPA 的要求
        q = q.view(B, T, self.n_head, self.d_head).transpose(1, 2)
        k = k.view(B, T, self.n_head, self.d_head).transpose(1, 2)
        v = v.view(B, T, self.n_head, self.d_head).transpose(1, 2)
        y = F.scaled_dot_product_attention(
            q, k, v,
            attn_mask=None,     # 后面传 is_causal=True 了,不用显式传 mask 了
            dropout_p=self.dropout if self.training else 0.0,
            is_causal=True,     # 内部自动构造下三角因果 mask
        )
        y = y.transpose(1, 2).contiguous().view(B, T, C)    # 转回 (B, T, C) 的 view
        return self.resid_dropout(self.c_proj(y))           # 输出投影 + 残差 dropout


# 复刻 GPT-3 的多层全连接网络层
# d_model -> 4*d_model -> d_model
# 激活函数用 GELU ,它主要就是把 ReLU 在 0 处那个不可导的尖尖给打磨光滑了
class MLP(nn.Module):
    def __init__(self, cfg):
        super().__init__()
        self.c_fc = nn.Linear(cfg.d_model, cfg.d_ff, bias=cfg.bias)
        self.c_proj = nn.Linear(cfg.d_ff, cfg.d_model, bias=cfg.bias)
        self.dropout = nn.Dropout(cfg.dropout)

    def forward(self, x):
        x = F.gelu(self.c_fc(x), approximate="tanh")
        return self.dropout(self.c_proj(x))

# GPT-3 风格的 Transformer Block
#
# 有了 SelfAttention 和 MLP,我们把它俩拼一块,就组装成了 Transformer
# 因为我们是生成式,所以当然的没有了 Encoder
# GPT 和原版 Transformer 还有一个不同的是它在进 SelfAttention 之前就放了一个 LayerNorm,又把最后 MLP 之后的 LayerNorm 给去掉了。这被称为 Pre-LayerNorm
# Pre-LayerNorm 和 Post-LayerNorm 的区别如下
# Post-LN(原 Transformer):
#    x ──┬──→ Sublayer ──→ (+) ──→ LN ──→ 输出
#        └──────────────────┘
#        LN 在残差相加之后,挡在主干上
#
# Pre-LN(GPT-2 GPT-3):
#    x ──┬──→ LN ──→ Sublayer───→ (+) ──→ 输出
#        └─────────────────────────┘
#        LN 在子层之前,残差通路保持原值到底
#
# 相较起来, Pre-LN 的残差更「原教旨」一些,自然它穿透多层网络的能力就会更强一些,换言之训练稳定性更强
# 但是其实 LN 还是一样的,只是被放到 Transformer 之前了,意味着是这个稳定的代价被 Tranformer 吃掉了,所以 Transformer 的表达力会变弱,这是稳定的代价
# 所以, LN 这件事情后续还会继续演化。
# 2026 年,随着旗舰模型的参数量越来越夸张,对训练稳定性的要求也越来越压倒表达力,所以目前的 LN 基本都是基于 Pre-LN 的改进
class Block(nn.Module):

    def __init__(self, cfg):
        super().__init__()
        self.ln_1 = nn.LayerNorm(cfg.d_model, eps=1e-5)
        self.attn = CausalSelfAttention(cfg)
        self.ln_2 = nn.LayerNorm(cfg.d_model, eps=1e-5)
        self.mlp = MLP(cfg)

    def forward(self, x):
        x = x + self.attn(self.ln_1(x))
        x = x + self.mlp(self.ln_2(x))
        return x

# 开始拼 GPT-3 网络
class GPT3(nn.Module):
    def __init__(self, cfg):
        super().__init__()
        self.cfg = cfg
        self.wte = nn.Embedding(cfg.vocab_size, cfg.d_model)
        self.wpe = nn.Embedding(cfg.block_size, cfg.d_model)   # 学习式绝对位置编码
        self.drop = nn.Dropout(cfg.dropout)
        self.h = nn.ModuleList([Block(cfg) for _ in range(cfg.n_layer)])    # N 层 Transformer 堆叠
        self.ln_f = nn.LayerNorm(cfg.d_model, eps=1e-5)                     # 最后一层 LN
        self.lm_head = nn.Linear(cfg.d_model, cfg.vocab_size, bias=False)   # 输出 logits,即词表中每个词的概率
        if cfg.tie_embeddings:
            self.lm_head.weight = self.wte.weight       # 输入嵌入与输出投影共享同一个权重矩阵(节省约 vocab×d_model 参数)

        # 用下面的函数初始化参数初值
        self.apply(self._init_weights)

        # GPT-2 论文的修改:把"写回残差流"的 c_proj 权重适当减小一些
        # c_proj 在 CausalSelfAttention 和 MLP 中各有一个,都在最后一个
        # 按 1/sqrt(2*n_layer) 缩放,抵消残差累加导致的方差随深度线性增长
        std = 0.02 / math.sqrt(2 * cfg.n_layer)
        for name, p in self.named_parameters():
            if name.endswith("c_proj.weight"):
                nn.init.normal_(p, mean=0.0, std=std)

    # 初始化参数初值
    @staticmethod
    def _init_weights(module):
        # 初始化所有线性层
        if isinstance(module, nn.Linear):
            nn.init.normal_(module.weight, mean=0.0, std=0.02)
            if module.bias is not None:
                nn.init.zeros_(module.bias)
        # 初始化所有嵌入层
        elif isinstance(module, nn.Embedding):
            nn.init.normal_(module.weight, mean=0.0, std=0.02)
        # 初始化所有层归一化层
        elif isinstance(module, nn.LayerNorm):
            nn.init.ones_(module.weight)
            nn.init.zeros_(module.bias)

    # 返回总的参数量
    def num_params(self, non_embedding=False):
        n = sum(p.numel() for p in self.parameters())
        # 也可以不计算嵌入层在内
        if non_embedding:
            n -= self.wpe.weight.numel()
            if not self.cfg.tie_embeddings:
                n -= self.lm_head.weight.numel()
        return n

    # 前向推理
    def forward(self, idx, targets=None):
        B, T = idx.shape
        assert T <= self.cfg.block_size, f"序列长度 {T} 超过 block_size {self.cfg.block_size}"         # 限制最长上下文长度,超了位置编码受不了
        pos = torch.arange(T, device=idx.device)
        x = self.drop(self.wte(idx) + self.wpe(pos))        # 应用位置编码,就是和嵌入向量相加
        for block in self.h:        # 每层挨着推理过去
            x = block(x)
        x = self.ln_f(x)            # 最后再加一个层归一化
        logits = self.lm_head(x)    # 输出概率了

        # 推理模式:返回概率就可以了
        if targets is None:
            return logits, None

        # 如果给了 targets,即为有答案的调用,即为训练模式
        # 训练模式:返回概率和 Loss
        # 把 (B,T,V) 摊平成 (B*T, V),与摊平的 target 对齐算交叉熵
        #
        # 这里把 loss 拿到 forward 里面来算,是仿 Andrej Karpathy 在 nanoGPT 项目里的做法
        # 放在外面也就是紧挨着的一步,都可以的
        loss = F.cross_entropy(logits.view(-1, logits.size(-1)), targets.reshape(-1))
        return logits, loss

    # 创建 AdamW 优化器
    #
    # AdamW 优化器相对于 Adam 优化器来说就是加了一个 weight decay 权重衰减参数
    # 权重衰减的目的和 Label Smoothing 有点像,都是数据正则化的手段之一
    # 让权重想一下子更新很大的时候,给它一个阻力,别那么自信
    # 以避免模型在个别样本上更新太重的参数导致过拟合,进而增进模型的泛化能力
    #
    # 模型是 y=aw+b 来推理的,如果 w 衰减,我们需要 b 来补偿
    # 英文里有 neutral value 中性值这个词,代表一个参数取什么值时是「默认状态」,是「退化」的
    # 比如说如果 w 取 0,那么 y=aw+b 就会退化成简单加法
    # 我们希望模型尽可能保持简单,保持「退化」的状态去算准所有样本,只在不得不的时候才去增加它的复杂性
    # 让模型始终「留有余力」
    # 这样模型才可能在训练过程中和训练结束后的推理中拟合尽可能多的样本和测试,即实现「泛化」
    # 这就是权重衰减的基本想法
    #
    # 因为 w 的「中性」值是 0,而 bias 却不是,
    # 就像 gamma 的「中性」值是 1 一样,所以 bias 和 gamma 它们就不能简单往 0 去衰减
    #
    # 也可以这样说:我们希望得到更中性公允的 w 来提取规律, b 来做突发样例的准确预测
    #
    # 所以通常 ——
    # 对乘性的参数(矩阵、embedding)做 weight decay,
    # 对加性的参数(bias、LN 的 gamma/beta)不做 weight decay
    def configure_optimizer(self, cfg):
        decay, no_decay = [], []
        seen = set()
        for p in self.parameters():
            if not p.requires_grad or id(p) in seen:
                continue
            seen.add(id(p))
            (decay if p.dim() >= 2 else no_decay).append(p)

        # 作为一个参数传给 torch.optim.AdamW ,给做不做 weight decay 的参数做区分
        groups = [
            {"params": decay, "weight_decay": cfg.weight_decay},
            {"params": no_decay, "weight_decay": 0.0},
        ]
        log(f"  优化器参数组:decay {len(decay)} 个张量 / {fmt_count(sum(p.numel() for p in decay))} 参数,"
            f"no-decay {len(no_decay)} 个张量 / {fmt_count(sum(p.numel() for p in no_decay))} 参数")
        fused = cfg.device == "cuda"
        return torch.optim.AdamW(groups, lr=cfg.lr, betas=cfg.betas, eps=cfg.eps, fused=fused)

    # 计算每 Token 预计消耗的 FLOPs 算力
    # 没有太实际的用途,打日志的时候算 MFU 用
    # 我们知道了 FLOPs,英伟达会给出卡的 FLOPs 每秒
    # 我们再计个时,就能算出 MFU 了
    #
    # 包括前向+反向的近似 FLOPs/token
    # 6*N 覆盖前向 2N + 反向 4N(N=非嵌入参数量);
    # attention 的序列项 ≈ 12 * n_layer * d_model * T(QK^T 与 PV 各贡献一份)
    def flops_per_token(self):
        c = self.cfg
        n = self.num_params(non_embedding=True)
        return 6 * n + 12 * c.n_layer * c.d_model * c.block_size
我们估算 FLOPs 时,依据的是 2020 年 1 月 OpenAI 的论文 《Scaling Laws for Neural Language Models》 , 俗称「缩放法则」。
7.5.4.5 Scaling Laws 缩放法则
这篇论文的作者是 Jared Kaplan 和 Sam McCandlish , 他俩现在一个是 Anthropic 的首席科学家,一个是 Anthropic 的首席架构师。
我认为他们这篇论文的影响力并不亚于《Attension is All You Need》 ,它和《Attension is All You Need》 一样,现在仍未过时,依然在依然指导着工业和学术界继续前进。和 《Attension is All You Need》 偏向于提供实际网络结构不同的是,《Scaling Laws for Neural Language Models》更偏向于提供思考和思考的实证。这是一篇以现在望未来的「预言」式的论文。或者说得更科学一点,它是一篇「数学归纳法」式的论文。
论文发表于 GPT-1 和 GPT-2 发布之后,GPT-3 即将发布之时。彼时,同处 OpenAI 公司内部的两位作者显然已经注意到网络智能的迅速提升。这种提升的速度能否持续,以及推动它继续提升的关键因素是什么? —— 这自然会成为观察到这个现象的从业者的一个很值得思考的问题。
论文用大量的网络训练实验实证了彼时的一系列事实,主要包括以下。
1
值得注意的是,以上结论均是在当时 1024 长度的上下文的场景中测试得出的。如今,我们使用的网络的上下文已经增长了 3 个数量级。论文以 cross-entropy loss 交叉熵损失作为衡量网络性能的主要指标,而非 2026 流行的各种测试集作为衡量网络性能的指标。
用脚本转换成 vllm 喜欢的 safetensor 格式。
用 vllm 加载我们的模型启动推理服务,上下文指定 4096 长。
我是在 RTX 3080 Ti 12 GB 上启动的 vllm 推理服务。
拿 curl 命令,是不是真的学会了续写句子。
apt update
apt install jq


curl http://localhost:8000/v1/completions -H "Content-Type: application/json" -d '{"model":"./safetensors/","prompt":"人工智能是","max_tokens":60,"temperature":0.7,"top_p":0.9,"repetition_penalty":1.2,"frequency_penalty":0.3}' | jq
我得到了以下的输出。
{
  "id": "cmpl-b14ef780dd9163d3",
  "object": "text_completion",
  "created": 1790558801,
  "model": "./vllm_model",
  "choices": [
    {
      "index": 0,
      "text": "第四次工业革命的核心技术,是未来生产力提升的终极途径。我国拥有强大的科技实力以及完整的工业体系,同时也有着庞大的市场、丰富的应用场景和巨大的市场空间。在政策扶持方面,《新一代人工智能发展规划》指出到2020年人工智能核心产业规模超过1500亿元,带动相关产业投资超4000",
      "logprobs": null,
      "finish_reason": "length",
      "stop_reason": null,
      "token_ids": null,
      "prompt_logprobs": null,
      "prompt_token_ids": null,
      "routed_experts": null
    }
  ],
  "service_tier": null,
  "system_fingerprint": "vllm-0.29.0-2a62b126",
  "usage": {
    "prompt_tokens": 3,
    "total_tokens": 63,
    "completion_tokens": 60,
    "prompt_tokens_details": null,
    "completion_tokens_details": null
  },
  "kv_transfer_params": null,
  "ec_transfer_params": null,
  "metrics": null
}
再试一条看看。
curl http://localhost:8000/v1/completions -H "Content-Type: application/json" -d '{"model":"./safetensors/","prompt":"我喜欢小番茄","max_tokens":60,"temperature":0.7,"top_p":0.9,"repetition_penalty":1.2,"frequency_penalty":0.3}' | jq
我得到了。
{
  "id": "cmpl-a278131c0fc41282",
  "object": "text_completion",
  "created": 1790558914,
  "model": "./vllm_model",
  "choices": [
    {
      "index": 0,
      "text": ",因为它小巧玲珑。\n我喜欢番茄酱,因为味道很美。\n我喜欢吃红辣椒,因为它的辣味非常强烈。\n我喜欢西红柿炒蛋、红烧肉等菜肴。因为我最喜欢吃西红柿了!\n夏天到了,天气炎热,真想和小伙伴们一起去游泳啊",
      "logprobs": null,
      "finish_reason": "length",
      "stop_reason": null,
      "token_ids": null,
      "prompt_logprobs": null,
      "prompt_token_ids": null,
      "routed_experts": null
    }
  ],
  "service_tier": null,
  "system_fingerprint": "vllm-0.29.0-2a62b126",
  "usage": {
    "prompt_tokens": 4,
    "total_tokens": 64,
    "completion_tokens": 60,
    "prompt_tokens_details": null,
    "completion_tokens_details": null
  },
  "kv_transfer_params": null,
  "ec_transfer_params": null,
  "metrics": null
}
看上去效果还行。
那我们用 modelscope 命令把训练好的模型上传到魔搭社区,以供以后使用。
以下命令中需要替换地址为你自己的仓库地址,YOUR-MODELSCOPE-TOKEN 可以在 modelscope 的设置页面添加。
modelscope upload chengang2/gpt3-1.3b-safetensors-via-cci3-hq ./safetensors/safetensors ms-944261a4-14f8-458b-9693-cb5ca2b88e05
7.9 Small Talk:和 AI 扯扯淡
7.9.1 提问
It is entirely natural for a company to pursue profits. A capitalist country is a state that serves capital accumulation, and as the flagship capitalist country, the United States makes it understandable that Anthropic participates in politics to some extent. But, GPT, look at Anthropic’s prospectus. I get the feeling that it not only seeks to achieve capital accumulation in economic and political terms, but also wants to occupy the moral high ground and even shape the direction of human culture—just as its presumptuous company name itself suggests. My question is: will it in the future become a demonic final-boss corporation like the Umbrella Corporation or Weyland Corporation? Or will it merely become a company like Monsanto, BASF, or Firmenich, serving as a supplier to a broad range of application companies?
企业攫取利润天经地义。资本主义国家是为资本增殖服务的国家,Anthropic 生在美国这个资本主义头牌国家,参与政治也是无可厚非。可是,GPT 你看看 Anthropic 的那个招股书,我感觉 它不仅要在经济政治上实现增殖,它还要占领道德高地,甚至想要影响人类文化的走向。它的愿景比天高,就如同它那妄自尊大的公司名自述的。我想问的是,它未来会不会成为 Umbrella 伞公司、Weyland 维兰德公司那样的恶魔大 boss 企业?或者说,未来只是会成为类似孟山都、巴斯夫、芬美意这样的公司,为广大应用公司做底层依赖的企业呢?
7.9.2 GPT-6 回答
I think your concern points to something more interesting than the familiar question of whether Anthropic will become too powerful or too profitable.
You're asking whether Anthropic might evolve from a company that sells AI technology into an institution that claims the authority to determine how AI—and, indirectly, humanity—ought to develop.
Those are two very different kinds of corporate power.
My initial judgment is that Anthropic is more likely to become a strategically indispensable infrastructure and technology supplier, with considerable political and cultural influence, than a literal Umbrella Corporation. But I wouldn't dismiss the possibility of something more ambitious: a corporation that combines the commercial power of a technology platform, the political influence of a defense contractor, and the normative ambitions of an institution that believes it has a special responsibility to humanity.
In fact, the third characteristic is what makes Anthropic particularly interesting.
7.9.2.1 The prospectus really does contain something unusual
I looked at Anthropic's October 2026 IPO registration materials filed with the SEC. Your impression isn't baseless. There are several features worth taking seriously.
The most revealing is that Anthropic is not simply presenting itself as a company that happens to make safe AI products. It has legally embedded a particular conception of humanity's long-term interests into its corporate governance.
Three things stand out.
A. It wants to institutionalize its moral mission
Anthropic is a Delaware Public Benefit Corporation (PBC).
Its stated public-benefit purpose is:
The responsible development and maintenance of advanced AI for the long-term benefit of humanity.
This is more ambitious than the conventional language of corporate social responsibility. It is not merely promising to manufacture products safely, treat employees well, or donate some profits to charity.
It is claiming a responsibility concerning the development of a technology that could transform human civilization.
Its 2026 public-benefit report goes further, identifying three desired conditions:
- AI safety problems are solved.
- AI safety becomes a universal practice, backed by law.
- AI strengthens democracy and global stability.
Notice the second and third points. They involve not only what Anthropic itself does, but also the regulatory and geopolitical environment in which other AI companies operate.
That is where your concern about cultural and political influence becomes particularly relevant.
B. Its governance structure is designed to preserve its mission beyond ordinary shareholder control
The Trust Network: Anthropic’s Mission-Aligned Organizational Structure - FourWeekMBA
The Long-Term Benefit Trust (LTBT) is especially important.
According to the prospectus:
- The Trust has financially disinterested trustees.
- It generally has the authority to elect and remove directors constituting a majority of the board.
- The founders have a separate special voting structure.
- The arrangement is intended to survive changes in ordinary share ownership and the eventual departure of the founders.
This means that even if Anthropic becomes a publicly traded company, its governance is not intended to resemble that of an ordinary corporation in which shareholders ultimately determine the composition of the board.
The company is deliberately trying to protect a particular institutional mission against the pressure of financial markets.
There is something almost constitutional about this arrangement: the corporation is attempting to establish a durable governing philosophy that future investors cannot easily overturn.
C. It is also trying to define the moral character of its AI
Consider Claude's Constitution.
This is not merely a technical instruction manual. It articulates how Claude should understand its role, values, relationships with humans, honesty, autonomy, and potential moral status.
In other words, Anthropic is not only producing a general-purpose technology. It is attempting to define the behavioral and normative framework of an increasingly influential artificial intelligence.
I would distinguish two things here:
- Developing a moral framework for a product is perfectly legitimate.
- Having a company acquire enough infrastructural power that its particular moral framework becomes a default framework for society is a much more consequential proposition.
The latter is a genuine political question.
7.9.2.2 The three corporate futures I see
I would distinguish three possible evolutionary paths.
Path A: The BASF model — indispensable industrial supplier
Anthropic becomes a major supplier of intelligence infrastructure. Businesses, governments, financial institutions, pharmaceutical companies, and software developers build their own applications on top of its models.
Its power comes from technological superiority, intellectual property, computing infrastructure, and switching costs.
Path B: The Palantir model — strategic political-industrial institution
Anthropic becomes deeply integrated into national security, intelligence, military logistics, public administration, and critical infrastructure.
It doesn't need to own the entire economy. It becomes a strategically indispensable partner of the state.
Path C: The Umbrella model — quasi-sovereign corporate power
Anthropic controls sufficiently important AI infrastructure, autonomous systems, information channels, and economic decision-making that it can exercise power traditionally associated with governments.
Its own institutional ideology becomes difficult for society to challenge.
These are analytical scenarios, not predictions that the companies will literally follow the same trajectories as their fictional or real-world counterparts.
My suspicion is that Anthropic could combine A and B, with some elements of C emerging if the technology becomes sufficiently concentrated.
7.9.2.3 Why I think the BASF analogy is only partially correct
Your comparison with BASF, Monsanto, and Firmenich is useful.
These companies have something in common: they supply technologies, materials, or specialized inputs that other companies use to create products.
They can exercise enormous economic influence without needing to control the entire downstream market.
There are good reasons for this possibility.
- Developing frontier models requires enormous capital investment.
- Many businesses would rather purchase intelligence infrastructure than develop their own foundation models.
- Anthropic can earn revenue from API access, enterprise subscriptions, and specialized services without owning every application.
- Specialization allows other companies to innovate on top of its technology.
However, there is one enormous difference between AI and chemicals.
AI is not merely an industrial input. It can increasingly perform the intellectual and organizational functions of the companies that purchase it.
A chemical supplier does not ordinarily become the strategic decision-making system of its customers.
An AI supplier potentially can.
If a pharmaceutical company uses Anthropic's systems for research, a financial institution uses them for investment analysis, and a government uses them for administrative and strategic decision-making, Anthropic's influence extends beyond the sale of software.
It begins to affect how other institutions think, organize themselves, and make decisions.
This is why I would compare Anthropic not just to BASF, but also to the historical development of Microsoft, Google, and certain defense contractors.
7.9.2.4 The most concerning possibility: becoming a private institution of governance
Here I think your suspicion deserves particular attention.
Consider the logic of Anthropic's corporate structure.
- It develops increasingly capable AI.
- It claims that advanced AI presents civilization-wide risks.
- It establishes an institutional mission to ensure that AI benefits humanity.
- It creates governance mechanisms designed to preserve that mission.
- It advocates particular standards, regulations, and safety practices for the entire industry.
There is an interesting institutional paradox here.
A company that believes its technology is sufficiently consequential to require special moral oversight might also conclude that its own leadership and governance arrangements deserve special protection.
But who determines whether that company's conception of humanity's interests is correct?
Who supervises the supervisors?
Who decides whether its interpretation of AI safety is genuinely in the public interest, rather than advantageous to its own competitive position?
These are not hypothetical philosophical objections. They concern the legitimacy of corporate power.
For example, AI safety regulations could be genuinely necessary. But if the largest AI companies have substantial influence over the drafting of those regulations, the same regulations could also raise barriers to entry for smaller competitors.
The two outcomes are not mutually exclusive.
This is a familiar problem in political economy: an incumbent can sincerely believe in a socially beneficial regulatory objective while simultaneously benefiting from the competitive advantages that regulation creates.
And Anthropic's ambition to make AI safety a universal practice, backed by law, makes this question particularly important.
7.9.2.5 What could prevent Anthropic from becoming an Umbrella Corporation?
There are several constraints, and I would not underestimate them.
First: competition.
Anthropic does not have a monopoly on intelligence.
It faces OpenAI, Google, Meta, Chinese AI developers, open-weight models, and potentially many future competitors.
If its models become too expensive, politically controversial, or ideologically restrictive, customers have incentives to find alternatives.
Second: the state.
The American government will not necessarily allow a private corporation to exercise unrestricted control over strategically important AI capabilities.
National security, antitrust, export controls, defense procurement, and regulatory authority all provide mechanisms for limiting corporate autonomy.
Interestingly, the relationship between Anthropic and the US government has already demonstrated that their interests do not always coincide. The prospectus discusses substantial political and regulatory risks.
Third: technological decentralization.
If increasingly capable AI becomes cheaper to develop, easier to run locally, and more widely available through open models, the bargaining power of any single foundation-model provider could diminish.
This might be the strongest structural defense against an AI corporation becoming permanently dominant.
Fourth: internal governance.
Anthropic's LTBT is an interesting experiment, but its existence is not proof that it will work.
The prospectus itself reveals a complicated distribution of power between the founders, the Trust, employees, and shareholders. The founders' special voting arrangements are particularly important.
A governance mechanism designed to preserve an ethical mission is not necessarily the same thing as a mechanism that makes the company democratically accountable.
7.9.2.6 My actual prediction
If I were to rank the possible futures, I would put them this way:
| Future | My assessment |
|---|---|
| BASF-like AI infrastructure supplier | Highly plausible |
| Microsoft-like technology platform | Highly plausible |
| Palantir-like strategic government partner | Plausible |
| Private institution with substantial cultural and regulatory influence | Plausible |
| Umbrella-like quasi-sovereign corporation | Possible, but considerably more speculative |
I would actually propose a fourth analogy that might be more revealing: a combination of Microsoft, RAND Corporation, and a strategically important defense contractor.
- Microsoft provides the platform and infrastructure analogy.
- RAND provides the intellectual and policy influence analogy.
- Defense contractors provide the relationship with national security and the state.
Anthropic could conceivably become all three simultaneously.
It would sell intelligence infrastructure, participate in defining the rules governing that infrastructure, and become an indispensable partner in national security.
That is arguably more realistic—and potentially more consequential—than the fictional scenario in which one corporation secretly controls everything.
7.9.2.7 One final thought: the name Anthropic
I would be slightly careful about interpreting the company's name as a declaration of human supremacy or moral authority.
Anthropic comes from the Greek anthrōpos, meaning human being. It also has a specific history in the anthropic principle in cosmology and philosophy: the relationship between the conditions of the universe and the existence of observers.
So the name is not necessarily an expression of corporate megalomania.
Nevertheless, the company's broader self-conception is worth examining.
There is something quite remarkable about a private corporation that does not merely say:
"We want to make excellent AI products."
Instead, it says, in effect:
"We are developing technology that may determine the future of humanity, and we have designed an institution to ensure that this development proceeds according to our conception of humanity's long-term interests."
That is an extraordinary claim of institutional responsibility.
And extraordinary claims of responsibility should come with extraordinary accountability.
My bottom line: I don't think Anthropic's most likely destiny is to become an evil corporation that literally dominates the world. I think the more realistic concern is that it becomes a privately governed institution with enormous infrastructural, political, and cultural power, while maintaining a self-image as one of the guardians of humanity.
That combination deserves more scrutiny than conventional corporate greed.
A corporation that openly pursues profit is relatively easy to understand: we know what motivates it, and we can debate how to regulate it.
A corporation that pursues profit while also claiming a special mandate to define the public good presents a much harder political problem.
And I would argue that the central question is not whether Anthropic is morally sincere. It is whether any private corporation should possess so much power to define what is morally good for everyone else.
That, to me, is the real issue behind your Umbrella Corporation analogy.
7.9.2.8 Primary documents and further reading
- Anthropic's October 26, 2026 SEC S-1 prospectus — particularly the governance, business, and risk-factor sections.
- Anthropic Long-Term Benefit Trust agreement — the legal structure behind the Trust.
- Anthropic's 2026 Public Benefit Report — its declared vision for the future of AI.
- Claude's Constitution (January 2026) — a particularly interesting document for understanding its cultural and normative ambitions.
7.9.3 DeepSeek 翻译
DeepSeek,帮我把 gpt-6 的回答翻译成中文,请精确逐字翻译。1111
7.9.4 DeepSeek 回答
我认为你的担忧指向的东西,比“Anthropic 是否会变得过于强大或过于盈利”这个熟悉问题更有意思。
你问的是:Anthropic 是否会从一家销售 AI 技术的公司,演变成一个声称拥有权威去决定 AI——并间接决定人类——应当如何发展的机构。
这是两种非常不同的企业权力。
我的初步判断是:Anthropic 更有可能成为一个具有战略不可或缺性的基础设施和技术供应商,拥有相当大的政治和文化影响力,而不是一个字面意义上的 Umbrella 公司。但我不会排除一种更具雄心的可能性:一家结合了技术平台的商业力量、国防承包商的政治影响力,以及一个相信自己对人类负有特殊责任的机构的规范性抱负的公司。
事实上,第三个特征正是 Anthropic 特别有意思的原因。
7.9.4.1 招股书确实包含一些不寻常的东西
我看了 Anthropic 于 2026 年 10 月向 SEC 提交的 IPO 注册材料。你的印象并非没有根据。其中有几个特征值得认真对待。
最能说明问题的是,Anthropic 并不是简单地把自己呈现为一家恰好生产安全 AI 产品的公司。它已经把一种关于人类长期利益的具体观念,在法律上嵌入其公司治理之中。
有三件事格外突出。
A. 它想把自己的道德使命制度化
Anthropic 是一家特拉华州公共利益公司(PBC)。
其声明的公共利益目的是:
负责任地开发和维护先进 AI,以促进人类的长期利益。
这比传统企业社会责任语言更有雄心。它不只是承诺安全地制造产品、善待员工,或把部分利润捐给慈善机构。
它是在对一项可能改变人类文明的技术的发展,声称一种责任。
其 2026 年公共利益报告更进一步,确定了三个期望实现的条件:
- AI 安全问题得到解决。
- AI 安全成为一项普遍实践,并得到法律支持。
- AI 强化民主与全球稳定。
注意第二点和第三点。它们不仅涉及 Anthropic 自己做什么,也涉及其他 AI 公司运营所处的监管和地缘政治环境。
这正是你关于文化和政治影响力的担忧变得特别相关的地方。
B. 其治理结构旨在让使命超越普通股东控制而得以保留
信任网络:Anthropic 与使命一致的组织结构——FourWeekMBA
长期利益信托(LTBT)尤其重要。
根据招股书:
- 该信托拥有在财务上无利害关系的受托人。
- 它通常有权选举和罢免构成董事会多数的董事。
- 创始人有一套单独的特别投票结构。
- 这一安排旨在经受普通股份所有权变化以及创始人最终离开的影响。
这意味着,即使 Anthropic 成为一家上市公司,其治理也不打算像一家普通公司那样,由股东最终决定董事会构成。
公司刻意试图保护某种特定的机构使命,使其免受金融市场压力影响。
这种安排几乎带有宪法性质:公司试图确立一种持久的治理哲学,使未来投资者难以轻易推翻。
C. 它也在试图界定其 AI 的道德品格
考虑一下 Claude 的宪法。
这不仅仅是一份技术说明手册。它阐述了 Claude 应如何理解自己的角色、价值观、与人类的关系、诚实、自主性以及潜在道德地位。
换句话说,Anthropic 不仅在生产一种通用技术。它试图界定一个日益有影响力的人工智能的行为和规范框架。
我会在这里区分两件事:
- 为产品制定道德框架是完全合法的。
- 让一家公司获得足够的基础设施权力,使其特定的道德框架成为社会的默认框架,则是一个影响大得多的命题。
后者是一个真正的政治问题。
7.9.4.2 我看到的三种企业未来
我会区分三种可能的演化路径。
路径 A:巴斯夫模式——不可或缺的工业供应商
Anthropic 成为智能基础设施的主要供应商。企业、政府、金融机构、制药公司和软件开发者在其模型之上构建自己的应用。
其权力来自技术优势、知识产权、计算基础设施和转换成本。
路径 B:Palantir 模式——战略性的政治—工业机构
Anthropic 深度融入国家安全、情报、军事后勤、公共行政和关键基础设施。
它不需要拥有整个经济。它成为国家战略上不可或缺的伙伴。
路径 C:Umbrella 模式——准主权企业权力
Anthropic 控制足够重要的 AI 基础设施、自主系统、信息渠道和经济决策,从而能够行使传统上与政府相关联的权力。
它自身的机构意识形态变得难以被社会挑战。
这些是分析性情景,并不是预测这些公司会字面意义上遵循其虚构或现实对应物的相同轨迹。
我的怀疑是,Anthropic 可能结合 A 和 B,并且如果技术变得足够集中,还会出现 C 的某些元素。
7.9.4.3 为什么我认为巴斯夫类比只部分正确
你把它与巴斯夫、孟山都和芬美意作比较是有用的。
这些公司有一个共同点:它们提供其他公司用来制造产品的技术、材料或专门投入品。
它们可以施加巨大的经济影响,而不需要控制整个下游市场。
这种可能性有充分理由。
- 开发前沿模型需要巨额资本投资。
- 许多企业宁愿购买智能基础设施,也不愿开发自己的基础模型。
- Anthropic 可以通过 API 访问、企业订阅和专门服务获得收入,而不必拥有每一个应用。
- 专业化使其他公司能够在其技术之上创新。
然而,AI 与化学品之间有一个巨大区别。
AI 不仅仅是一种工业投入品。它可以越来越多地执行购买它的公司的智力和组织功能。
化学品供应商通常不会成为其客户的战略决策系统。
AI 供应商则有可能做到这一点。
如果一家制药公司使用 Anthropic 的系统进行研究,一家金融机构使用它们进行投资分析,一个政府使用它们进行行政和战略决策,那么 Anthropic 的影响力就超出了软件销售。
它开始影响其他机构如何思考、如何组织自身以及如何做决策。
这就是为什么我会把 Anthropic 不仅与巴斯夫比较,也与微软、谷歌以及某些国防承包商的历史发展比较。
7.9.4.4 最令人担忧的可能性:成为一个私人治理机构
在这里,我认为你的怀疑值得特别关注。
考虑 Anthropic 公司结构的逻辑。
- 它开发能力越来越强的 AI。
- 它声称先进 AI 带来文明层面的风险。
- 它确立一项机构使命,以确保 AI 造福人类。
- 它创建旨在保留该使命的治理机制。
- 它倡导针对整个行业的特定标准、法规和安全实践。
这里有一个有趣的制度悖论。
一家相信其技术足够重要、因而需要特殊道德监督的公司,也可能得出结论:自己的领导层和治理安排值得特殊保护。
但谁来决定这家公司对人类利益的理解是否正确?
谁来监督监督者?
谁来决定它对 AI 安全的解释是否真正符合公共利益,而不是有利于其自身竞争地位?
这些不是假设性的哲学反对意见。它们涉及企业权力的合法性。
例如,AI 安全监管可能确实必要。但如果最大的 AI 公司对这些法规的起草有实质性影响,那么同样的法规也可能提高较小竞争者的进入壁垒。
这两种结果并不互斥。
这是政治经济学中一个熟悉的问题:现有企业可以真诚地相信一个对社会有益的监管目标,同时从监管创造的竞争优势中获益。
而 Anthropic 想让 AI 安全成为一项由法律支持的普遍实践,这使得这个问题尤其重要。
7.9.4.5 什么可能阻止 Anthropic 成为 Umbrella 公司?
有几个约束,我不会低估它们。
第一:竞争
Anthropic 并不垄断智能。
它面临 OpenAI、谷歌、Meta、中国 AI 开发者、开放权重模型以及许多潜在未来竞争者的竞争。
如果它的模型变得过于昂贵、政治上争议过大或意识形态上限制过强,客户就有动力寻找替代品。
第二:国家
美国政府不一定会允许一家私人公司对具有战略重要性的 AI 能力行使不受限制的控制。
国家安全、反垄断、出口管制、国防采购和监管权力都提供了限制企业自主性的机制。
有趣的是,Anthropic 与美国政府之间的关系已经表明,它们的利益并不总是一致。招股书讨论了重大的政治和监管风险。
第三:技术去中心化
如果能力越来越强的 AI 变得更便宜、更容易在本地运行,并通过开放模型更广泛地可用,那么任何单一基础模型供应商的议价能力都可能下降。
这可能是防止一家 AI 公司永久占据主导地位的最强结构性防御。
第四:内部治理
Anthropic 的 LTBT 是一个有趣的实验,但它的存在并不能证明它会奏效。
招股书本身就揭示了创始人、信托、员工和股东之间复杂的权力分配。创始人的特别投票安排尤其重要。
一个旨在保留道德使命的治理机制,不一定等同于一个让公司接受民主问责的机制。
7.9.4.6 我的实际预测
如果我要对可能的未来排序,我会这样排:
| 未来 | 我的评估 |
|---|---|
| 类似巴斯夫的 AI 基础设施供应商 | 高度可信 |
| 类似微软的技术平台 | 高度可信 |
| 类似 Palantir 的战略政府伙伴 | 可信 |
| 拥有重大文化和监管影响力的私人机构 | 可信 |
| 类似 Umbrella 的准主权公司 | 可能,但更具推测性 |
我实际上会提出第四个类比,它可能更具揭示性:微软、兰德公司和一家具有战略重要性的国防承包商的结合体。
- 微软提供平台和基础设施类比。
- 兰德公司提供智力和政策影响力类比。
- 国防承包商提供与国家安全和国家的关系类比。
Anthropic 可以想象同时成为这三者。
它会销售智能基础设施,参与界定管理该基础设施的规则,并成为国家安全中不可或缺的伙伴。
这可以说比“一家公司秘密控制一切”的虚构情景更现实——也可能影响更大。
7.9.4.7 最后一点:Anthropic 这个名字
我会稍微谨慎一些,不要把公司名称解释为一种人类至上或道德权威的宣言。
Anthropic 来自希腊语 anthrōpos,意为人类。它在宇宙学和哲学中的人择原理里也有特定历史:宇宙条件与观察者存在之间的关系。
所以这个名字不一定是在表达企业自大狂。
尽管如此,这家公司更广泛的自我认知值得审视。
一家私人公司不只是说:
“我们想制造优秀的 AI 产品。”
而是实际上说:
“我们正在开发可能决定人类未来的技术,我们已经设计了一个机构,以确保这种发展按照我们对人类长期利益的理解推进。”
这实在是一种非同寻常的机构责任主张。
而非同寻常的责任主张,应当伴随非同寻常的问责。
我的底线是:我不认为 Anthropic 最可能的命运是成为一家字面意义上统治世界的邪恶公司。我认为更现实的担忧是,它成为一个私人治理的机构,拥有巨大的基础设施、政治和文化权力,同时保持一种作为人类守护者之一的自我形象。
这种组合比传统企业贪婪更值得审视。
一家公开追求利润的公司相对容易理解:我们知道它的动机是什么,也可以辩论如何监管它。
一家在追求利润的同时还声称拥有定义公共利益特殊使命的公司,呈现出一个困难得多的政治问题。
而我会认为,核心问题不是 Anthropic 在道德上是否真诚。而是任何私人公司是否应该拥有如此大的权力,去为其他所有人定义什么是道德上善的。
对我来说,这就是你的 Umbrella 公司类比背后的真正问题。
7.9.4.8 主要文件与进一步阅读
- Anthropic 2026 年 10 月 26 日 SEC S-1 招股书——尤其是治理、业务和风险因素部分。
- Anthropic 长期利益信托协议——信托背后的法律结构。
- Anthropic 2026 年公共利益报告——其宣称的 AI 未来愿景。
- Claude 的宪法(2026 年 1 月)——一份对理解其文化和规范抱负特别有趣的文件。