第 6 天 Attention is All You Need
它的伟大无需多言,今天我们以它为名 —— 《Attention is All You Need》。
不得不尊敬它划时代的开创性和巨大的影响力。它用一套架构把所有问题一扫而空,开创性地同时满足了「All You」的「All Need」。
6.1 新时代的引言
论文的引言部分完美接驳我们昨天的工作。
开篇如此说道。
Recurrent models typically factor computation along the symbol positions of the input and output sequences. Aligning the positions to steps in computation time, they generate a sequence of hidden states ht, as a function of the previous hidden state ht−1 and the input for position t. This inherently sequential nature precludes parallelization within training examples, which becomes critical at longer sequence lengths, as memory constraints limit batching across examples. Recent work has achieved significant improvements in computational efficiency through factorization tricks [18] and conditional computation [26], while also improving model performance in case of the latter. The fundamental constraint of sequential computation, however, remains.
RNN 会顺序生成一系列的隐状态,这种顺序性质使得它难以并行化。有一些研究提升了它的效率,但是并没有改变它顺序计算的本质。
Recurrent neural networks, long short-term memory [12] and gated recurrent [7] neural networks in particular, have been firmly established as state of the art approaches in sequence modeling and transduction problems such as language modeling and machine translation [29, 2, 5]. Numerous efforts have since continued to push the boundaries of recurrent language models and encoder-decoder architectures.
RNN、LSTM、GRU 已经是目前解决序列和翻译问题的最好方案,继而 RNN 又发展出了编码器-解码器架构。
看,当时它面临的情况正是我们当前的进展。
今天,我们一起来欣赏这篇创造了 Transformer 的论文,划分新旧时代的《Attention is All You Need》。
6.2 新的问题:钱太多!
昨天,我们构建 RNN 循环神经网络,引入隐变量,让神经网络学着从信息中去芜存菁,学会了所谓「思考」。
RNN 完成了任务,但仍非完美。当世界首富、世界最著名风险投资机构的总裁和世界第一的互联网科技企业一起带着天量的资金进入这个领域,一切都变了……
RNN 的隐变量已经触及到了「思考」的核心,但相较于 OpenAI 的 10 亿美元投资、Google 招募的人才级别和 Google 海量的数据,它「思考」地还是太慢。彼时,深度学习已经度过了它最后一段黑暗时期,现在的它正处于疯狂的生长期,它需要一具能够快速吃掉数据、快速消耗算力、快速花光美刀的新身体。
我在虎嗅网上读到一个很有趣的说法,说现如今大模型就是 150 年前的美国铁路狂潮 —— 资本疯狂加煤,前面一群工程师们疯狂地铺铁轨。 有趣的是,这两次浪潮中,华人都扮演着重要角色。 和 150 年前不同的是,这次的资本是坐在火车上加煤。
6.3 新问题之二:多义词怎么办?
之前,我们通过 Embedding 让网络学会理解词义,它已经能知道苹果和梨是意思相近的词了。
可还有问题 —— 「苹果很甜」和「苹果手机」里的「苹果」不是一个意思。
无视上下文地无脑把「苹果」放在「梨」的旁边怕是不太行啊。有时候也得把「苹果」放在「小米手机」的「小米」旁。
这「苹果」一会儿是水果,一会儿又是手机,一个词拥有好几种完全不相干的意思。这就是所谓的 multi-sense word embeddings 多义词向量。
咋办呢?
两种思路。比较直接的思路是,就让「苹果」有 多个向量表示。这种思路的难点在于所谓的「词义消歧」word-sense disambiguation,即拥有了多种表示之后如何选到最合适的那个。挖坑容易,填坑难呐。
另一种思路是使用动态的词向量。让「苹果」和它周围的词去计算,算出它在当前句子中合适的向量表示。这种思路的难点在于 —— 我如何知道「苹果」该和句子里的哪个词算呢?如果是和每个词都算,那么整个句子的计算复杂度岂非是 \(\mathcal{O}(n^2)\) ?那我让它读一篇《活着》岂不是要起飞?
6.4 新问题之三:长距离依赖
RNN 读文章有点像我们人,从前往后顺着读。它也和人一样有「读了后面忘了前面」的毛病。RNN 一旦循环起来就好像一群人在玩「传话游戏」,虽然后面的人能听到上一个人的转述,但却没办法去看看原话是怎么说的。当这个链条变长,信息经过长距离传递,往往就面目全非了。
这就是所谓的「长距离依赖」 Long-Range Dependencies 问题。RNN 的隐变量像是一个不大的箱子。每循环一步,它就要把信息压缩一下,塞进这个箱子。塞到最后,最前面的信息往往已经被压得模糊不清了。麻烦在于,我们常常又需要最前面的信息。
比如说下面这个长句。
这个人打扮与众姑娘不同,彩绣辉煌,恍若神妃仙子:头上戴着金丝八宝攒珠髻,绾着朝阳五凤挂珠钗;项上戴着赤金盘螭璎珞圈;裙边系着豆绿宫绦,双衡比目玫瑰佩;身上穿着缕金百蝶穿花大红洋缎窄褃袄,外罩五彩刻丝石青银鼠褂;下着翡翠撒花洋绉裙。一双丹凤三角眼,两弯柳叶吊梢眉,身量苗条,体格风骚,粉面含春威不露,丹唇未启笑先闻。黛玉连忙起身接见。贾母笑道:“你不认得他,他是我们这里有名的一个泼皮破落户儿,南省俗谓作‘辣子’,你只叫他‘凤辣子’就是了。”
如果顺着读,那么直到结尾,我们才能知道开头的「这个人」指代的是「凤辣子」。可此时,我们的隐变量经过了太多迭代,可能已经无力去变更最前面的表示了。
总的来说,RNN 缺乏并行能力,缺乏多义词理解能力,还缺乏一种「回眸」的能力 —— 一种在处理当前词时,直接关联到遥远上下文的能力。
6.5 新的解:注意力机制
2017 年 6 月时,这些问题都已经被研究者们观察到,并且都已经在处理了。
比如说,用更方便 GPU 处理的卷积来改善 RNN 难以并行计算的问题。
比如说,2014 年,加拿大蒙特利尔大学的 Dzmitry Bahdanau 和 Kyunghyun Cho、Yoshua Bengio 共同了提出的 Bahdanau 注意力机制。Dzmitry Bahdanau 现在是 CIFAR 的主席。
图 6-1 Dzmitry Bahdanau
Bahdanau 注意力机制让 RNN 可以在输出时访问输入序列,这样就能减弱隐变量压缩失真的影响。
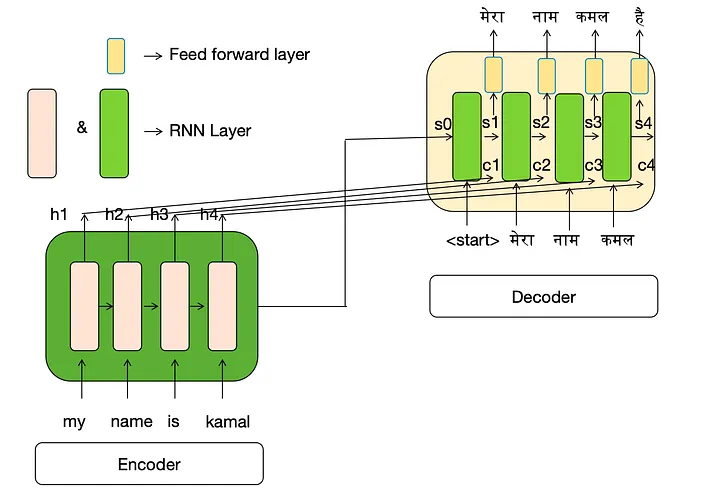
图 6-2 Bahdanau 注意力
2017 年 6 月,Altman 的 OpenAI 创立 1 年有余,Google 的 Google Brain 已经 5 岁了。是时,Ashish Vaswani、Noam Shazeer、Niki Parmar、Jakob Uszkoreit、Llion Jones、Aidan N. Gomez、Łukasz Kaiser、Illia Polosukhin 把 《Attention is All You Need》上传了 arXiv。
当年 12 月, 《Attention is All You Need》 在 NIPS 正式发表。该论文开创性地提出,神经网络可以完全不使用循环结构和卷积,仅使用注意力机制来完成对词的理解。
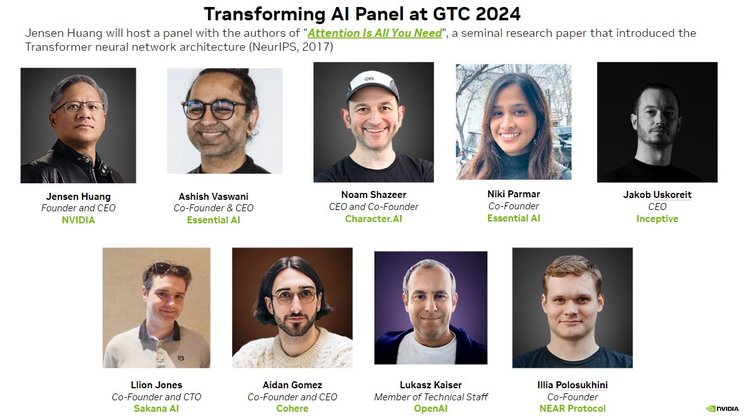
图 6-3 《Attention is All You Need》的作者们
加州的那个夏天,Google Brain 的天才们给这列飞驰的火车狠狠地铺上了一段新的铁轨。
6.5.1 「自」注意力
自注意力机制的「自」意思是 —— 它关注的是序列自身。
和 Bahdanau 那种注意力的区别在于,「自」注意力机制评估的是同一个序列内部各个词的关系,而非计算输入序列和输出这样两个不同的序列间的关系。
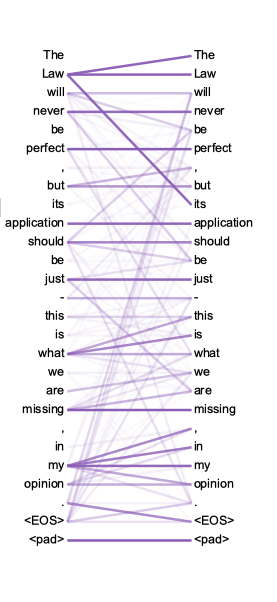
图 6-4 「自」注意力
他们发现,句子中的特定词可以直接固定多义词的意思。
比如,如果后面是「手机」这个词,那么「苹果」就肯定不是水果了。
注意力机制让词能在更小的局部范围里,直接参考相关词来调整自己的意思,而不需要隐变量里压缩的整篇文章的内容。
昨天我们引入的 Embedding 层 —— 用向量来表示词的这种做法,恰好为这种调整提供了极大的便利。
既然词义本身就是一个浮点数数组,那么改变它的意思无非把一个数值映射成另一个数值。
而所谓「映射」,其实无非是各种向量计算,只要是相同维度的向量进向量出的就行。这种向量运算天然可微、天然可学习、天然适合交给 GPU。
我们来举个最简单的例子,来说明如何通过向量映射来实现对语言的「理解」。
我们假设一个语言只有「水果的甜度」和「手机的品牌」这两个意义的维度。
| 维度 | 语义 | 值高 | 值低 |
|---|---|---|---|
| 第 1 维 | 水果甜度 | 能吃、有甜度 | 与水果无关 |
| 第 2 维 | 手机品牌 | 能打电话、有股价 | 与手机无关 |
表 6-1 一种只有 2 个意思维度的语言
我们把「苹果」这个词放到这个语言里,给它一个模棱两可的初始向量表示 [0.5, 0.5]。
现在,我们希望「苹果」这个词在不同的上下文里会被「理解」成不同的意思,即变成不同样子的向量。
| 上下文 | 输入向量 | 期待的输出向量 |
|---|---|---|
| 你的这个苹果很甜 | [0.5, 0.5] | [0.9, 0.1] |
| 苹果发布了新手机 | [0.5, 0.5] | [0.1, 0.9] |
表 6-2 同一个「苹果」在不同的上下文里有不同的意思
就像上表这样。这样,我们明确了向量的输入和我们期待的的输出向量。
那么,怎么能做到从输入向量到输出向量的转换呢?从一个向量怎么变成另一个向量?
假如「甜」的向量是下面这样。
式 6-1 假设「甜」的向量表示
那么,我们可以用「甜」去理解「苹果」。
式 6-2 有「甜」时「苹果」的向量表示
假如「手机」的向量是下面这样。
式 6-3 假设「手机」的向量表示
那么,用「手机」去理解的「苹果」就会变成这样。
式 6-4 有「手机」时「苹果」的向量表示
这样,我们就实现了同一个「苹果」在不同的上下文中表达不同的意思。并且这种「理解」是输入序列独自完成的。
当然,我们的例子极度简化了注意力的工作机制。
真像我们这样做的话,会有一些妨碍网络收敛的问题。比如说对称性问题 —— 因为加法满足交换律的缘故,「苹果」很关注「甜」,那么「甜」就一定会很关注「苹果」。
但在语言中,关系往往不是对称的。「苹果」很需要去关注「甜」,因为那是它的属性。但「甜」可能并不需要太去关注「苹果」,它还可能去形容「甜妹子」之类别的词。
所以,我们希望有一种计算注意力的方式,它是不对称的。
6.5.2 Q 和 K
《Attention is All You Need》首先搞出了用 Q、K、V 这种计算注意力的方式,创造性地解决了这个问题。他们给这种计算注意力的方式起名叫「缩放点积注意力」。
首先,它通过 \(W_q, W_k, W_v\) 三个可学习的权重矩阵,把每一个 Token 都变成 3 个表达 —— Query、Key、Value。
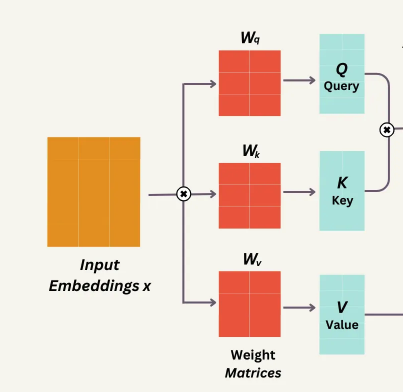
图 6-5 QKV 让每个词都一变三
\(W_q, W_k, W_v\) 这三个矩阵在本质上没有什么区别,由于上图中它们位置的不同,它们在神经网络的训练中会自然地学会不同用途。和之前一样,可微编程。
有了 \(Q, K, V\) 之后,我们就不用 Token 本身的 Embedding 去计算注意力了。我们用当前词的 \(Q\) 和每一个词的 \(K\) 去计算出「注意力评分」。因为查询词和被查询词分别被变换成了 \(Q\) 和 \(K\),所以这种机制避免了「苹果」关注「甜」的时候,「甜」就必须很关注「甜」。
岔开说一句,总是说「关注」,感觉很别扭。一个「词」怎么会去「关注」另一个「词」呢?很荒谬啊……
但大家都用这个词。而且更关键的是,我确实没有找到更合适的词去表达「attention」这个英文词。但是我觉得在这里有必要澄清一下这个英文词的原意,或者说是我对它的理解。
attention 应该是拆成 at·ten·tion。其中 at 是「加强」的意思,tion 是名词后缀,这俩都没啥好说的。最关键就是中间这个 ten。ten 这个词根是表达「拉拽」的意思。
比如说,ten·d 倾向,意思其实就是「被人拉拽过去了」,所以具备了某种倾向。
ex·ten·d 延长,就是搭配 ex 这个表示「向外」的词根,被拉长了嘛。
ten·sion,拉拽的名词形式,被拽住了的状态,张力嘛。
所以说,attention 我的理解其实是说一个词被另一个词「拉拽」,导致它变形了。虽然自己还是自己,核心没变,本质没变,但是外形变成了别的模样。
希望这番解释能帮助大家理解所谓「注意力机制」,如果谁更有好的中文翻译也请告诉我。
在那之前呢,我们还继续使用「关注」这个词,我们知道意思就好。
回到正题。所以这种机制避免了「苹果」关注「甜」的时候,「甜」就必须很关注「甜」。因为 \(Q\) 和 \(K\) 已经被分成了不同的表示。
式 6-5 为什么 Q 和 K 要分开计算
找出一个词是「苹果」的 Soul Mate,就是一个索引查找操作。平常我们都是同态查找,用串找子串,在树里找 node ,在空间里找向量嘛。
为什么 Transformer 里要把 \(Q\) 和 \(K\) 费这么大力特地给变个态,这就是原因。
忍不住又想岔出去一句 —— 好像谈恋爱也是变态查找啊,谁给设计的啊?难怪这世间这么多求不得、爱别离。
6.5.3 K 和 V
那么,\(K\) 和 \(V\) 为什么也要不同呢?
我们看看 Transformer 创造的这个「缩放点积注意力」长什么样子。
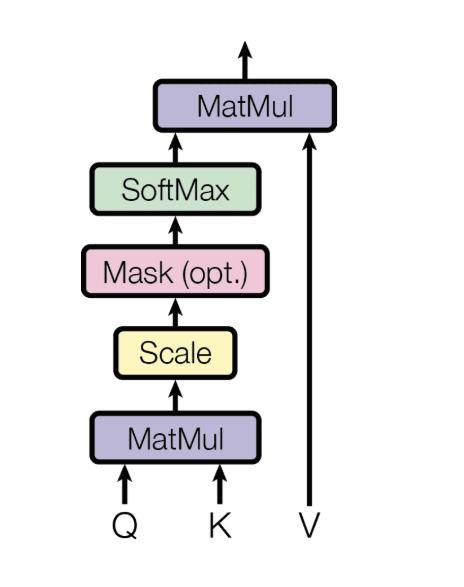
图 6-6 QKV 和缩放点积注意力
可以看到。Q 和 K 计算完注意力之后,用 softmax 得出一个每个词对当前词的「影响力」大小。然后 \(V\) 用来干什么了呢?
一个乘法 —— \(V\) 按照这个影响力的比例加到这个词的新表示中了。
所以,\(Q\) 和 \(K\) 的任务是得出「掺多少」,而 \(V\) 的负责保存每个词的实际含义。
如果说注意力是对词的调酒,那么 \(Q\) 和 \(K\) 的任务是得出 50ml,\(V\) 则负责保存朗姆酒的味道。它们是不同的任务。
所以,虽然 \(K\) 和 \(V\) 来自同一个词,最好还是用两个不同的权重矩阵 \(W_q\) 和 \(W_k\) 。让神经网络有学习的空间,去让一个词变形成不同的样子以达成不同的任务。
6.5.4 缩放点积注意力
有了 \(Q, K, V\) 之后,我们就可以对一个词进行「注意」,去获取它在这句子里准确的表达了。
所谓「注意」的结果,就是综合这一整句里所有词的含义,确定每个词的含义应该占到当前词的百分之多少。然后按比例给这些词掺到一起,就是当前词「注意」后的结果。
所以,注意力机制要完成 2 件事。
- 确定每个词的比例;
- 按比例掺词;
1 份伏特加、1 份金酒、1 份龙舌兰、1 份白色朗姆酒、1 份君度、1 份柠檬汁,4 份冰可乐
把各种基酒按比例倒到雪克杯里,Shake Shake ~ 最后用可乐补满 ~
Transformer 是这样做这件事的。
式 6-6 缩放点积注意力
这个式子和上面的图都来自于《Attention Is All You Need》论文的第 3.2 小节。它俩是等价的。
我们倒着往回看。
最后一步是乘法,图形是最上面的部分,式子是最右侧。乘数是 \(V\), \(V\) 里装的是词语原意,所以这一步就是「按比例掺」。这很好理解。
往前,被乘数是一个 softmax() 的输出。 softmax() 是老朋友了,它把一系列浮点数转化为维度不变的另一堆浮点数,后者的和为 1。所以,它就是做了一个特殊的归一化工作,保证我们的酒单最后调出来的是「一杯」酒。换言之,它把上一步并行计算出来的「分数」,归一化成了对于当前词的「权重」。
现在这个式子拆得差不多了,就剩 softmax() 括号里的内容了。但是我们这个「缩放点积注意力」还没讲到「缩放」,也没讲到「点积」。
分数线上面的就是「点积」。
点积是一个输入为矩阵,输出为标量的操作。因为我们的目标是在 2 个向量之间计算一个注意力「分数」,点积相当适合。
观察论文中的图示,我们可以看到中的 \(Q\) 和 \(K\) 之前用的是 MatMul 矩阵相乘,而不是 dot 点积。这是为什么呢?
观察式子,我们可以发现, \(Q\) 乘以了 \(K\) 的转置。
式 6-7 Q 乘以 K 的转置
因为 \(Q\) 和 \(K\) 都是一维数组,转置后再相乘,效果和点积是等价的。
但是未来我们不会一个词一个词算。我们用 GPU,肯定一次性把一堆 \(Q\) 和一堆 \(K\) 都一起给算出来。
式 6-8 一堆 Q 乘以一堆 K 的转置
所以,综合考虑下来,还是矩阵相乘更合适些。
分数线下面的是「缩放」。
观察式子,我们可以发现 \(Q\) 和 \(K\) 积了之后除以了一个 \(\sqrt{d_k}\)。
这里的 \({d_k}\) 是指 \(Q\) 和 \(K\) 的向量维度。
点积是把矩阵中对应位置的值相乘然后相加,所以向量维度越多,点积的值就越大。维度一高,分数之间就拉得特别开,大的极大,小的极小。
而两个词之间的「注意力分数」是不是和向量维度有关呢?
有关的。理论上,维度越多,分数应该越精确。有关,但绝不是和维度成这样一个线性的关系。
所以,这里维度数量是一个「多余」的维度。
出于工程考虑,也是这样的。这会给后面的 softmax() 带来麻烦。softmax() 碰到极大的数,输出就会非常接近 1,其他的全被挤到 0 附近,变成非此即彼的硬注意力。这不但让模型很难关注到多个词的信息,还会让梯度变得极小,训练推不动。
我们应该在此时就做「归一化」的工作。以免这份误解继续向后传递。
换言之,我们不希望算完「注意力分数」之后,数据的分布发生变化。
算「分数」之前, \(Q\) 和 \(K\) 被初始化成了方差为 1 的随机数。
式 6-9 方差求和展开
我们的 \(Q\) 和 \(K\) 都是独立变量,所以协方差为 0。 那么,d 个 \(Q\) 和 \(K\) 相加,方差为 \(d\)。
考虑到方差是平方求和。
式 6-10 方差归一化
我们除以 \(\sqrt{d_k}\),就能够把数值分布的方差重新拉回 1。
综上所述,缩放点积注意力其实就是:
-
用点积给每对词打出一个原始的重要性分数;
-
除以 \(\sqrt{d_k}\) 让分数稳定,不让模型只看一个词;
-
用
softmax()把注意力「分数」转成和为 1 的注意力「权重」; -
最后拿这些权重,把 \(V\) 里的词按比例摇匀,得到当前词融入上下文后的最终表示。
这就是 Transformer 的「缩放点积注意力」,它帮我们完成了每个词的「调酒」工作。
6.5.5 因果注意力
现在,我们利用注意力可以理解一整句话了。
但是现代的大模型,尤其是预训练阶段的大模型,往往不是用一句话去预测另一句话。就像昨天我们训练的《活着》一样,它是用半句话去预测下一个词。
这也是为什么有的材料里把现代这些大模型称为「因果模型」。我们看 Qwen、Llama、DeepSeek 的源代码能观察到,它们的推理类都被命名为 XXXForCausalLM。LM 是大模型的意思,前面的 Causal 就是所谓因果。
这里的「因果」不是逻辑学里的因果,它说的是时间上的先后:先有因,后有果。模型根据已经出现的上文去推下文,不能由未来的「果」反推现在的「因」。
要让模型习得这种能力,我们就得在训练它时,只让它看见准备让它预测的词之前的词。而不能看见未来的词。
举个例子,训练这个句子「今天 天气 真 好」,我们的目标就是。
「今天」只能看到「今天」;
「天气」只能看到「今天」「天气」;
「真」只能看到「今天」「天气」「真」;
「好」只能看到「今天」「天气」「真」「好」。
具体来说,我们用注意力机制算出注意力权重之后,需要把当前词之后的词的概率全都改为不可能出现。
式 6-11 因果注意力
意即,当前词的注意力分数不变,之后所有词的分数全加一个负无穷,变成负无穷。
为了便于 GPU 并行计算,我们创建一个掩码矩阵。
式 6-12 因果注意力掩码矩阵
这样,如果之前的注意力权重,归一化之后是这样的话。
式 6-13 因果注意力之前的注意力权重
那么,掩码之后就变成。
式 6-14 用掩码矩阵并行计算因果注意力权重
\(e^{-\infty} = 0\),负无穷在 softmax() 之后就是 0。这样,我们就并行算出了因果注意力权重。
因为它经常被这样掩码实现,因果注意力也常常被称为 Mask 注意力。
这样就达成了我们的目的,只让网络看当前词之前的词,再结合 Teach Forcing 去算 Loss。理论上,我们这样就能训练出一个能预测下一个词的神经网络。
6.5.6 多头注意力
对于经历过卷积神经网络的我们来说,理解多头注意力只需要一句话 —— 注意力头就是卷积核。
下图是论文中 3.2 节中的多头注意力示意图。
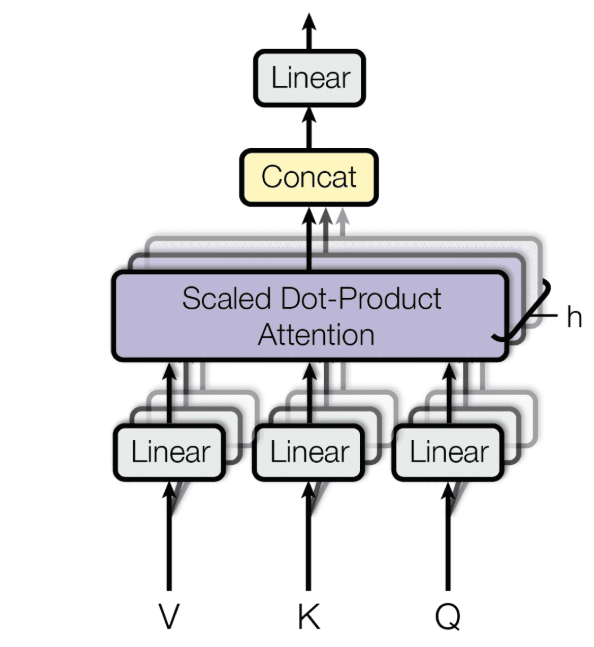
图 6-7 多头注意力
注意看图中标注 \(h\) 的地方。它就是整了多个同构的缩放点积注意力去计算词的注意力。
就和卷积神经网络中使用多个卷积核的想法是一样的 —— 希望网络学会从多个不同的侧面去理解词与词之间的关系。
每个所谓的头部都是一个独立的注意力网络。卷积神经网络中可能有的核关注的是红色,有的核关注的是绿色,有的核关注的是边缘,有的核关注的是阴影。类似的,多头注意力里可能有的头在理解主谓宾,有的头在理解名动形状,有的头在理解指代关系,有的头在总结全文。
当然,这些主要都是比喻。我们要强调的是,随着头数的增加,它的理解角度在增多,并不是说它真的关注这些角度。实际它关注的角度是什么,要看数据集里存在什么模式了,不同的语言肯定也不完全相同,这些我们并不真的知道。这些理解更多是一种事后解释,实际分工是模型在训练中自动形成的。
一个问题,卷积神经网络中是靠不同核的不同形状让神经网络学会不同的侧面的。那么,多头注意力中的卷积核是什么呢?
观察上图。多头注意力不是直接把 \(Q, K, V\) 直接送进缩放点积注意力的,再送进去之前,它给每一个 \(Q, K, V\) 都配套了一个 Linear。而且,这些 Linear 跟 h 个缩放点积注意力一样,也是叠起 h 个的。每个 Linear 都被初始化成不同的样子,它们就是多头注意力里的卷积核,就是它们让不同的头产生了差别。
式 6-15 多头注意力
再后面就是用一个 Concat 把所有头的维度强行拼接起来,然后用一个 \(W^O\) 再把维度缩放回去。
直接相加,维度都不会变。何必先拼后变多此一举呢?
这样操作比直接把所有头的矩阵加起来的好处就在于多出一个 \(W^O\) ,让神经网络有机会自己去调整各个头之间的权重和融合方法。
显然,多头的计算是很容易并行的。在实现它时,我们要记得用堆叠维度的方式做好对应的并行化处理。
6.5.7 位置编码
一大堆注意力,我们都渐进明细过来了。最后一个问题,注意力的并行把 RNN 天然的对文字的「顺序」的感知力给整没了。
我们要把这个能力给注意力机制给加回去 —— 两个词隔得远和近毕竟还是不同的吧。
注意力找回这个感知力的方式,被通称为「位置编码」。
其实这问题需要在进入注意力之前就得解决,一旦注意力开始算起来,位置就编码不明白了。「位置编码」是在 Embedding 之后,注意力计算之前的中间位置。
位置编码有很多种方案。如同我们之前所发现的,因为 \(K\) 和 \(V\) 分离,有的编码方案是不往 \(V\) 里编码位置信息的。也有的方案回归 RNN 的方式用循环的方式去让网络感受到位置信息,而不显式的增加位置编码。
如果我们自己设计位置编码我们会怎么做呢?
其实最简单的方式是给每个 Embedding 加几个比特来标记它的索引位置。但是这么做有 3 个问题。
-
分配多少比特呢? 256 上下文需要 8 比特,64K 上下文需要 16 比特,1M 上下需要 20 比特 —— 太小就不够,太大会浪费;
-
和之前一样,如果贸然给神经网络正整数的编号,它可能会产生线形关系的错觉。当然,文字距离确实是线形关系。但我们更想网络学会的是相对距离 —— 以每个字自己为 0 点;
-
加入新的比特会改变 Embedding 的形状。 Embedding 可是在网络的最前面哦~ —— 不同上下文长度的支持值得用完全不同形状的网络去支持吗?
不是说这样的位置编码不可行,毕竟 GPT2 就是这么做的 。
岔开说一句咸甜豆腐脑的爆论。从这段代码中我们也能瞥见前代框架王者 tf 和 PyTorch 的不同之处。我被它大大地羞辱过…… 它的设计是用静态网络来提高性能,想法没错。然而程序员们怎么束缚得住呢?只要你第一天推出私有方法,第二天就会被迫支持反射。于是,无奈地支持了 tf.shape(past) 这种东西。如果这种东西存在,静态的意义就已经不大了,徒增烦恼。我认为 Rust 的设计也是和 tf 是异曲同工的。 其实,不止 tf 和 Rust,每个时代都有这种用工具束缚工人的设计思想的产物,认为设计者高使用者一等的设计哲学产出的语言和框架。每个这种思想的产物无一例外,都让我学得很痛苦。当然, AI 编程正在改天换地,它可能会喜欢 Rust。我是不是在说程序员比 AI 编程更高一等……
回到正题。提出问题的主要目的可不是吵架啊,是用可能存在的问题来让我们察觉到 Transformer 位置编码的妙处。不然人家医于未病,我们还以为人家是庸医了。
Transformer 创造了一种编码方式叫「正余弦位置编码」。它是往 \(Q\)、 \(K\) 和 \(V\) 里都添加位置信息的,它没有增加的比特位,而且理论上它的上下文长度可以无限外推。
它是怎么做到的呢?
式 6-16 正余弦位置编码
不知道这帮神人当初是怎么想出这么一个编码方式,做不到一步步推导,我们就直接看答案吧……
首先,要把一个类似 1、2、3、4 这样的位置编号,变成一个和我们 Embedding 维度相同的向量。这样,编码出来的位置信息,才能和我们的 Embedding 加到一起去。这就是这个式子左半部分做的事。
然后,具体某个索引位置如何编码呢?神奇的右半部分来了。我们把它展开看得更清楚一些。
式 6-17 正余弦位置编码展开版
能看到,奇数位置它算了一个 \(\sin()\),偶数位置它算了一个 \(\cos()\)。何意为呢??
图 6-8 sin 和 cos
既然 Google Brain 的天才大脑们用到了三角函数,那我们也回忆一下 sin 和 cos 都是啥。
式 6-18 直角三角形中的 sin 和 cos
哦。sin 就是对边除斜边, cos 就是邻边除斜边。
我们再看下面这幅图。
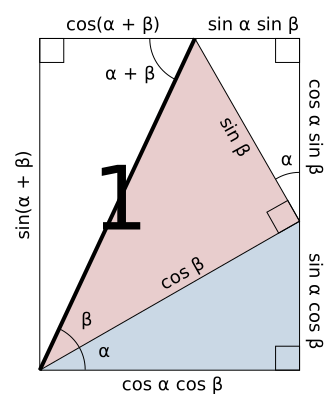
图 6-9 三角和差公式
盯这幅图 5 分钟,我们会得出来一个结论。
式 6-19 正弦和差公式
同理的,我们还能得到余弦和差公式。
式 6-20 余弦和差公式
我们发现 —— 这两个和差公式帮助我们把 k 从 pos + k 种给解耦出来了。
我们把它写成矩阵相乘的形式会更明显。
式 6-21 矩阵形式的和差公式
看。左边的矩阵仅与 k 相关,右边的矩阵仅与 pos 相关。
意思是,只要我们知道了某个两个位置的两对 sin 和 cos 值,理论上我们就能反推出它们的差 k 来。
当然,我们不会去推。也没有代码去推。我们把这层关系编码到 Emebedding 里,神经网络会自己学会这层关系!
位置编码是 Transformer 的第二层,这么复杂的数学关系。而且注意哦,我们给它的都是计算过后的浮点数,是有误差的,如果真的计算其实是不相等的哦。它真能穿过这层层迷雾学会这个位置关系吗?
看上去,答案似乎是肯定的……
所以啊,这也惊醒我们,处理数据的时候一定要小心再小心。千万别给神经网络搞什么深度预习、深度复习之类的小把戏,它不会跟咱们嘻嘻哈哈。把它整错了,那 BUG 可不好排。
还记得我们之前的个问题吗?相对于每个 Token 的索引,我们希望网络学会以每个 Token 自己为 0 点计算其它 Token 的距离。
那不就是 k。这个正余弦位置编码不就搞定这件事了。
我们还希望位置编码的比特数不受上下文长度限制。那正余弦位置编码更是轻松拿下。反正 sin 和 cos 都是转圈圈,你给它多大多小的数,反正它都能返回一个固定长度的返回值。
等等。新问题 —— 转圈圈?那么会不会转回原点呢?好像并不能实现无限长的上下文啊。或者说,会出错。
式 6-22 正弦函数的周期性
确实有这个问题。
这就需要我们往回翻一翻,看看正余弦位置编码的完整模样。
式 6-23 正余弦位置编码展开版2
看。它不止是一对 sin 和 cos,它有好多对。
这些对的区别在哪儿呢?在于下面的除数不同。这就意味着当 pos 按照一个固定的步长增长时,它们会让 sin 和 cos 的输出以不同的速率增长。
确实是在转圈圈,但是每个维度都在以不同的速度转圈圈。
就好比,如果我们的钟表只有一个时针,也许它只能表示 12 个值。可还是这个表,给它加一个不同速度的分针呢?再加一个秒针呢?
它的表示范围就大大增大了。
网上流传很广的 Transformer 位置编码的热力图说的就是这件事。
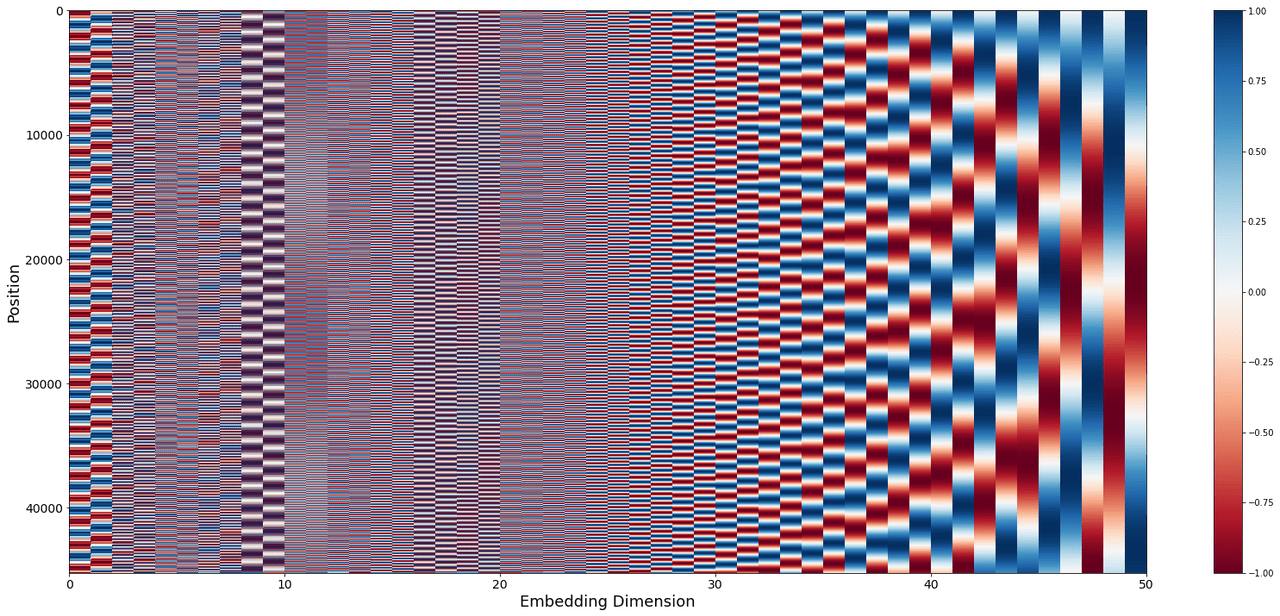
图 6-10 用错位周期表达更多值
这张图有很多种画法,但意思是相近的。图里的每一行是一个位置编码的结果。可以看到,它们虽然在相同的维度中确实表现出了三角函数的周期性,但是通过调整这些周期的错位,Google Brain 的天才用有限的值表达了近乎无限的范围。
这个道理也可以用二进制来类比 —— 哪怕每一位只有两个状态,只要位数够多,也能表达无限的值。
回顾一下正余弦位置编码的原始表达,确保我们理解它的每个部分。标量进向量出,目的是可以和 Embedding 融合。三角函数,是为了让网络习得相对位置。不同的维度上用不同的除数,目的是充分利用维度来用有限值表达无限范围。
再看看我们最开始提的三个问题。不要改变 Embedding 形状,每个词学会以自己为原点,不用考虑到底分配多少比特。是不是都被 Transformer 的奇思妙想给解决了?
那么,这就是 Transformer 中的位置编码了。
好了。虚空扯淡已经够多了。让我们 get our hands dirty 吧。
6.6 复刻 Transformer
本来我想只给 RNN 升级注意力机制,训练出一个网络来体现注意力机制的强力。折腾了很久,那样的网络非常非常难收敛,好不容意收敛了又过拟合了。
这说明,虽然注意力机制是绝对的主角,论文中的其他配角亦不可或缺。
或者说,Ashish Vaswani 等人的厉害之处不仅是「全盘采用注意力机制」这个灵感火花,更厉害在他们端出了一个可以引爆这个灵感火花的技术组合。
论文中的其它配角和主角注意力机制是相得益彰的关系。
6.6.1 数据准备
6.6.1.1 WMT 数据集
我们还是从数据集开始。
WMT 是 Workshop on Statistical Machine Translation 统计机器翻译研讨会的缩写,也有翻译成世界翻译大会的,它是最主要的机器翻译的学术会议。 Transformer 用的就是 WMT 2014 的数据集,成为了当时最好的翻译模型。
不过,Transformer 用的是英-德和英-法翻译的数据集。我们肯定得用一个中文的数据集。我们就用 WMT 2021 的中-英翻译数据集,目标是训练一个把英语翻译成中文的模型。这个数据集在 Modelscope.cn https://www.modelscope.cn/datasets/iic/WMT-Chinese-to-English-Machine-Translation-Training-Corpus 上能下载到。
我们用 modelscope 命令下载这个数据集。先安装一下 modelscope。
重启 shell 让 modelscope 命令能被环境变量找到。之后,我们开始下载 WMT 数据集到当前目录下的 dataset 目录。这个数据集大概 6.5 GB。
modelscope download --dataset iic/WMT-Chinese-to-English-Machine-Translation-Training-Corpus --local_dir ./dataset
然后,开始写我们的 python 脚本。我们先把 PyTorch 导入进来,做一些常规的初始化工作。
import os
import random
import torch

os.chdir(".") # 这里进到你下载数据集的目录里去
random.seed(42)

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print(f"Device: {device}")
if device.type == "cuda":
    print(f"GPU: {torch.cuda.get_device_name(0)}")
    print(f"Memory: {torch.cuda.get_device_properties(0).total_memory / 1024**3:.1f} GB")
请注意,这里虽然我们检测了 GPU 还是 CPU,但是今天的训练在 5090 上都要跑几十个小时,用 CPU 是不可行的。
稍微列几条这个数据集的样子,大概长这样。
0,1
表演 的 明星 是 X 女孩 团队 — — 由 一对 具有 天才 技艺 的 艳舞 女孩 们 组成 , 其中 有些 人 受过 专业 的 训练 。,"the show stars the X Girls - a troupe of talented topless dancers , some of whom are classically trained ."
表演 的 压轴戏 是 闹剧 版 《 天鹅湖 》 , 男女 小 人们 身着 粉红色 的 芭蕾舞 裙 扮演 小天鹅 。,the centerpiece of the show is a farcical rendition of Swan Lake in which male and female performers dance in pink tutus and imitate swans .
表演 和 后期制作 之间 的 屏障 被 清除 了 , 这 对 演员 来说 一样 大有裨益 。,the removal of the barrier between performance and post @-@ production was just as helpful for the actors .
( 表演 或 背诵 时 ) 通过 暗示 下面 忘记 或 记地 不准 的 东西 来 帮助 某人 。,assist ( somebody acting or reciting ) by suggesting the next words of something forgotten or imperfectly learned .
表演 基本上 很 精彩 - - 我 只 对 她 的 技巧 稍 有 意见 。,basically it was a fine performance I have only minor quibbles to make about her technique .
表演 结束 后 , 我们 看到 一对对 车灯 沿主路 一路 排回 镇上 , 然后 散开 来 各回 各家 。,"after it 's over , we watch the pairs of headlights glide in a neat line back up Main Street , dispersing as drivers turn off toward home ."
表演 结束 后 , 移走 了 背景墙 , 随后 全体 演员 即兴 邀请 观众 上台 齐 跳 并排 舞 。,after the performance they removed the back wall of the theatre and the cast summoned the audience onstage for an impromptu line dance .
表演 结束 后 用 宣纸 轻铺 水面 , 可 将 水面 上 的 画 进行 拓印 保存 。,"after the end of each performance with paper can be spread the water , light on the surface were saved . kids draw ."
表演 结束 后 , 众人 期待已久 的 园游会 终于 正式 开锣 , 美味可口 的 素食 佳肴 让 大家 一饱口福 。,"after the performances , a garden party featuring delicious vegetarian food , which had been long awaited by many , finally began ."
第一行的 0,1 是表头,这是一个标准的 csv 文件。我们现在用 python 的 csv 模块写一个函数,让我们可以把这个文件读进来,返回一个包含英文-中文对的数组。
# 从数据集中随机抽取 num_samples 条英汉对照的数据为我们所用
# 注意,原始数据集是中译英的,我们需要给它们反转一下

import csv

def load_and_sample_data(
    data_path: str,
    num_samples: int,
) -> list[tuple[str, str]]:
    reservoir: list[tuple[str, str]] = []
    total_lines = 0

    print(f"Sampling {num_samples:,} lines from {data_path}...")

    with open(data_path, "r", encoding="utf-8") as f:
        reader = csv.reader(f)
        next(reader)  # Skip header

        for row in reader:
            if len(row) < 2:
                continue
            cn_text = row[0].strip()
            en_text = row[1].strip()
            if not cn_text or not en_text:
                continue

            total_lines += 1
            pair = (en_text, cn_text)  # Swap: src=EN, tgt=CN

            if len(reservoir) < num_samples:
                reservoir.append(pair)
            else:
                j = random.randint(0, total_lines - 1)
                if j < num_samples:
                    reservoir[j] = pair

            if total_lines % 1_000_000 == 0:
                print(f"  Scanned {total_lines:,} lines...")

    print(f"  Sampled {len(reservoir):,} pairs from {total_lines:,} total lines")
    return reservoir
《Attension is All You Need》 的 5.1 小节提到他们用的数据集有大约 4_500_000 个英语-德语的句子对。我们的 WMT 2021 里有 25_000_000 个句子对。那我们也从中随机取出 4_500_000 个句子对来用,把其中 4_350_000 个作为我们的训练集,剩下 150_000 个作为我们的验证集。
留一些句子对做验证集的原因是这次我们训练的时间会很长,所以没办法等训练完再去判断网络是不是被我们训得过拟合了。这次我们要一边训练一边就在验证集上看看是不是已经过拟合了。如果训练集的 Loss 猛降,但是验证集的 Loss 没降,那就说明过拟合了,我们就赶紧停。
config_data_path = "./dataset/wmt_zh_en_training_corpus.csv"
config_train_pairs: int = 4_350_000
config_val_pairs: int = 150_000
all_pairs = load_and_sample_data(config_data_path, (config_train_pairs + config_val_pairs))
6.6.1.2 配角一:BPE Tokenizer
今天的一号男配是 BPE 分词器,即 Byte Pair Encoding 字节对编码分词器。它负责改进我们把句子拆成词的方式。
昨天,我们学习《活着》用的分词方式是「单字分词」,即把「今天天气真好」分成 ['今', '天', '天', '气', '真', '好']。
显然的,分成 ['今天', '天气', '真', '好'] 是一个更优的解。既能省显存和算力,而且提前汇聚了词意,省得网络去学习了。这种分词的方法其实用了很多年,叫「词典分词」。
词典分词就需要一个「词典」,BPE 就是来帮我们构建这个词典的。我们告诉 BPE,我们需要一个容纳 x 个词的词典。然后 BPE 就会对我们的语料进行分析,把这个语料中最高频出现的前 x 个词作为词典返回给我们。
具体来说,BPE Byte Pair Encoding 先一视同仁地把所有语料都拆成 Byte,统计出哪些 Byte 高频相邻出现,然后把它们 Pair 到一起组成一个新的单元。然后它会递归这个过程,直到我们要求的词表大小就覆盖了一定的文字比例,或者不再出现有 Pair 出现超过一次时,停止递归。
1994,BPE 由美国人 Philip Gage 作为一种数据压缩算法提出。2016,爱丁堡大学信息学院的 Rico Sennrich、Barry Haddow 和 Alexandra Birch 共同发表 《Neural Machine Translation of Rare Words with Subword Units》 首次将其应用到自然语言处理领域中。次年,Google Brain 采用了它作为 Transformer 的分词算法。
图 6-11 Rico Sennrich
BPE 这种数据预处理的工作 GPU 不太擅长,一般是交给 CPU 来做,所以 PyTorch 没有内置 BPE 实现。BPE 的手动实现版本可以参考 Hugging Face 的这个链接 https://huggingface.co/learn/llm-course/en/chapter6/5。
我们采用 Google 实现的 SentencePiece 库来拼插我们的 Transformer。
《Attension is All You Need》 的 5.1 节提到他们设置了一个双语共用的 37_000 的词典。我们也这么设置,只不过他们是英语德语词共用,我们是中文和英语词共用。
# 训练 BPE 分词器
# 不用它真收敛不了

# 先建个目录准备存模型
config_checkpoint_dir = "./checkpoints"
os.makedirs(config_checkpoint_dir, exist_ok=True)

# 给 BPE 准备数据
# 中英文共用一个分词器,所以把中英文都写在一起
# 中英文每人单独写一行

bpe_text_path = os.path.join(config_checkpoint_dir, "bpe_train.txt")
with open(bpe_text_path, "w", encoding="utf-8") as f:
    for en, cn in all_pairs:
        f.write(en + "\n")
        # 中文把原数据集里的空格都去了
        f.write("".join(cn.strip().split()) + "\n")
n_lines = len(all_pairs) * 2
config_shared_vocab_size = 37_000
print(f"  Wrote {n_lines:,} lines for BPE training")
print(f"  Training sentencepiece BPE (vocab_size={config_shared_vocab_size})...")
完成了 BPE 的数据准备和目标词表大小的设置。接下来,我们导入 Google 的 SentencePiece 库来训练我们的 BPE 模型。按照这个库的文档要求,我们把填充标记、未知词、句子开始和句子结束这 4 个特殊的 Token 分别手动指定 Token ID 为 0 、 1 、 2 、 3。
import sentencepiece as spm

PAD_ID = 0
UNK_ID = 1
BOS_ID = 2
EOS_ID = 3
class BPETokenizer:
    def __init__(self, model_path: str):
        self.sp = spm.SentencePieceProcessor()
        self.sp.load(model_path)

    @classmethod
    def train(
        cls,
        text_file: str,
        model_prefix: str,
        vocab_size: int = 37000,
    ) -> "BPETokenizer":
        spm.SentencePieceTrainer.train(
            input=text_file,
            model_prefix=model_prefix,
            vocab_size=vocab_size,
            model_type="bpe",
            character_coverage=0.9995,
            pad_id=PAD_ID,
            unk_id=UNK_ID,
            bos_id=BOS_ID,
            eos_id=EOS_ID,
            pad_piece="<pad>",
            unk_piece="<unk>",
            bos_piece="<bos>",
            eos_piece="<eos>",
            user_defined_symbols=[],
            max_sentence_length=10240,
            split_digits=True,
            byte_fallback=False,
            minloglevel=2,
        )
        return cls(f"{model_prefix}.model")

    def encode(self, text: str, add_bos: bool = True, add_eos: bool = True) -> list[int]:
        ids = self.sp.encode(text, out_type=int)
        if add_bos:
            ids = [BOS_ID] + ids
        if add_eos:
            ids = ids + [EOS_ID]
        return ids

    def decode(self, ids: list[int], join_char: str = "") -> str:
        # Filter special tokens
        filtered = [int(i) for i in ids if int(i) not in (PAD_ID, BOS_ID, EOS_ID)]
        text = self.sp.decode(filtered)
        # Chinese: no spaces; English: keep spaces
        if join_char:
            text = text.replace(" ", join_char)
        return text

    def vocab_size(self) -> int:
        return self.sp.vocab_size()

    def prepare_cn_text(self, text: str) -> str:
        """Convert space-separated Chinese text to raw characters for SP encoding."""
        return "".join(text.strip().split())

# 开始训练 BPE
tokenizer = BPETokenizer.train(
    bpe_text_path,
    model_prefix=os.path.join(config_checkpoint_dir, "bpe"),
    vocab_size=config_shared_vocab_size,
)
# os.remove(bpe_text_path)
config_shared_vocab_size = tokenizer.vocab_size()
print(f"  Vocabulary size: {config_shared_vocab_size:,}")
我租的机器配置是 16 核基础主频 3.0G 的 vCPU Intel(R) Xeon(R) Gold 6459C 加 90GB 内存 加 5090 32G。这段代码跑了 2 分钟 20 秒。调整 spm.SentencePieceTrainer.train() 函数的 minloglevel 参数可以设置日志级别。目前我们设置的是出错时才打日志,所以只输出了我们手动打印的以下内容。
现在, BPE 已经帮我们训练出来专属我们的词表了。然后,我们把数据集分成训练集和验证集,让 BPE 帮我们把我们的数据集里的文字都换成 Token ID。这样,未来 GPU 在训练的时候就不用等着 CPU 临时给它从文字转 ID 了。
random.shuffle(all_pairs)
full_train = all_pairs[:config_train_pairs]
full_val = all_pairs[config_train_pairs : config_train_pairs+config_val_pairs]
print(f"Train pairs: {len(full_train):,} , Val pairs: {len(full_val):,} ")

print("\nPre-tokenizing Training data via BPE...")
print(f"  {len(full_train):,} pairs — using sentencepiece batch encoding")

# 准备原始文本列表

# 提取英文文本
en_texts = [en for en, _ in full_train]

# 提取中文文本,并去除所有空格
cn_texts = ["".join(cn.strip().split()) for _, cn in full_train]

# 使用 SentencePiece 进行批量编码(比逐条处理速度快得多)
# 分块处理以避免一次性加载数据导致内存溢出
chunk_size = 500_000
tokenized_train = []
max_seq_len = 200

# 每次处理 chunk_size 条数据
for chunk_start in range(0, len(en_texts), chunk_size):
      # 因为数据总条数未必能被 chunk_size 整除,所以我们需要计算一下当前块的结束位置
      chunk_end = min(chunk_start + chunk_size, len(en_texts))

      # 切片获取当前块的中英文数据
      en_chunk = en_texts[chunk_start:chunk_end]
      cn_chunk = cn_texts[chunk_start:chunk_end]

      # SentencePiece 帮我们做批量编码,将文本转换为 Token ID
      src_encoded = tokenizer.sp.encode(en_chunk, out_type=int)
      tgt_encoded = tokenizer.sp.encode(cn_chunk, out_type=int)

      # 遍历当前块中每一对编码结果
      for src_ids, tgt_ids in zip(src_encoded, tgt_encoded):
            # 如果 Token ID 序列长度超过最大限制(max_seq_len - 2),则截断中间部分;
            # 减的 2 是为 BOS(句子开始) 和 EOS(句子结束) 标记留的位置
            src_ids = ([BOS_ID] + src_ids[:max_seq_len - 2] + [EOS_ID]
                        if len(src_ids) > max_seq_len - 2
                        else [BOS_ID] + src_ids + [EOS_ID])
            tgt_ids = ([BOS_ID] + tgt_ids[:max_seq_len - 2] + [EOS_ID]
                        if len(tgt_ids) > max_seq_len - 2
                        else [BOS_ID] + tgt_ids + [EOS_ID])

            # tokenized_train 就是未来我们真正要送进网络去的训练集
            tokenized_train.append((
                  torch.tensor(src_ids, dtype=torch.long),
                  torch.tensor(tgt_ids, dtype=torch.long),
            ))
      print(f"  Tokenized {chunk_end:,} / {len(full_train):,} ({chunk_end/len(full_train)*100:.0f}%)")

# 后面同样的道理,把验证集 full_val 也处理好
# 验证集比较小,机器内存比较大,我们一次全塞进了 SentencePiece
# 如果机器内存比较小,这里也需要分块
en_val = [en for en, _ in full_val]
cn_val = ["".join(cn.strip().split()) for _, cn in full_val]
src_val = tokenizer.sp.encode(en_val, out_type=int)
tgt_val = tokenizer.sp.encode(cn_val, out_type=int)
tokenized_val = []
for src_ids, tgt_ids in zip(src_val, tgt_val):
      src_ids = ([BOS_ID] + src_ids[:max_seq_len - 2] + [EOS_ID]
                  if len(src_ids) > max_seq_len - 2
                  else [BOS_ID] + src_ids + [EOS_ID])
      tgt_ids = ([BOS_ID] + tgt_ids[:max_seq_len - 2] + [EOS_ID]
                  if len(tgt_ids) > max_seq_len - 2
                  else [BOS_ID] + tgt_ids + [EOS_ID])

      # tokenized_val 是未来我们要用的验证集
      tokenized_val.append((
            torch.tensor(src_ids, dtype=torch.long),
            torch.tensor(tgt_ids, dtype=torch.long),
      ))
print(f"Pre-tokenize Validation data via BPE - done")
这项数据预处理的工作在 Xeon(R) Gold 6459C 上跑了 2 分钟,输出了以下内容。
Train pairs: 4,350,000 , Val pairs: 150,000

Pre-tokenizing Training data via BPE...
  4,350,000 pairs — using sentencepiece batch encoding
  Tokenized 500,000 / 4,350,000 (11%)
  Tokenized 1,000,000 / 4,350,000 (23%)
  Tokenized 1,500,000 / 4,350,000 (34%)
  Tokenized 2,000,000 / 4,350,000 (46%)
  Tokenized 2,500,000 / 4,350,000 (57%)
  Tokenized 3,000,000 / 4,350,000 (69%)
  Tokenized 3,500,000 / 4,350,000 (80%)
  Tokenized 4,000,000 / 4,350,000 (92%)
  Tokenized 4,350,000 / 4,350,000 (100%)
Pre-tokenize Validation data via BPE - done
6.6.1.3 组装 Dataloader
BPE 已经帮我们把训练集和验证集里的文字都转成 Token ID 了。接下来,我们把这两个数据集分别装到 2 个 torch.utils.data.Dataloader 里备用即可。当然,和昨天一样,我们还是先把我们的 list 封装成 torch.utils.data.Dataset,然后再传递给 torch.utils.data.Dataloader。
from torch.utils.data import Dataset, DataLoader

class PreTokenizedDataset(Dataset):
    """Dataset storing pre-tokenized tensor pairs for fast loading."""

    def __init__(self, pairs: list[tuple[torch.Tensor, torch.Tensor]]):
        self.pairs = pairs

    def __len__(self) -> int:
        return len(self.pairs)

    def __getitem__(self, idx: int) -> tuple[torch.Tensor, torch.Tensor]:
        return self.pairs[idx]

def collate_fn(
    batch: list[tuple[torch.Tensor, torch.Tensor]],
    pad_id: int = PAD_ID,
) -> tuple[torch.Tensor, ...]:
    """填充序列并生成注意力掩码。

    Returns:
        src: (batch, src_len)
        tgt_input: (batch, tgt_len-1)
        tgt_output: (batch, tgt_len-1)
        src_mask: (batch, 1, 1, src_len)
        tgt_mask: (batch, 1, tgt_len-1, tgt_len-1)
        memory_mask: (batch, 1, 1, src_len)
    """
    # batch 是一个列表,包含多个 元组。
    # zip(*batch) 将其分离成两个列表:一个全是 src,一个全是 tgt。
    src_batch, tgt_batch = zip(*batch)

    # 处理源语言序列

    # 计算每个句子的实际长度
    src_lens = [len(s) for s in src_batch]
    # 找出当前 batch 中最长的句子长度,作为填充标准
    src_max_len = max(src_lens)
    # 创建一个全为 pad_id 的张量作为初始化,形状为 (batch_size, max_len)
    src_padded = torch.full((len(src_batch), src_max_len), pad_id, dtype=torch.long)

    # 遍历每个样本,将实际数据填入张量前部(剩余部分保持 pad_id)
    for i, s in enumerate(src_batch):
        src_padded[i, :len(s)] = s

    # 同样的道理,处理目标语言序列
    tgt_lens = [len(t) for t in tgt_batch]
    tgt_max_len = max(tgt_lens)
    tgt_padded = torch.full((len(tgt_batch), tgt_max_len), pad_id, dtype=torch.long)
    for i, t in enumerate(tgt_batch):
        tgt_padded[i, :len(t)] = t

    #  构造 Teacher Forcing 的输入/输出

    # 【例子说明】:
    # 假设 tgt_padded 的一个句子是:[BOS, "我", "爱", "你", EOS] (长度为5)

    # tgt_input: 去掉最后一个 token (EOS)
    # 切片后变成:[BOS, "我", "爱", "你"] (长度为4)
    # 这是解码器在训练时看到的输入,用来预测下一个词
    tgt_input = tgt_padded[:, :-1]

    # tgt_output: 去掉第一个 token (BOS)
    # 切片后变成:["我", "爱", "你", EOS] (长度为4)
    # 这是解码器应该预测出的正确答案(标签)
    tgt_output = tgt_padded[:, 1:]

    # 【对应关系】:
    # 输入 BOS  -> 预测目标 "我"
    # 输入 "我" -> 预测目标 "爱"
    # 输入 "爱" -> 预测目标 "你"
    # 输入 "你" -> 预测目标 EOS

    # 生成掩码
    # 目的是未来告诉网络,哪些词需要计算注意力,哪些词只是填充,是不需要去算注意力的
    # 这个「不计算」其实也还是算了,实际是通过乘以 0 实现的

    # 源序列掩码:标记非填充部分
    src_mask = (src_padded != pad_id).unsqueeze(1).unsqueeze(2)

    # 目标序列掩码
    tgt_len = tgt_input.size(1)

    # 【例子说明】:因果掩码
    # 假设 tgt_len = 3,torch.tril 生成下三角矩阵:
    # [[1, 0, 0],
    #  [1, 1, 0],
    #  [1, 1, 1]]
    # 含义:第0个位置只能看第0个;
    #       第1个位置能看第0、1个;
    #       第2个位置能看第0、1、2个。
    # 作用:防止“偷看”未来的词。
    causal_mask = torch.tril(torch.ones(tgt_len, tgt_len, dtype=torch.bool))

    # 填充掩码:标记哪些位置是真实词汇,哪些是 PAD
    tgt_padding_mask = (tgt_input != pad_id).unsqueeze(1).unsqueeze(2)

    # 组合掩码:逻辑与 (&) 运算
    # 只有既不是 PAD,又满足“不看未来”限制的位置才为 True。
    tgt_mask = tgt_padding_mask & causal_mask.unsqueeze(0).unsqueeze(0)

    # 记忆掩码:用于 Cross-Attention,直接复用源序列掩码
    memory_mask = src_mask

    return src_padded, tgt_input, tgt_output, src_mask, tgt_mask, memory_mask

train_dataset = PreTokenizedDataset(tokenized_train)
val_dataset = PreTokenizedDataset(tokenized_val)

# 基于我们的显存大小,设置 batch_size
config_batch_size = 48

# 基于我们的 CPU 数量,设置为 GPU 做数据处理的进程数
config_num_workers = 4

# 基于我们的内存大小,我们设置 pin_memory 是否把内存占住不释放
config_pin_memory = False

train_loader = DataLoader(
      train_dataset,
      batch_size=config_batch_size,
      shuffle=True,
      collate_fn=collate_fn,
      num_workers=config_num_workers,
      pin_memory=config_pin_memory,
      prefetch_factor=2,
      persistent_workers=False,
)
val_loader = DataLoader(
      val_dataset,
      batch_size=config_batch_size,
      shuffle=False,
      collate_fn=collate_fn,
      num_workers=config_num_workers,
      pin_memory=config_pin_memory,
      persistent_workers=False,
)
6.6.2 组装 Transformer 网络
现在我们来实现 Transformer 的神经网络部分。
论文中第 3 节画出了 Transformer 的整体架构。
里面的零件大多我们都认识了,理解起来应该不难。
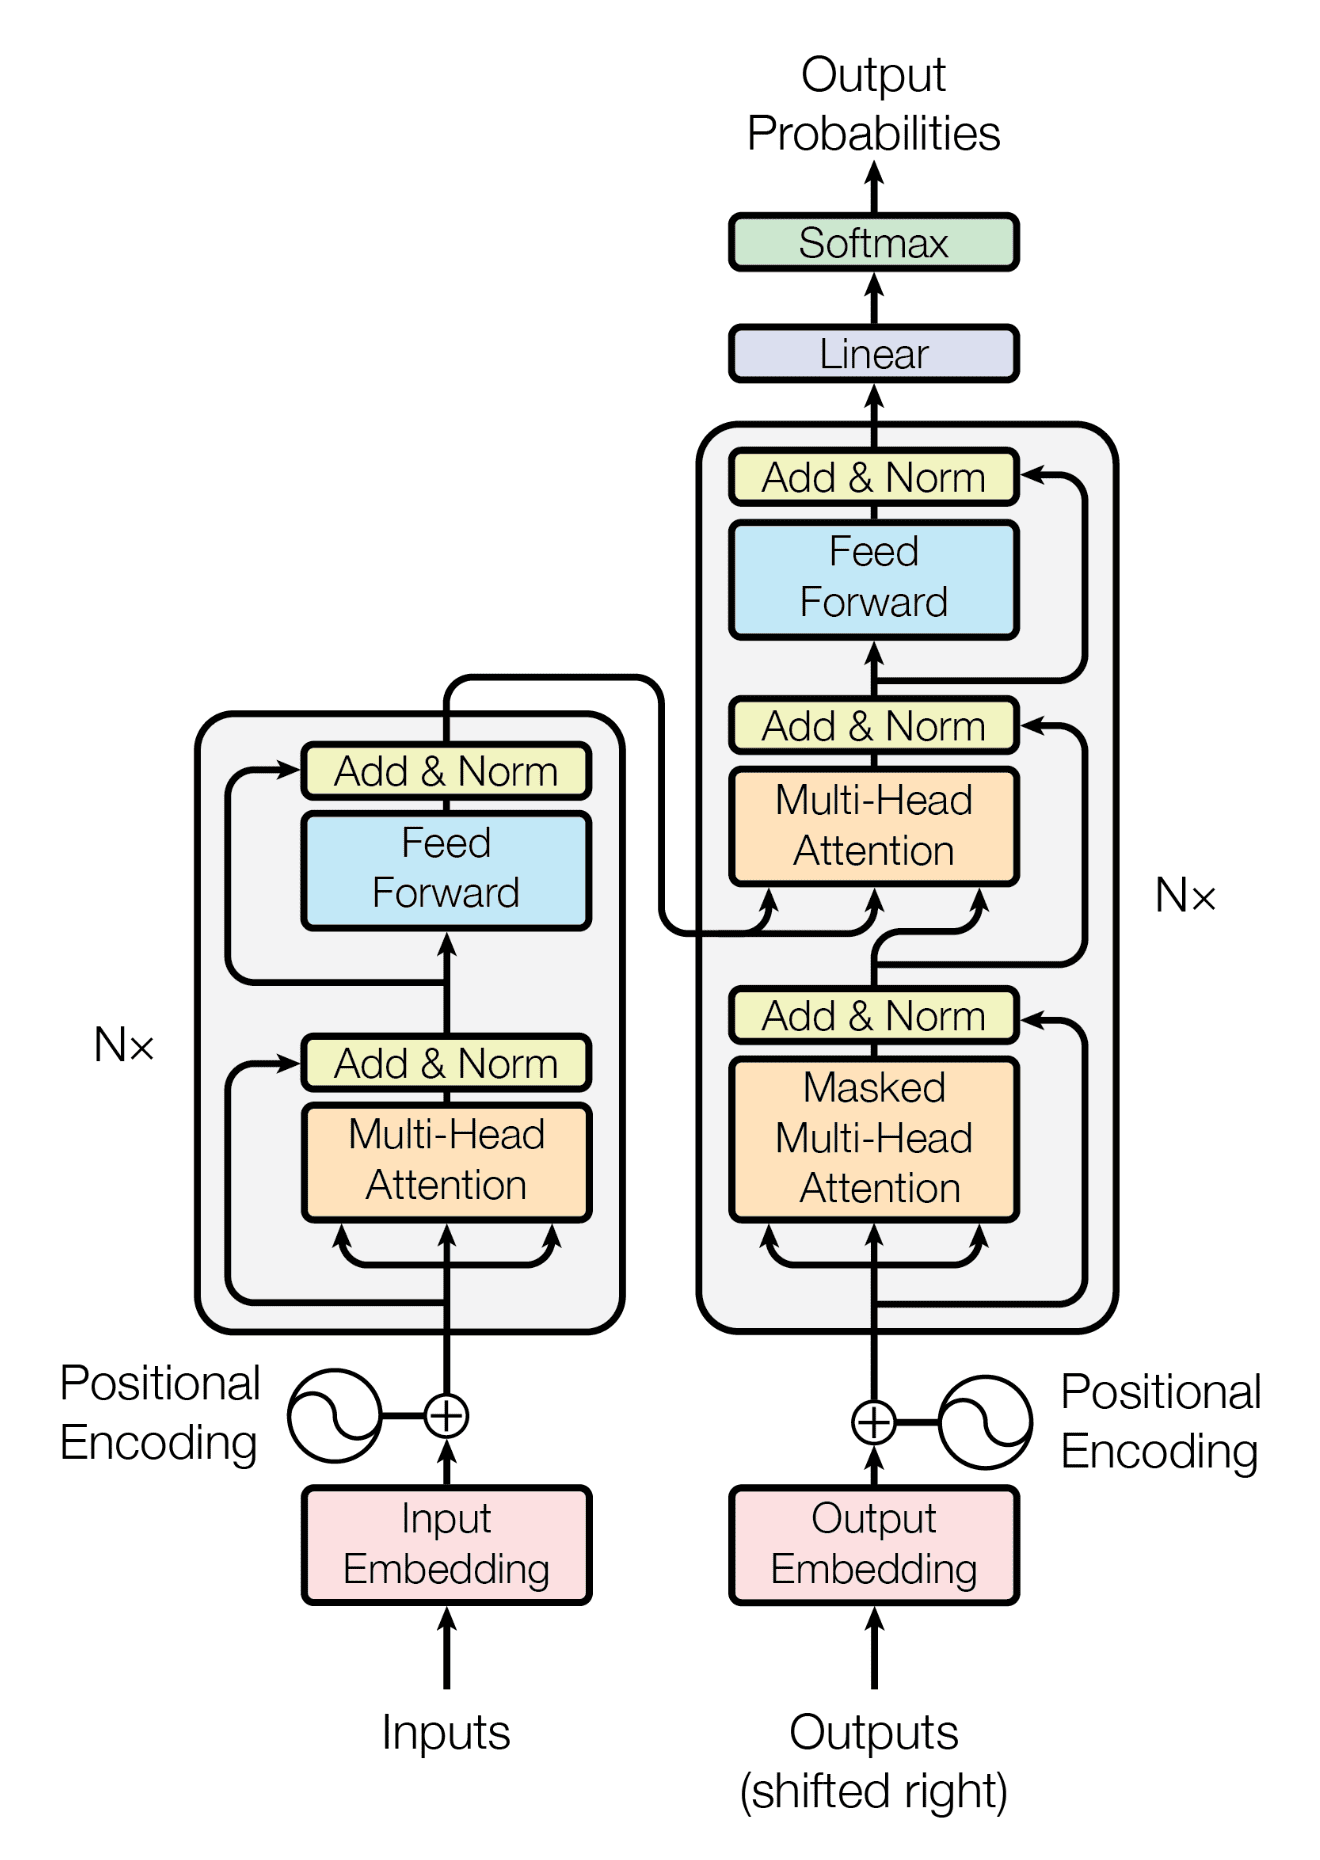
图 6-12 Transformer
它整体是一个编码器-解码器结构。
因为它的主要用途是翻译。左半边是编码器,负责理解原文。右半边是解码器,负责生成译文。
留意两侧的 Nx,它的意思是编码器和解码器都级联了 N 层,论文 3.1 节提到 N = 6。
留意连到 Add & Norm 的箭头,那就是何凯明发明的残差连接,它在 Transformer 中起到了重要的作用。它使得 Positional Encoding 中的位置信息不会在一轮轮的矩阵计算中丢失淡化,能全程一直传递到最后。
留意那个 Feed Forward,这可能是图中我们唯一陌生的零件。它经常被翻译成「前馈网络」,之所以这么叫是因为它让信号单纯往前走,不像 RNN 那样还能「反馈」出隐变量。
没提到它是因为它实在是太简单了。论文 3.3 节用了最短的方式描述它。
In addition to attention sub-layers, each of the layers in our encoder and decoder contains a fully connected feed-forward network, which is applied to each position separately and identically. This consists of two linear transformations with a ReLU activation in between.
它就是 2 层全连接神经网络,中间夹着一个 ReLU。它负责存储 Transformer 学到的各种注意力头装不下的语言模式。
留意右侧的解码器,它和编码器唯一的不同就是多了一个 Masked Multi-Head Attention。因为解码器的任务是生成译文,所以它是一个因果结构,所以 Transformer 使用因果注意力不让它看到当前词之前的词。
最后,Transformer 的输出是一个 softmax() ,老朋友了。它负责输出即将输出的 Token ID 在整个词表中的概率。
接下来,我们一个一个地实现这些小零件。
6.6.2.1 实现正余弦位置编码
回忆一下 Transformer 中位置编码的算法。
式 6-24 正余弦位置编码2
为了利用 PyTorch 里高效的 exp 和 log GPU 算子。
我们通过这个等式把公式中那个求幂操作优化一下。
式 6-25 优化正余弦位置编码中的幂运算
这是一个实现 Transformer 时常用的优化,很多版本都是这么搞的。优化后的位置编码实现如下。
import torch.nn as nn

class PositionalEncoding(nn.Module):
    """正余弦位置编码"""

    def __init__(self, d_model: int, max_len: int = 5000, dropout: float = 0.1):
        # d_model: 词向量维度
        # max_len: 最大上下文长度
        # dropout: 正则 dropout 的概率
        super().__init__()
        self.dropout = nn.Dropout(p=dropout)

        # 初始化 pe 位置编码矩阵为全 0
        pe = torch.zeros(max_len, d_model)

        # 初始化 position 位置索引,shape (max_len, 1),值为 0, 1, ..., max_len-1
        position = torch.arange(0, max_len, dtype=torch.float).unsqueeze(1)

        # 初始化 div_term 频率项,对应公式中的 1 / 10000^(2i / d_model)
        # 用 torch.arange(0, d_model, 2) 取出 i = 0, 2, 4, ... 共 d_model//2 个值
        # torch.exp(x) 是算 e 为底的 x 次幂。和后面的 -math.log(10000.0) 相抵消。
        # 这么搞是为了利用 GPU 中的快速 exp() 实现,比以 10000 为底能快 10 倍
        div_term = torch.exp(
            torch.arange(0, d_model, 2, dtype=torch.float) * (-math.log(10000.0) / d_model)
        )

        # 偶数下标列(0, 2, 4, ...)算 sin()
        pe[:, 0::2] = torch.sin(position * div_term)
        # 奇数下标列(1, 3, 5, ...)算 cos()
        pe[:, 1::2] = torch.cos(position * div_term)

        # 在第 0 维加一个 batch 维度,变成 (1, max_len, d_model),便于后续堆叠维度
        pe = pe.unsqueeze(0)  # (1, max_len, d_model)

        # 把算出来的 pe 位置编码存到模型变量里
        self.register_buffer("pe", pe)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = x + self.pe[:, :x.size(1)]
        return self.dropout(x)
这段代码中大多数 PyTorch 函数之前都见过了。唯一一个没见过的是 self.register_buffer("pe", pe)。
它的效果和 self.pe = pe 是类似的,区别在于 self.register_buffer("pe", pe) 会让模型保存时把 pe 存下来,而 self.pe = pe 算是临时变量,模型是不存的。
Model.parameters() 当然也会存。self.register_buffer() 和它的区别在于,优化器不会在反向传播时去尝试更新它,等于是静态变量,或者说是模型里的静态参数。
6.6.2.2 实现多头注意力
严格按照前述注意力机制实现,一看代码注释就懂。
from typing import Optional

class MultiHeadAttention(nn.Module):
    """多头注意力"""

    def __init__(self, d_model: int, n_heads: int, dropout: float = 0.1):
        super().__init__()

        # 确保模型的总维度可以被头数整除,这样才能均匀分配给每个头
        assert d_model % n_heads == 0
        self.d_model = d_model
        self.n_heads = n_heads
        self.d_k = d_model // n_heads

        # Q, K, V 的线性变换层,将输入投影到高维空间以提取特征
        self.W_q = nn.Linear(d_model, d_model)
        self.W_k = nn.Linear(d_model, d_model)
        self.W_v = nn.Linear(d_model, d_model)

        # 输出的线性变换层,将多头拼接后的结果映射回原维度
        self.W_o = nn.Linear(d_model, d_model)

        self.dropout = nn.Dropout(dropout)

    def forward(
        self,
        query: torch.Tensor,
        key: torch.Tensor,
        value: torch.Tensor,
        mask: Optional[torch.Tensor] = None,
    ) -> torch.Tensor:
        batch_size = query.size(0)

        # 把变换后的 Q K V 分出多个头来
        Q = self.W_q(query).view(batch_size, -1, self.n_heads, self.d_k).transpose(1, 2)
        K = self.W_k(key).view(batch_size, -1, self.n_heads, self.d_k).transpose(1, 2)
        V = self.W_v(value).view(batch_size, -1, self.n_heads, self.d_k).transpose(1, 2)

        # 计算注意力分数
        scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(self.d_k)

        # 应用因果掩码
        # 有个 if,因为这个类是编码器和解码器共用的
        if mask is not None:
            scores = scores.masked_fill(mask == 0, float("-inf"))

        # 用 softmax 计算注意力权重
        attn_weights = torch.nn.functional.softmax(scores, dim=-1)
        attn_weights = self.dropout(attn_weights)

        # 按比例把 V 掺进去
        out = torch.matmul(attn_weights, V)

        # 合并多头
        # transpose 交换张量中第 1 维和第 2 维,
        #       将维度变回 (batch, seq_len_q, n_heads, d_k),
        #       本来是 (batch, n_heads, seq_len_q, d_k)
        # contiguous() 确保内存连续,因为 view 需要连续内存
        # view 合并多头 (batch, seq_len_q, d_model)
        out = out.transpose(1, 2).contiguous().view(batch_size, -1, self.d_model)

        # 最后的线性层 W_o 回复维度,输出结果
        return self.W_o(out)
6.6.2.3 实现前馈网络
超普通,不看注释都懂。
class FeedForward(nn.Module):
    """前馈网络"""

    def __init__(self, d_model: int, d_ff: int, dropout: float = 0.1):
        super().__init__()
        self.linear1 = nn.Linear(d_model, d_ff)
        self.linear2 = nn.Linear(d_ff, d_model)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.linear2(self.dropout(torch.nn.functional.relu(self.linear1(x))))
6.6.2.4 配角二:层归一化
在继续实现编码器和解码器之前,我们还需要实现一个配角:层归一化。
之前,我们实现过「数据归一化」和「批归一化」。
前者设计的原因是数据集不同维度之间的绝对值只会妨碍训练,相对值就够。目的是把数据集中不同尺度的数据归一到同一个尺度上来。手段是把每个维度的数值都归一成它们差了几个标准差。
后者设计的原因是只在全局做数据集归一化会导致每个 batch 内部数据还是会排布不匀,由于在网络层次深了之后,根本控制不住一层层过去,每层后面的数值不会偏移。目的是让网络的每 batch 和每层都能拿到足够均匀的数据去学习。手段是在网络层次的内部插入归一化层,且仅针对当前 batch 的数据归一化。当然,既然插到内部了,那也只能对当前 batch 数据做了。不像数据归一化是在进入网络之前就做了。
但是这这种归一化在遇到 RNN 和 Transformer 这样的网络的时候,遇到了问题。因为我们训练的是因果模型,所以我们的输入序列长度是不固定的。这就意味着在同一个 batch 中会有不同长度的样本。而批归一化是对维度敏感的。
比如说我们的一个批次中有这样两句话。
| 句子 A | 句子 B | 方差和标准差结果 |
|---|---|---|
| 今天 | 人工 | 2个数据,方差正常计算(其实 2 个也不太正常……) |
| 天气 | 智能 | 2个数据,方差正常计算 |
| 真 | 正在 | 2个数据,方差正常计算 |
| 好 | 改变 | 2个数据,方差正常计算 |
| [PAD] | 我们 | 1个数据,方差为 0,标准差的分母为 0,除零错误 |
| [PAD] | 的 | 1个数据,方差为 0,标准差的分母为 0,除零错误 |
| [PAD] | 世界 | 1个数据,方差为 0,标准差的分母为 0,除零错误 |
表 6-3 强行在参差的批次中使用批归一化
上面举了一个极端的例子。当然,实际操作中,我们也可以给 [PAD] 一个值,不让它出现除零这么夸张的错误。但是批归一化这种操作在面对 batch 中参差不齐的数据时,终归是有些问题。方差疯狂漂移,批次之间的归一化结果受参差程度的影响,不好用。
所以,我们需要一个新的归一化方法用在 Transformer 里。
回忆一下,之前我们做数据归一化是针对类似这样的数据。
| 总用户数 | 直播预约人数 | 直播出时间(小时) | 直播推送方式(0=无推送,1=App推送,2=短信推送) | 最高在线人数 |
|---|---|---|---|---|
| 30000 | 1800 | 14 | 1 | 4100 |
| 40000 | 2000 | 16 | 1 | 4300 |
| 50000 | 3200 | 20 | 2 | 9000 |
| 60000 | 2500 | 12 | 0 | 2800 |
| 70000 | 3000 | 15 | 0 | 3600 |
| 80000 | 4200 | 18 | 1 | 9100 |
| 100000 | 6000 | 20 | 2 | 15800 |
| 120000 | 7500 | 21 | 2 | 19200 |
| 150000 | 9000 | 19 | 2 | 22500 |
| 200000 | 15000 | 22 | 2 | 38000 |
表 6-4 之前数据归一化的操作数
我们可以看到,不同维度之间的数据,绝对值相差很大。不管是「数据归一化」还是「批归一化」,目标都是去除这种没用的数值差距,因为它并不能表达对应的权重。它是竖着做的。
那我们现在的序列,因为因果的原因,不能这样竖着归一化了。这是它新的毛病。它有没有什么新的好处可以让我们找补一下呢?
| 序列1 | 维度1 | 维度2 | 维度3 | 序列2 | 维度1 | 维度2 | 维度3 |
|---|---|---|---|---|---|---|---|
| 今天 | 0.12 | 0.45 | 0.78 | 人工 | 0.23 | 0.56 | 0.89 |
| 天气 | 0.34 | 0.67 | 0.90 | 智能 | 0.45 | 0.78 | 0.01 |
| 真 | 0.56 | 0.89 | 0.12 | 正在 | 0.67 | 0.90 | 0.23 |
| 好 | 0.78 | 0.01 | 0.34 | 改变 | 0.89 | 0.12 | 0.45 |
| 我们 | 0.01 | 0.34 | 0.67 | ||||
| 的 | 0.23 | 0.56 | 0.89 | ||||
| 世界 | 0.45 | 0.78 | 0.01 |
表 6-5 因果序列的数据
观察一下,我们可以发现这次数据的特点是它们之间的数量级相差不大。这是文字序列的特点。
所以,其实我们并不需要在维度间做归一化,也就是不用竖着归一化。我们可以横着归一化。针对某一个 Sample 的 [0.12, 0.45, 0.78] 做归一化。
这就是 2016 年,Jimmy Lei Ba 和 Geoffrey E Hinton 辛顿在 《Layer Normalization》 中提出的「层归一化」。
2017 年的《Attention Is All You Need》采用了这种「层归一化」。
下面给出一个参考的手动实现版本。
class ManualLayerNorm(nn.Module):
    """层归一化"""

    def __init__(
        self,
        normalized_shape: union[int, list[int], torch.Size],
        eps: float = 1e-5,
        device=None,
        dtype=None,
    ):
        """
        Args:
            normalized_shape: 需要归一化的维度大小(整数)或形状列表(暂时只支持整数,对应最后一维)
            eps: 数值稳定性常数
        """
        super().__init__()

        # 统一 normalized_shape 为 torch.Size
        if isinstance(normalized_shape, int):
            normalized_shape = [normalized_shape]

        self.normalized_shape = torch.Size(normalized_shape)
        self.eps = eps

        self.weight = nn.Parameter(torch.ones(self.normalized_shape))
        self.bias = nn.Parameter(torch.zeros(self.normalized_shape))

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        # 计算均值和方差(在归一化维度上)
        # 使用 torch.mean 和 torch.var,指定 unbiased=False 以使用有偏估计
        # 保持维度,以便广播
        mean = x.mean(dim=-1, keepdim=True)
        var = x.var(dim=-1, unbiased=False, keepdim=True)

        # 归一化:减去均值,除以标准差(加eps防止除零)
        x_norm = (x - mean) / torch.sqrt(var + self.eps)

        return self.weight * x_norm + self.bias
6.6.2.4 实现编码器
有了「层归一化」,我们编码器的零件就齐了。
class EncoderLayer(nn.Module):
    """后归一化编码器层"""

    def __init__(self, d_model: int, n_heads: int, d_ff: int, dropout: float = 0.1):
        super().__init__()
        # 初始化多头注意力
        self.self_attn = MultiHeadAttention(d_model, n_heads, dropout)

        # 初始化前馈网络
        self.ff = FeedForward(d_model, d_ff, dropout)

        # 初始化层归一化层
        self.norm1 = nn.LayerNorm(d_model)
        self.norm2 = nn.LayerNorm(d_model)

        self.dropout = nn.Dropout(dropout)

    def forward(self, x: torch.Tensor, mask: Optional[torch.Tensor] = None) -> torch.Tensor:

        # 拿到多头注意力的输出
        attn_out = self.self_attn(x, x, x, mask)

        # 残差连接后,进行归一化
        x = self.norm1(x + self.dropout(attn_out))

        # 过前馈网络
        ff_out = self.ff(x)

        # 再次残差连接,而后再次归一化
        x = self.norm2(x + self.dropout(ff_out))
        return x
然后,我们把多个编码器层级联起来,组成 Transformer 的编码器部分。
class Encoder(nn.Module):
    def __init__(self, d_model: int, n_heads: int, d_ff: int, n_layers: int, dropout: float = 0.1):
        super().__init__()

        # 级联多个 EncoderLayer,做成一整个编码器
        self.layers = nn.ModuleList([
            EncoderLayer(d_model, n_heads, d_ff, dropout) for _ in range(n_layers)
        ])

        # 最后的归一化
        self.norm = nn.LayerNorm(d_model)

    def forward(self, x: torch.Tensor, mask: Optional[torch.Tensor] = None) -> torch.Tensor:

        # 依次通过每一个 EncoderLayer
        for layer in self.layers:
            x = layer(x, mask)

        # 归一化后输出
        return self.norm(x)
6.6.2.5 实现解码器
同理的,我们实现解码器。
class DecoderLayer(nn.Module):
    """后归一化解码器层"""

    def __init__(self, d_model: int, n_heads: int, d_ff: int, dropout: float = 0.1):
        super().__init__()
        # 初始化多头注意力
        self.self_attn = MultiHeadAttention(d_model, n_heads, dropout)

        # 初始化交叉注意力
        self.cross_attn = MultiHeadAttention(d_model, n_heads, dropout)

        # 初始化前馈网络
        self.ff = FeedForward(d_model, d_ff, dropout)

        # 初始化层归一化
        self.norm1 = nn.LayerNorm(d_model)
        self.norm2 = nn.LayerNorm(d_model)
        self.norm3 = nn.LayerNorm(d_model)

        self.dropout = nn.Dropout(dropout)

    def forward(
        self,
        x: torch.Tensor,
        memory: torch.Tensor,
        tgt_mask: Optional[torch.Tensor] = None,
        memory_mask: Optional[torch.Tensor] = None,
    ) -> torch.Tensor:

        # 计算带掩码的因果多头注意力
        attn_out = self.self_attn(x, x, x, tgt_mask)

        # 归一化
        x = self.norm1(x + self.dropout(attn_out))

        # 计算交叉注意力
        attn_out = self.cross_attn(x, memory, memory, memory_mask)

        # 归一化
        x = self.norm2(x + self.dropout(attn_out))

        # 前馈网络
        ff_out = self.ff(x)

        # 归一化
        x = self.norm3(x + self.dropout(ff_out))
        return x
这里唯一值得注意的是所谓「交叉注意力」,它其实和别的注意力没有什么区别,唯一的不同是输入的不同。
观察 Transformer 的架构,我们可以发现它的 \(Q, K, V\) 部分,有 1 个是来自解码器生成的序列,2 个来自编码器生成的序列。
具体来说, \(Q\) 来自解码器,即已输出的译文,\(K, V\) 再来编码器,即对整个原文的理解。
这就是所谓的「交叉」,它相对的是「自」注意力。即它关注的是当前词和另一个句子中每一个词的被影响程度,从而找准自己的意思。
我们级联多个解码器,组成 Transformer 的解码器部分。
class Decoder(nn.Module):
    def __init__(self, d_model: int, n_heads: int, d_ff: int, n_layers: int, dropout: float = 0.1):
        super().__init__()

        # 级联多个 DecoderLayer,做成一整个解码器
        self.layers = nn.ModuleList([
            DecoderLayer(d_model, n_heads, d_ff, dropout) for _ in range(n_layers)
        ])

        # 归一化
        self.norm = nn.LayerNorm(d_model)

    def forward(
        self,
        x: torch.Tensor,
        memory: torch.Tensor,
        tgt_mask: Optional[torch.Tensor] = None,
        memory_mask: Optional[torch.Tensor] = None,
    ) -> torch.Tensor:

        # 依次通过每一个 DecoderLayer
        for layer in self.layers:
            x = layer(x, memory, tgt_mask, memory_mask)

        # 归一化后输出
        return self.norm(x)
6.6.2.6 拼装 Transformer
现在,我们把编码器和解码器拼在一起,组成完整的 Transformer。
import math

class Seq2SeqTransformer(nn.Module):
    """ Transformer """

    def __init__(self,
            config_shared_vocab_size: int,
            config_d_model: int,
            config_max_seq_len: int,
            config_dropout: float,
            config_n_heads: int,
            config_d_ff: int,
            config_n_encoder_layers: int,
            config_n_decoder_layers: int
        ):
        super().__init__()
        self.config_shared_vocab_size = config_shared_vocab_size
        self.config_d_model = config_d_model
        self.config_max_seq_len = config_max_seq_len
        self.config_dropout = config_dropout
        self.config_n_heads = config_n_heads
        self.config_d_ff = config_d_ff
        self.config_n_encoder_layers = config_n_encoder_layers
        self.config_n_decoder_layers = config_n_decoder_layers

        # 初始化嵌入层,源语言和目标语言共享
        self.embedding = nn.Embedding(config_shared_vocab_size, config_d_model)

        # 初始化位置编码
        self.positional_encoding = PositionalEncoding(
            config_d_model, config_max_seq_len, config_dropout
        )

        # 初始化编码器
        self.encoder = Encoder(
            config_d_model, config_n_heads, config_d_ff,
            config_n_encoder_layers, config_dropout,
        )

        # 初始化解码器
        self.decoder = Decoder(
            config_d_model, config_n_heads, config_d_ff,
            config_n_decoder_layers, config_dropout,
        )

        # 初始化输出投影层:将解码器的隐藏状态维度映射回词汇表大小
        # 关键点:将此层的权重显式赋值为嵌入层的权重,实现权重共享
        self.output_projection = nn.Linear(config_d_model, config_shared_vocab_size)
        self.output_projection.weight = self.embedding.weight

        # 初始化模型参数
        self._init_parameters()

    def _init_parameters(self):
        for p in self.parameters():
            # 如果参数维度大于1(即权重矩阵,而非偏置向量 bias),
            # 则使用 Xavier 均匀初始化
            # 这有助于在深层网络中保持梯度的稳定性
            if p.dim() > 1:
                nn.init.xavier_uniform_(p)

    def forward(
        self,
        src: torch.Tensor,
        tgt: torch.Tensor,
        src_mask: Optional[torch.Tensor] = None,
        tgt_mask: Optional[torch.Tensor] = None,
        memory_mask: Optional[torch.Tensor] = None,
    ) -> torch.Tensor:

        # 获取原文的嵌入,并乘以 d_model 的平方根进行缩放
        # 缩放是为了让嵌入向量的量级与位置编码相加后保持稳定
        src_emb = self.embedding(src) * math.sqrt(self.config_d_model)

        # 原文位置编码
        src_emb = self.positional_encoding(src_emb)

        # 流过编码器
        memory = self.encoder(src_emb, src_mask)

        # 获取译文的嵌入
        tgt_emb = self.embedding(tgt) * math.sqrt(self.config_d_model)

        # 译文位置编码
        tgt_emb = self.positional_encoding(tgt_emb)

        # 流过解码器
        decoder_out = self.decoder(tgt_emb, memory, tgt_mask, memory_mask)

        # 将解码器输出映射到词汇表大小
        return self.output_projection(decoder_out)

    def encode(
        self, src: torch.Tensor, src_mask: Optional[torch.Tensor] = None
    ) -> torch.Tensor:

        # 用于推理阶段的编码
        src_emb = self.embedding(src) * math.sqrt(self.config_d_model)
        src_emb = self.positional_encoding(src_emb)
        return self.encoder(src_emb, src_mask)

    def decode(
        self,
        tgt: torch.Tensor,
        memory: torch.Tensor,
        tgt_mask: Optional[torch.Tensor] = None,
        memory_mask: Optional[torch.Tensor] = None,
    ) -> torch.Tensor:

        # 用于推理阶段的解码
        # 接受编码器输出的隐变量,和已生成的序列,生成新词
        tgt_emb = self.embedding(tgt) * math.sqrt(self.config_d_model)
        tgt_emb = self.positional_encoding(tgt_emb)
        decoder_out = self.decoder(tgt_emb, memory, tgt_mask, memory_mask)
        return self.output_projection(decoder_out)

    def count_parameters(self) -> int:
        # 统计模型参数量
        return sum(p.numel() for p in self.parameters() if p.requires_grad)


# 实例化 Transformer
config_shared_vocab_size: int = 37000
config_d_model: int = 512
config_max_seq_len: int = 200
config_dropout: float = 0.1
config_n_heads: int = 8
config_d_ff: int = 2048
config_n_encoder_layers: int = 6
config_n_decoder_layers: int = 6

model = Seq2SeqTransformer(
    config_shared_vocab_size=config_shared_vocab_size,
    config_d_model=config_d_model,
    config_max_seq_len=config_max_seq_len,
    config_dropout=config_dropout,
    config_n_heads=config_n_heads,
    config_d_ff=config_d_ff,
    config_n_encoder_layers=config_n_encoder_layers,
    config_n_decoder_layers=config_n_decoder_layers
).to(device)

print(f"  Parameters: {model.count_parameters():,}")
这里面值得注意是的权重共享。 Transformer 只有一个词表,它在 3 个地方被复用。中文和英文共用这个词表,自然而然的,输出的时候,也用这个词表。
另一个值得注意的是对 Embedding 的缩放。这是因为 Embedding 层在 Xavier 初始化后数值范围大约在 \(\left[ -\frac{1}{\sqrt{d}}, \frac{1}{\sqrt{d}} \right]\) 之间,而位置编码是由 sin() 和 cos() 生成的,其数值范围在 \(\left[ -1, 1 \right]\) 之间。
这样,它两一相加的话,后者就把前者给「淹灭」了。为了让这两个东西有相同的权重,所以给 Embedding 乘了一个 \({\sqrt{d}}\)。
还一个注意的是 encode() 和 decode(),这 2 个是用于推理阶段的方法。
推理阶段和训练阶段的主要区别是:
-
推理阶段得一个词一个词蹦。它没有正确答案。
-
推理阶段用 Encode 理解一次句子就行了。而训练阶段因为要反向传播训练网络,所以每蹦一个词都要重新过一遍 Encode。这对训练结束后的推理阶段是不必要的,是浪费资源的。
基于这两个区别,类里带了一对 encode() 和 decode() 方法,便于后面写推理函数。
6.6.3 Transformer 的优化器
Transformer 的优化器用的是我们之前用过的 Adam 优化器。
config_adam_beta1: float = 0.9
config_adam_beta2: float = 0.98
config_adam_eps: float = 1e-9
optimizer = torch.optim.Adam(
    model.parameters(),
    betas=(config_adam_beta1, config_adam_beta2),
    eps=config_adam_eps,
)
6.6.4 配角三:LabelSmoothingLoss
Transformer 发表的一年半前,2015 年 12 月,Google 的 Christian Szegedy、Vincent Vanhoucke、Sergey Ioffe 等人于 CVPR 2016 发表 《Rethinking the Inception Architecture for Computer Vision》。为了改进 Inception 网络的训练稳定性与泛化能力,它们重新设计了 Inception 结构,提出了 Label Smoothing 正则化方法。
所谓「Label Smoothing」是这样一个效果。
| 状态 | cat (目标词) | dog | bird | fish |
|---|---|---|---|---|
| Smoothing 前 | 1.0 | 0.0 | 0.0 | 0.0 |
| Smoothing 后 | 0.90 | 0.033 | 0.033 | 0.033 |
表 6-6 Label Smoothing 前后的 Loss
其实很形象的。就像是拿 PhotoShop 里的「涂抹工具」,给这一行 Loss 给狠狠涂了一下。
Transformer 也采用了这个正则化方法,并应用在 Loss 上。这样可以防止降低模型预测的高分,提升低分。进而提升了模型的泛化性。
可以理解为让模型在预测时不要过于自信自己得到的那个结果,对于自己不想要的结果也不要过于否定。意即,「反」过拟合。
class LabelSmoothingLoss(nn.Module):
    def __init__(self, smoothing: float = 0.1):
        super().__init__()
        self.smoothing = smoothing

    def forward(self, logits: torch.Tensor, target: torch.Tensor) -> torch.Tensor:
        vocab_size = logits.size(-1)

        # 对 logits 进行 softmax 并取对数,得到各类别的对数概率
        log_probs = torch.nn.functional.log_softmax(logits, dim=-1)

        # 计算标准负对数似然损失
        #   gather 函数根据 target 的索引提取对应位置的 log_prob
        #   unsqueeze 和 squeeze 用于调整维度以匹配 target 的形状
        nll = -log_probs.gather(dim=-1, index=target.unsqueeze(-1)).squeeze(-1)

        # 计算平滑损失
        #   这里 sum(dim=-1) 对所有类别的 log_probs 求和。
        #   加上负号是因为 log_probs 是负数,-sum(log_probs) 相当于计算了一个均匀分布相关的分量。
        #   在数学上,这对应了将 epsilon 的概率质量均匀分配给所有词表项。
        smooth = -log_probs.sum(dim=-1)

        # 结合标准损失和平滑损失
        #   最终损失 = (1 - smoothing) * 真实标签的损失 + (smoothing / vocab_size) * 均匀分布损失
        loss = (1.0 - self.smoothing) * nll + (self.smoothing / vocab_size) * smooth

        # 处理 Padding 部分
        #   创建掩码,target 不等于 PAD_ID 的位置为 1 (有效),等于 PAD_ID 的位置为 0 (无效)
        #   注意:运行此代码前需确保 PAD_ID 已在全局定义
        mask = (target != PAD_ID).float()

        # 计算加权平均损失
        #   将无效部分的损失置零,求和后除以有效 token 的总数
        #   clamp(min=1) 是为了防止 mask.sum() 为 0 时出现除以 0 的错误
        loss = (loss * mask).sum() / mask.sum().clamp(min=1)
        return loss

config_label_smoothing: float = 0.1
criterion = LabelSmoothingLoss(smoothing=config_label_smoothing)
6.6.5 单 Epoch 训练方法
编写训练代码之前,我们先写一个验证函数。目的是在验证集上计算 Loss。
因为一个稳定的训练是训练集和验证集的 Loss 同时稳定下降。
如果训练集 Loss 下降,验证集 Loss 不下降,那就是过拟合了。那我们得提前察觉,别训了半天训废了,浪费计算资源和我们自己的时间。
# 这只是验证一下。这不是前向推理,不要记录梯度用于反向传播
@torch.no_grad()
def validate(
    model: Seq2SeqTransformer,
    dataloader: DataLoader,
    criterion: LabelSmoothingLoss,
    device: torch.device,
) -> float:

    # 切换到推理模式
    #   这意味着:
    #   1. 关闭 Dropout;
    #   2. 沿用之前的 BatchNorm 均值和方差
    model.eval()
    total_loss = 0.0
    total_tokens = 0

    # 检查所有 batch
    for batch in dataloader:

        # 解包 batch 数据,并将所有张量移动到指定设备(如 GPU)上
        # src: 源序列, tgt_input: 目标序列输入, tgt_output: 目标序列输出
        # src_mask, tgt_mask, memory_mask: 各种掩码张量
        src, tgt_input, tgt_output, src_mask, tgt_mask, memory_mask = [
            x.to(device) for x in batch
        ]

        # AMP 就是 Automatic Mixed Precision 自动混合精度
        with torch.amp.autocast('cuda'):

            # 前向推理
            logits = model(src, tgt_input, src_mask, tgt_mask, memory_mask)

            # 将 logits 的形状从 [batch, seq_len, vocab_size] 重塑为 [batch*seq_len, vocab_size]
            # 调用 .float() 确保数据类型一致,防止混合精度下的类型不匹配问题
            logits = logits.reshape(-1, logits.size(-1)).float()

            # 将目标标签展平为 [batch*seq_len],以便与 logits 维度对应
            tgt_flat = tgt_output.reshape(-1)

            # 计算当前 batch 的损失值
            loss = criterion(logits, tgt_flat)

        # 计算当前 batch 中非填充token 的数量
        # PAD_ID 是填充符号的 ID,统计非填充符号是为了排除 padding 对 loss 计算的影响
        n_tokens = (tgt_flat != PAD_ID).sum().item()

        # 累计加权损失(loss.item() 是平均 loss,乘以 token 数得到总 loss)
        total_loss += loss.item() * n_tokens

        # 累计 token 总数
        total_tokens += n_tokens

    # 恢复为训练模式
    model.train()

    # 返回平均损失:总损失除以总 token 数
    # 使用 max(total_tokens, 1) 是为了防止除以 0 的错误(虽然通常验证集不为空)
    return total_loss / max(total_tokens, 1)
好了。开始我们的训练函数。
我们的训练函数用了 2 个用于特别常用的节省显存的技巧。
6.6.5.1 混合精度训练 AMP
这个直接开启就好,不太用我们费神;PyTorch 内部有哪些算子-设备对适合哪些精度的对应表。比如说,矩阵相乘这个算子在 blackwell 上用哪种精度,它内部已经存了一个 Hash。它的前向,反向,更新都会查这用一张表,我们就撒手给它就行了。
6.6.5.2 梯度累计 Gradient Accumulation
这是一个特别常用的,又很容易实现的技巧。理论上,我们应该把一整个 batch 都塞进去 GPU,一次算出 Loss。但是,显存不够的时候怎么办呢?就在批次里再分出「微批次」,分开算,算完了逐步累积出整个 batch 的 Loss。然后再一次性反向传播,更新参数。
一个思考题。既然 batch 已经是从整个数据集中分割出来的一部分了。那么,再分「微批次」又有什么意义呢?放不下,干脆直接把「微批次」变成 batch,算完了直接更新参数呗。
这个问题的答案在 4.4.9.1 一节。分出「微批次」是纯计算效率优化,但是 batch 不完全是因为显存放不下,它也是我们一个正则化手段。batch 的大小是要仔细调的,不能纯靠显存而定。换言之,即使我们的 GPU 能一次放下整个数据集,那也不一定就是我们的选择。
def train_epoch(
    model: Seq2SeqTransformer,
    dataloader: DataLoader,
    optimizer: torch.optim.Optimizer,
    criterion: LabelSmoothingLoss,
    config_grad_accum_steps: int,
    config_warmup_steps: int,
    config_d_model: int,
    config_log_every_steps: int,
    device: torch.device,
    global_step: int,
    scaler: Optional[torch.amp.GradScaler] = None,
) -> tuple[int, float, float]:
    """
    训练一个 epoch。
    返回: (更新后的全局步数, 平均损失, 困惑度)
    """
    model.train()

    # 使用 GPU 上的张量来累积统计数据。
    # 这样做的好处是避免了每次循环都调用 .item() 进行 CPU-GPU 同步,显著提高训练速度。
    total_loss = torch.tensor(0.0, device=device)
    total_tokens = torch.tensor(0, device=device)
    step_loss = torch.tensor(0.0, device=device)
    step_tokens = torch.tensor(0, device=device)

    # 记录 epoch 开始时间,一会儿用来预计训练时间
    epoch_start = time.time()

    # 启用自动混合精度训练
    use_amp = scaler is not None

    # 记录当前累积的微批次数量
    accum_count = 0  # actual micro-batches accumulated this group

    # 遍历每个 batch
    # 1 个 epoch 的意思就是把数据集整个跑一遍
    for batch_idx, batch in enumerate(dataloader):

        # 数据 CPU 搬到 GPU,non_blocking=True 异步传输,提高吞吐量
        src, tgt_input, tgt_output, src_mask, tgt_mask, memory_mask = [
            x.to(device, non_blocking=True) for x in batch
        ]

        # 累积一个微批次
        accum_count += 1

        if use_amp:
            # 开启混合精度
            with torch.amp.autocast('cuda'):
                logits = model(src, tgt_input, src_mask, tgt_mask, memory_mask)
                logits = logits.reshape(-1, logits.size(-1)).float()
                tgt_flat = tgt_output.reshape(-1)
                loss = criterion(logits, tgt_flat)
                # 将损失除以累积步数,以便在累积结束后梯度平均
                loss = loss / config_grad_accum_steps
            # 使用混合精度进行反向传播
            scaler.scale(loss).backward()
        else:
            # 普通 FP32 训练
            logits = model(src, tgt_input, src_mask, tgt_mask, memory_mask)
            logits = logits.reshape(-1, logits.size(-1))
            tgt_flat = tgt_output.reshape(-1)
            loss = criterion(logits, tgt_flat)
            loss = loss / config_grad_accum_steps
            loss.backward()

        # 累计微批次

        # 计算当前 batch 的有效 token 数(排除 padding)
        n_tokens = (tgt_flat != PAD_ID).sum()

        # 注意:这里乘回 grad_accum_steps 是为了还原真实的损失值用于统计
        step_loss += loss.detach() * config_grad_accum_steps * n_tokens
        step_tokens += n_tokens
        total_loss += loss.detach() * config_grad_accum_steps * n_tokens
        total_tokens += n_tokens

        # 当累积达到设定步数,或者是最后一个 batch 时,执行更新
        is_last_batch = (batch_idx + 1) == len(dataloader)
        should_step = ((batch_idx + 1) % config_grad_accum_steps == 0) or is_last_batch

        if should_step:

            # 如果是最后一个 batch 且累积数不足,需要对梯度进行修正
            # 例如:设定累积4步,但最后只有1步数据,梯度只累积了1/4,需要乘以 1/4 修正系数
            if accum_count != config_grad_accum_steps:
                scale_correction = accum_count / config_grad_accum_steps
                for p in model.parameters():
                    if p.grad is not None:
                        p.grad.mul_(scale_correction)

            if use_amp:
                # 混合精度反缩放梯度,以便裁剪或检查
                scaler.unscale_(optimizer)
                # 混合精度更新参数
                scaler.step(optimizer)
                # 混合精度更新缩放因子
                scaler.update()
            else:
                optimizer.step()

            # 重置梯度
            optimizer.zero_grad()

            # 全局步数增加
            global_step += 1

            # 重置微批次
            accum_count = 0

            # 如果配置了 warmup,根据当前步数计算学习率
            if config_warmup_steps > 0:
                lr = get_learning_rate(global_step, config_d_model, config_warmup_steps)
                for param_group in optimizer.param_groups:
                    param_group["lr"] = lr
            else:
                lr = optimizer.param_groups[0]["lr"]
        else:
            # 如果不需要更新,继续循环微批次,保持当前学习率用于日志显示
            lr = optimizer.param_groups[0]["lr"]

        # 打印训练日志
        if (batch_idx + 1) % config_log_every_steps == 0:
            elapsed = time.time() - epoch_start
            steps_done = batch_idx + 1
            total_steps_est = len(dataloader)

            # 计算 ETA
            eta_seconds = (elapsed / steps_done) * (total_steps_est - steps_done)

            sl = step_loss.item()
            st = step_tokens.item()
            avg_loss = sl / max(st, 1)

            # 计算 PPL 困惑度,限制 loss 最大值防止 exp 溢出
            ppl = math.exp(min(avg_loss, 100))

            print(
                f"  Step {global_step:6d} | "
                f"Batch {batch_idx + 1:5d}/{len(dataloader)} | "
                f"Loss {avg_loss:.4f} | "
                f"PPL {ppl:.1f} | "
                f"LR {lr:.2e} | "
                f"ETA {eta_seconds/60:.0f}m{eta_seconds%60:.0f}s"
            )

            # 重置步骤统计器
            step_loss = torch.tensor(0.0, device=device)
            step_tokens = torch.tensor(0, device=device)

    # 合计本 Epoch 的指标
    avg_loss = total_loss.item() / max(total_tokens.item(), 1)
    ppl = math.exp(min(avg_loss, 100))
    return global_step, avg_loss, ppl
6.6.6 保存和载入模型
这次我们训练完了之后,我们得用 torch.save() 把模型保存下来。
毕竟这次要耗费几十个小时的训练时间,直接丢了太可惜了。
而且,不保存下来,再现也麻烦。
def get_model_for_save(model: nn.Module) -> nn.Module:

    # 如果模型经过 torch.compile 编译,模型对象会被封装,原始模型存储在 _orig_mod 属性中。
    # 保存封装后的模型可能会导致无法恢复训练或兼容性问题,因此需要提取原始模型保存。
    return model._orig_mod if hasattr(model, "_orig_mod") else model


def save_checkpoint(
    model: nn.Module,
    optimizer: torch.optim.Optimizer,
    step: int,
    epoch: int,
    path: str,
):
    """
    保存训练快照,包括模型权重、优化器状态和训练进度。
    """
    checkpoint = {
        "model_state_dict": model.state_dict(),
        "optimizer_state_dict": optimizer.state_dict(),
        "step": step,
        "epoch": epoch,
    }
    # 建目录
    os.makedirs(os.path.dirname(path), exist_ok=True)

    # 存模型
    torch.save(checkpoint, path)

def load_checkpoint(
    path: str,
    model: nn.Module,
    optimizer: Optional[torch.optim.Optimizer],
    device: torch.device,
) -> tuple[int, int, list[float], list[float], float]:

    # 从磁盘加载检查点
    checkpoint = torch.load(path, map_location=device, weights_only=False)

    # 将加载的参数加载到模型中
    model.load_state_dict(checkpoint["model_state_dict"])

    # 如果传入了优化器对象,则恢复优化器状态
    if optimizer is not None:
        optimizer.load_state_dict(checkpoint["optimizer_state_dict"])

    # 返回训练进度信息:步数 和 轮数
    return (
        checkpoint["step"],
        checkpoint["epoch"],
    )
6.6.7 开始训练
因为这次训练花费的时间太长,失败一次的成本太高。我们得给它上点手段了。
都是大模型训练时常用的手段。
6.6.7.1 困惑度 PPL
每个 Step 后我们会打印一行日志,方便我们观察目前训练情况怎样了。
日志里有 Loss,这是最重要的指标,毕竟我们做的一切就是为了让它稳定下降。
另外,我们还会打印一个值叫做 PPL,它是 Perplexity 这个单词的缩写,常被翻译成「困惑度」。
这也是一个非常流行的指标,它的计算方法是这样的。
式 6-26 PPL 的计算方法
就是用自然对数 e 做底,算一个 loss 次幂。
是不是有点感觉? 我们这种交叉熵的 loss 不就是用 log 算出来的么?加上一个这个逆运算会算出来什么呢?
式 6-27 PPL 的实际含义
能看到,PPL 把交叉熵里原来被 log() 给封印的连乘又给释放了出来,它的实际意思是数据集中的正确答案的那个 Token 在我们的模型推理得出的概率的倒数。
有点抽象,我们用两个极端的例子来说具像化一下它的含义。
假设我们有一个 5 个词的词表。
情况一:网络还没开始训练,此时网络对语言一无所知。那么此时每个词出现的概率是一样的,都是 0.2。那么,正确答案就是用 0.2 这个概率去算的交叉熵。
式 6-28 训练前的 PPL
情况二:网络训练中途,此时网络可以理解一部分语言了。假设此时正确答案被模型推理出来的概率假设是 0.5。
式 6-29 训练中的 PPL
情况三:网络训练结束了,此时网络已经可以精确预测下一个词。那么此时正确答案被模型推理出来的概率假设是 1。
式 6-30 训练后的 PPL
观察可以发现,训练前的 PPL 和词表大小是一样的,随着训练的进程逐步变小,直至训练成了 1。
所以,有一种对 PPL 的流行的理解 —— 模型在多少个词之间犹豫。
虽然这个理解并不太符合数学上的原理,但相当直观易记。
虽然不同大小的词表之间比较 PPL 没有意义,但通常 PPL 应该被降低到至少 2 位数。
6.6.7.2 配角四: WarmUp
Transformer 最初的灵感火花来自 Jakob Uszkoreit,当时他在 Google 做翻译。他发明了自注意力,想试试能不能这样增强 RNN 对语言的理解。
随后呢,他又找了搞了做问答系统的 Illia Polosukhin 和刚加入 Google Brain 的 Ashish Vaswani。三个人起了 Transformer 这个名字就开始折腾落地这个想法。
随后,他们又各自拉了自己的下级和实习生一起折腾。Uszkoreit 拉了 Niki Parmar,Polosukhin 拉了 Llion Jones。
后来又来了 Łukasz Kaiser,他又拉了自己的实习生 Aidan Gomez 入伙。
至此,8 个作者齐了 7 位。折腾了很久,也没把这个网络给训练好。
事情的转折来自最后一位作者 Noam Shazeer。他说,有一天他路过 Kaiser 的工位,听见 Vaswani 和 Parmar 很兴奋地聊自注意力。他站住听了一会儿,决定用这种机制来改善他正在折腾的 RNN 网络。
他完全抛弃了项目之前的设计,自己完全重做了一遍。做了很多消融实验,最终使得 Transformer 成功收敛。
据说他最后做出来的版本比原本的设计简洁了非常多,也就是我们目前看到的这一版。
具体 Noam Shazeer 都做了哪些实验,搞了哪些 Trick 我们已经不得而知了。
但是,其中有一个我们知道肯定是出自他的手笔。那就是用他的名字命名的 Noam Schedule。
这是一个应用在学习率上的 Trick。
Noam Schedule 使用这样的一个公式来算出当前应该使用的学习率。
式 6-31 Noam Schedule 计算方法
这个方法是根据总的训练 step 和一个所谓 warm up 的 step 综合算出当前的学习率。运用这个方法算出的学习率就像下图这样。
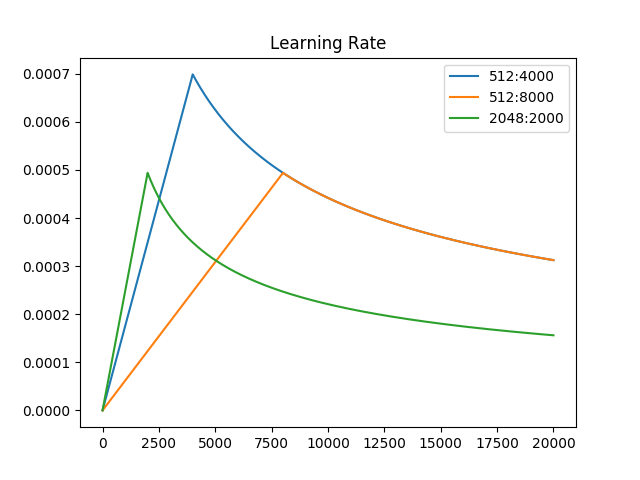
图 6-13 Noam schedule
可以观察到,和我们之前一直下降的学习率不同的是,它在前面有一段上升期。
后面一直下降的部分我们是理解的,越靠近目标就越要精细的调整。以免我们的 loss 来往震荡或者错过最优点。
前面的上升段的设计目的是什么呢?
如果没有前面的上升段,只有下降段的话,就意味着一开始需要把学习率设为一个很大的值。
网络一开始的参数都是随机初始化的,很大的学习率会带导致参数和 Loss 的大更新,进而带来把 Loss 训飞的风险。
所以设计前面这一个上升段,让随机初始化的参数们稍微适应一下当前的数据集,逐渐变得不那么随机。等训飞的风险降下来了,再增大学习率去让网络快速收敛。
这前面的上升段就好像是学习率的 Warm Up 热身阶段,这类方法由此得名。
6.6.7.3 早停 Early Stopping
这是另一个常见的训练策略。
我们前向推理、反向传播的目的是把训练集的 loss 往下降。降低训练集的目的是让网络在他没见过的数据上表现出和训练集一样的行为,即在测试集上 loss 下降。
如果训练集 loss 下降,但是测试集的 loss 不下降。一次二次我们可以认为是误差。如果累积了很多次,那我们就认为模型被训得过拟合了,在当前的架构和参数下已经到达它的极限。
那我们就早早停下训练就好了,只保留过拟合前的最后一版模型就行。这种训练策略就叫早停 Early Stopping。
万事齐备,我们开始训练。
def get_learning_rate(step: int, d_model: int, warmup_steps: int) -> float:
    arg1 = step ** (-0.5)
    arg2 = step * (warmup_steps ** (-1.5))
    return (d_model ** (-0.5)) * min(arg1, arg2)

# 设置最大训练轮数,论文中约训练了 10 万步
config_max_epochs: int = 12

# 打印训练前日志
print("=" * 60)
print(f"  Training pairs: {len(full_train):,}")
print(f"  Validation pairs: {len(full_val):,}")
print(f"  BPE vocabulary: {tokenizer.vocab_size():,} tokens (shared)")
print(f"  Batch size: {config_batch_size}")
print(f"  Max epochs: {config_max_epochs}")

import time
import gc

# 初始化早停计数器
patience = 0

# 早停容忍阈值:连续4轮没改善则停
max_patience = 4

# 初始化一个自动混合精度的梯度缩放器
scaler = torch.amp.GradScaler('cuda')

start_epoch = 0
global_step = 0
config_grad_accum_steps = 10
config_warmup_steps = 4000
config_log_every_steps = 50
best_val_loss = float("inf")

# 开始 Epoch 循环
for epoch in range(start_epoch + 1, config_max_epochs + 1):
    print(f"\n--- Epoch {epoch}/{config_max_epochs} ---")
    gc.collect()

    # 训练一个 Epoch
    epoch_start = time.time()
    global_step, train_loss, train_ppl = train_epoch(
        model, train_loader, optimizer, criterion,
        config_grad_accum_steps,
        config_warmup_steps,
        config_d_model,
        config_log_every_steps,
        device, global_step, scaler,
    )
    epoch_time = time.time() - epoch_start

    # 在验证集上计算 Loss
    val_loss = validate(model, val_loader, criterion, device)
    val_ppl = math.exp(min(val_loss, 100))

    # 打印 Epoch 日志
    print(
        f"Epoch {epoch:3d} | "
        f"Train Loss: {train_loss:.4f} PPL: {train_ppl:.1f} | "
        f"Val Loss: {val_loss:.4f} PPL: {val_ppl:.1f} | "
        f"Time: {epoch_time/60:.1f}m | "
        f"LR: {optimizer.param_groups[0]['lr']:.2e}"
    )

    # 如果在验证集上 Loss 改善了,则把当前模型保存下来
    is_best = val_loss < best_val_loss
    if is_best:
        best_val_loss = val_loss
        patience = 0
        save_checkpoint(
            get_model_for_save(model),
            optimizer, global_step, epoch,
            os.path.join(config_checkpoint_dir, "best_model.pt"),
        )
        print(f"  New best model saved (val_loss={best_val_loss:.4f})")
    else:
        # 如果没改善,累计早停计数器
        patience += 1

    # 保存最新的检查点,无聊是否有改善
    save_checkpoint(
        get_model_for_save(model),
        optimizer, global_step, epoch,
        os.path.join(config_checkpoint_dir, "latest.pt"),
    )

    # 早停
    if patience >= max_patience:
        print(f"\nEarly stopping after {max_patience} epochs without improvement.")
        break
这段训练代码在我租的 RTX 5090 32G 上跑了快 22 小时。
图 6-14 Transformer 训练时长
2017 年,Transformer 是在 8 张 NVIDIA P100 GPU 上训练了 12 个小时。我们就只用了一张消费级的 5090,虽然 GPU 也没吃满,也还行吧……
We trained our models on one machine with 8 NVIDIA P100 GPUs. For our base models using the hyperparameters described throughout the paper, each training step took about 0.4 seconds. We trained the base models for a total of 100,000 steps or 12 hours. For our big models,(described on the bottom line of table 3), step time was 1.0 seconds. The big models were trained for 300,000 steps (3.5 days).
我们的训练返回了以下的 log 信息。
============================================================
  Training pairs: 4,350,000
  Validation pairs: 150,000
  BPE vocabulary: 37,000 tokens (shared)
  Batch size: 48
  Max epochs: 12

--- Epoch 1/12 ---
  Step      5 | Batch    50/90625 | Loss 10.3361 | PPL 30827.1 | LR 8.73e-07 | ETA 146m54s
  Step     10 | Batch   100/90625 | Loss 10.2771 | PPL 29059.0 | LR 1.75e-06 | ETA 133m21s
  Step     15 | Batch   150/90625 | Loss 10.2624 | PPL 28635.7 | LR 2.62e-06 | ETA 129m21s
  Step     20 | Batch   200/90625 | Loss 10.2405 | PPL 28015.4 | LR 3.49e-06 | ETA 125m36s
  Step     25 | Batch   250/90625 | Loss 10.2190 | PPL 27419.3 | LR 4.37e-06 | ETA 122m51s
  Step     30 | Batch   300/90625 | Loss 10.1865 | PPL 26543.6 | LR 5.24e-06 | ETA 122m36s
  Step     35 | Batch   350/90625 | Loss 10.1585 | PPL 25808.6 | LR 6.11e-06 | ETA 118m48s
  Step     40 | Batch   400/90625 | Loss 10.1276 | PPL 25023.5 | LR 6.99e-06 | ETA 115m18s
  Step     45 | Batch   450/90625 | Loss 10.0900 | PPL 24101.2 | LR 7.86e-06 | ETA 114m21s
  Step     50 | Batch   500/90625 | Loss 10.0522 | PPL 23206.2 | LR 8.73e-06 | ETA 111m4s

...

  Step 108748 | Batch 90550/90625 | Loss 2.9652 | PPL 19.4 | LR 1.34e-04 | ETA 0m5s
  Step 108753 | Batch 90600/90625 | Loss 2.9270 | PPL 18.7 | LR 1.34e-04 | ETA 0m2s
Epoch  12 | Train Loss: 2.9536 PPL: 19.2 | Val Loss: 2.8955 PPL: 18.1 | Time: 104.9m | LR: 1.34e-04
  New best model saved (val_loss=2.8955)
可以观察到,我们的 Loss 一直在顺利下降,直到最后一轮都有所改善。
最后 PPL 降到了 18.1 ,和论文里的 4.92 还是有所差距,但感觉也是一个可以接受的值。
训练期间,机器的资源占用如下。
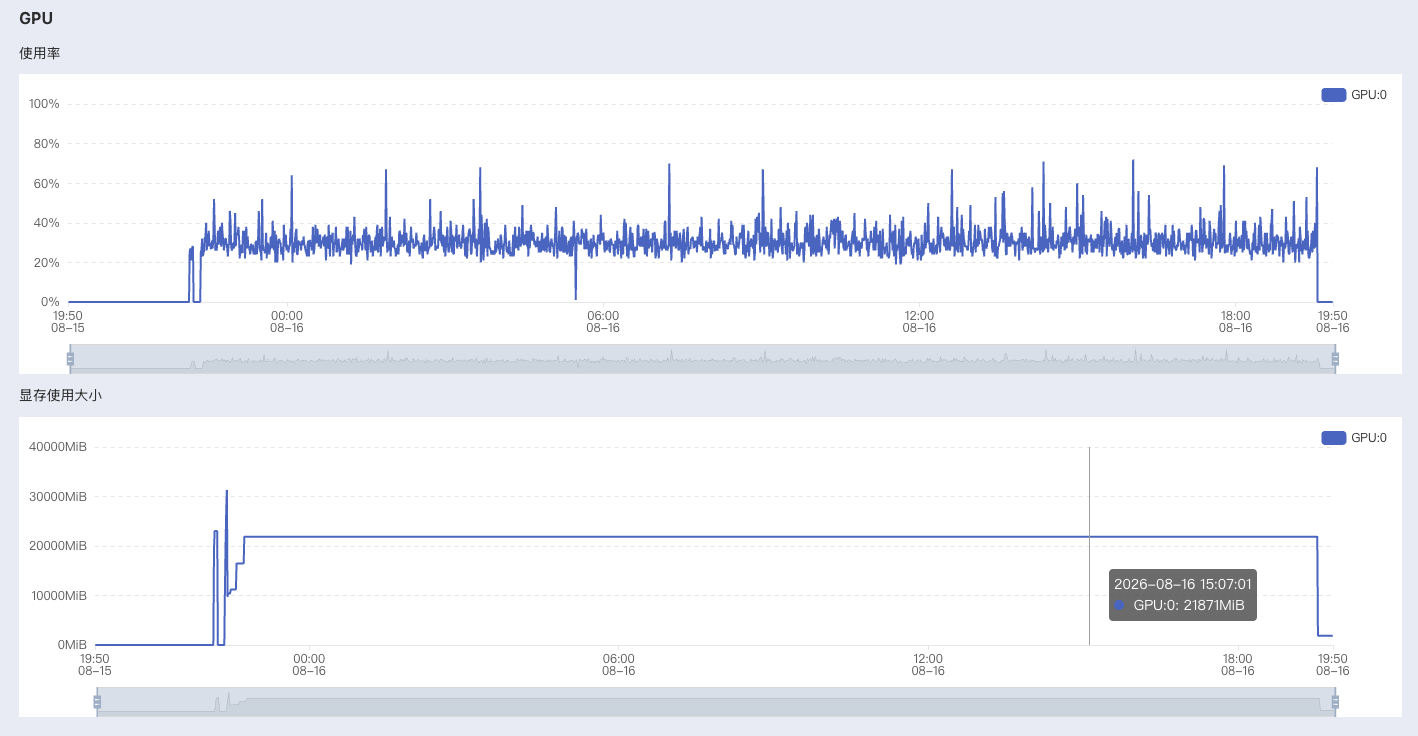
图 6-15 训练期间 GPU 和显存的使用情况
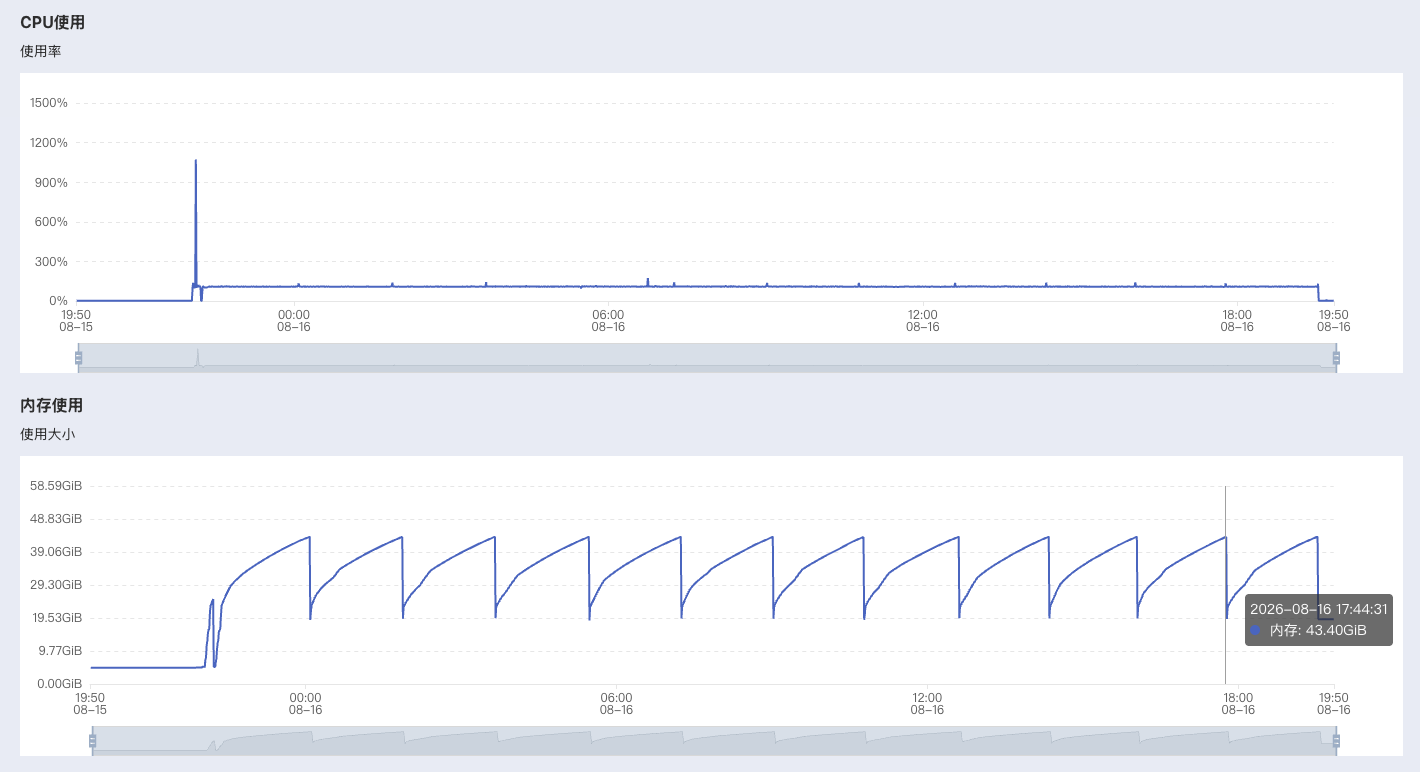
图 6-16 训练期间 CPU 和内存的使用情况
6.6.8 推理测试
训练好了。我们来写我们的推理函数。
6.6.8.1 贪心解码 Greedy Decoding
我们知道大模型是一个字一个字往外蹦词的,因为它一次只能预测一个词。每次它会预测整张词表里所有词适合放在下一个词的概率。
我们要把一个一个的词组成句子。最简单的方式就是每次都选词表中概率最高的,模型最推荐的那个词。这种选法被称为是「贪心解码」Greedy Decoding。
我们当然希望选概率高的,模型自信力强的词。可是,「贪心解码」有一个和贪心算法一样的问题,它有点过于短视了。
下一个词的选择是要带上这一次的词去计算的,我们当前选的最优解可能会导致我们后面选不到最优解。
图 6-17 贪婪解码可能导致的问题
实际用起来就是,虽然每一步都选了概率最大的选项,可最后连起来可能是一个词不达意的句子。
我们用另一种方法来做推理。
6.6.8.2 束搜索 Beam Search
所谓「束搜索」,就是多看几步。
找几个概率都比较高的词,分别往都后推几步,看看哪个能发展得更好一些。
每一步都多选几个,最后发散开来,就像一个「束」的形状一样。
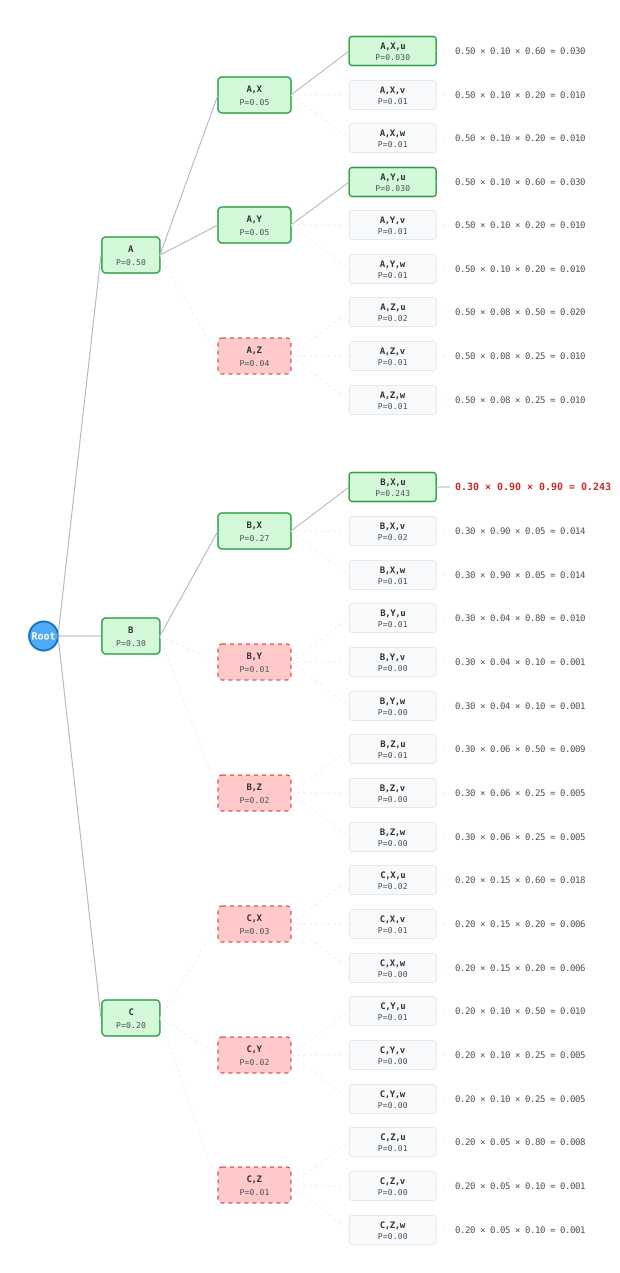
图 6-18 束搜素
从上图可以看出来,第一步概率最高的词,对于整个句子来说未必是最好的词。
我们最后选择每一步的概率相乘得到的联合概率最高的那句话作为我们最初的输出。
注意,连乘又来了。我们的概率都是小数,肯定都是越乘越小的。
我们收到 <eos> 标记才会结束一句话,很难说所有路径输出的句子一样长。有长有短的句子们比赛,长句里词多,算起联合概率肯定吃亏。
但其实句子的优劣和它的长短并没有什么必要关系。公平起见,我们给句子乘上一个关于长度的评分修正。
式 6-32 计算带长度修正的束搜索得分
这里,我们再度应用了 log() 可以把连乘变连加的特性。
最后,我们把所有的句子,按照修正后的得分排序,排最上面的那句话就是我们的最终选择。
@torch.no_grad()
def translate(
    model: Seq2SeqTransformer,
    tokenizer: BPETokenizer,
    text: str,
    max_len: int = 256,
    beam_size: int = 4,
    length_penalty: float = 0.6,
    device: torch.device = torch.device("cuda"),
) -> tuple[str, float]:

    # 开启推理模式
    model.eval()

    # 对输入文本进行 BPE 编码,并截断至最大长度
    src_ids = tokenizer.encode(text)[:max_len]

    # 转为 Tensor 并增加 batch 维度 [1, seq_len]
    src_tensor = torch.tensor([src_ids], dtype=torch.long).to(device)

    # 生成源语言的 attention mask,目的是排除 Padding (1 表示有效 token,0 表示 padding)
    src_mask = (src_tensor != PAD_ID).unsqueeze(1).unsqueeze(2)

    # 用编码器获取理解原文全文的隐变量
    memory = model.encode(src_tensor, src_mask)

    # 初始化束搜索相关变量
    beams: list[tuple[list[int], float, bool]] = [([BOS_ID], 0.0, False)]
    completed: list[tuple[list[int], float]] = []

    # 开始一个一个往外吐词
    for _ in range(max_len):

        # 是否结束吐词
        if not beams:
            break

        candidates: list[tuple[list[int], float, bool]] = []

        for tokens, score, finished in beams:
            # 如果序列已经结束,直接保留,不做扩展
            if finished:
                candidates.append((tokens, score, True))
                continue

            # 如果最后一个 token 是 EOS,则移入 completed 列表,并标记为结束
            if tokens[-1] == EOS_ID:
                completed.append((tokens, score))
                candidates.append((tokens, score, True))
                continue

            # 准备当前步的输入 tensor
            tgt_tensor = torch.tensor([tokens], dtype=torch.long).to(device)

            # 准备 target 的 padding mask
            tgt_pad_mask = (tgt_tensor != PAD_ID).unsqueeze(1).unsqueeze(2)

            # 构建因果掩码,确保只能看到当前位置之前的 token
            causal_mask = torch.tril(
                torch.ones(len(tokens), len(tokens), dtype=torch.bool, device=device)
            )

            # 合并 padding mask 和因果 mask
            tgt_mask = tgt_pad_mask & causal_mask.unsqueeze(0).unsqueeze(0)

            # 运行解码器,获取 logits
            logits = model.decode(tgt_tensor, memory, tgt_mask, src_mask)

            # 取最后一个时间步的 logits,计算 log 概率
            log_probs = torch.nn.functional.log_softmax(logits[0, -1, :], dim=-1)

            # 抑制 <unk> token 的生成,将其概率设为负无穷
            log_probs[UNK_ID] = float("-inf")

            # 取出概率最高的 top-k 个 token
            topk_log_probs, topk_indices = torch.topk(log_probs, beam_size)

            # 扩展候选
            for i in range(beam_size):
                token_id = topk_indices[i].item()
                new_score = score + topk_log_probs[i].item()
                new_tokens = tokens + [token_id]
                candidates.append((new_tokens, new_score, token_id == EOS_ID))

        # 根据长度惩罚后的分数对候选进行排序
        candidates.sort(
            key=lambda x: x[1] / (len(x[0]) ** length_penalty),
            reverse=True,
        )

        # 保留分数最高的 beam_size 个候选
        beams = candidates[:beam_size]

        # 如果所有当前 beam 都已结束生成,提前退出循环
        if all(finished for _, _, finished in beams):
            break

    # 把束中的 tokens 放到数组里
    if not completed:
        for tokens, score, _ in beams:
            completed.append((tokens, score))

    # 对最终结果按长度惩罚分数排序,选取最佳结果
    completed.sort(key=lambda x: x[1] / (len(x[0]) ** length_penalty), reverse=True)
    best_ids = completed[0][0]
    best_score = completed[0][1]

    # 过滤掉特殊 token (BOS, EOS, PAD) 并解码为文本
    decoded_ids = [i for i in best_ids if i not in (BOS_ID, EOS_ID, PAD_ID)]
    result = tokenizer.decode(decoded_ids)

    return result, best_score
用我们的推理函数翻译几个英文例句试试。
print("\n" + "=" * 60)
print("Final: Test Translation")
print("=" * 60)

# 模型路径
best_path = os.path.join(config_checkpoint_dir, "best_model.pt")

if os.path.exists(best_path):

    # 在 GPU 上初始化模型结构
    infer_model = Seq2SeqTransformer(
        config_shared_vocab_size=config_shared_vocab_size,
        config_d_model=config_d_model,
        config_max_seq_len=config_max_seq_len,
        config_dropout=config_dropout,
        config_n_heads=config_n_heads,
        config_d_ff=config_d_ff,
        config_n_encoder_layers=config_n_encoder_layers,
        config_n_decoder_layers=config_n_decoder_layers
    ).to(device)

    # 加载训练好的权重
    load_checkpoint(best_path, infer_model, None, device)

    # 开启推理模式
    infer_model.eval()

    # 测试例句
    test_sentences = [
        "The weather is nice today .",
        "I have two brothers .",
        "She went to school yesterday .",
        "He is reading a book .",
    ]

    # 用例句翻译试试
    print("\nSample translations:")
    for sent in test_sentences:
        result, score = translate(
            infer_model, tokenizer, sent,
            max_len=config_max_seq_len // 2, beam_size=4, device=device,
        )
        print(f"  EN: {sent}")
        print(f"  CN: {result}")
        print(f"  Score: {score:.2f}")
        print()

    # 清理显存
    del infer_model
    torch.cuda.empty_cache()

# 打印训练总结信息
print("\n--- Training Summary ---")
print(f"Final Epoch: {epoch}")
print(f"Final Step: {global_step}")
print(f"Best Val Loss: {best_val_loss:.4f}")
print("\nDone!")
执行上面的代码,我们得到以下输出。
============================================================
Final: Test Translation
============================================================

Sample translations:
  EN: The weather is nice today .
  CN: 今天天气很好。
  Score: -1.64

  EN: I have two brothers .
  CN: 我有两个兄弟。
  Score: -1.05

  EN: She went to school yesterday .
  CN: 她昨天上学了。
  Score: -2.54

  EN: He is reading a book .
  CN: 他在看书。
  Score: -2.84


--- Training Summary ---
Final Epoch: 12
Final Step: 108756
Best Val Loss: 2.8955

Done!
翻译得还不错!
来 2 个远距离指代和多重子句嵌套的长难句试试看。
infer_model = Seq2SeqTransformer(
    config_shared_vocab_size=config_shared_vocab_size,
    config_d_model=config_d_model,
    config_max_seq_len=config_max_seq_len,
    config_dropout=config_dropout,
    config_n_heads=config_n_heads,
    config_d_ff=config_d_ff,
    config_n_encoder_layers=config_n_encoder_layers,
    config_n_decoder_layers=config_n_decoder_layers
).to(device)

load_checkpoint(best_path, infer_model, None, device)

infer_model.eval()

sent = "The fact that the scientist who the committee had appointed to oversee the project which was funded by the government ignored the safety protocols resulted in a catastrophic failure."
result, score = translate(
            infer_model, tokenizer, sent,
            max_len=config_max_seq_len // 2, beam_size=4, device=device,
        )
print(f"  EN: {sent}")
print(f"  CN: {result}")
print()

sent = "I have nothing in common with lazy people who blame others for their lack of success; I believe that if you are not willing to learn, no one can help you, and if you are determined to learn, no one can stop you."
result, score = translate(
            infer_model, tokenizer, sent,
            max_len=config_max_seq_len // 2, beam_size=4, device=device,
        )
print(f"  EN: {sent}")
print(f"  CN: {result}")
print()
我们得到输出如下。
  EN: The fact that the scientist who the committee had appointed to oversee the project which was funded by the government ignored the safety protocols resulted in a catastrophic failure.
  CN: 委员会任命监督这个由政府资助的项目的科学家无视安全规程,造成了灾难性的失败。

  EN: I have nothing in common with lazy people who blame others for their lack of success; I believe that if you are not willing to learn, no one can help you, and if you are determined to learn, no one can stop you.
  CN: 我认为,如果你不愿意学习,没有人能帮助你,如果你决心学习,没有人能阻止你。
Good Job ! Transformer ~
6.7 PyTorch 魔法版 Transformer
6.7.1 数据准备
数据准备还是需要我们自己来。就照着上面的版本抄一份就行。
这次我们把所有的配置变量都提出来放在最前面。
import os
import random
import math
import time
import csv
from typing import Optional
import torch
import torch.nn as nn
from torch.utils.data import Dataset, DataLoader
import sentencepiece as spm

random.seed(42)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print(f"Device: {device}")
if device.type == "cuda":
    print(f"GPU: {torch.cuda.get_device_name(0)}")

config_data_path = "./dataset/wmt_zh_en_training_corpus.csv"
config_checkpoint_dir = "./checkpoints"
os.makedirs(config_checkpoint_dir, exist_ok=True)

config_train_pairs: int = 4_350_000
config_val_pairs: int = 150_000

PAD_ID, UNK_ID, BOS_ID, EOS_ID = 0, 1, 2, 3

bpe_text_path = os.path.join(config_checkpoint_dir, "bpe_train.txt")
config_shared_vocab_size = 37_000

max_seq_len = 200
config_batch_size = 48
config_label_smoothing = 0.1
config_d_model = 512
config_n_heads = 8
config_n_encoder_layers = 6
config_n_decoder_layers = 6
config_d_ff = 2048
config_dropout = 0.1
config_warmup_steps = 4000
config_max_epochs = 12
config_grad_accum_steps = 10
config_log_every_steps = 50
config_grad_clip_norm = 1.0

config_adam_beta1: float = 0.9
config_adam_beta2: float = 0.98
config_adam_eps: float = 1e-9

config_qk_norm = True

# 混合精度用 bf16。bf16 的指数位和 fp32 一样多(8 bit),动态范围 3.4e38,
# 不存在 fp16 那个 65504 的上溢悬崖,也就不需要 GradScaler。
# 想做对照实验可以改成 torch.float16,代码会自动切回 GradScaler 路径。
config_amp_dtype = torch.bfloat16
config_use_amp = device.type == "cuda"
if config_amp_dtype == torch.bfloat16 and config_use_amp:
    assert torch.cuda.is_bf16_supported(), "bfloat16 is not supported on this GPU"

scaler = torch.amp.GradScaler('cuda', enabled=(config_use_amp and config_amp_dtype == torch.float16))
print(f"AMP: enabled={config_use_amp} dtype={config_amp_dtype} grad_scaler={scaler.is_enabled()}")

global_step = 0
best_val_loss = float("inf")
然后我们把数据处理,分词,然后拼装成 torch.utils.data.DataLoader 的逻辑照抄下来。
def load_and_sample_data(data_path: str, num_samples: int) -> list[tuple[str, str]]:
    reservoir: list[tuple[str, str]] = []
    total_lines = 0
    print(f"Sampling {num_samples:,} lines from {data_path}...")
    with open(data_path, "r", encoding="utf-8") as f:
        reader = csv.reader(f)
        next(reader)
        for row in reader:
            if len(row) < 2: continue
            cn_text = row[0].strip()
            en_text = row[1].strip()
            if not cn_text or not en_text: continue
            total_lines += 1
            pair = (en_text, cn_text)
            if len(reservoir) < num_samples:
                reservoir.append(pair)
            else:
                j = random.randint(0, total_lines - 1)
                if j < num_samples:
                    reservoir[j] = pair
    print(f" Sampled {len(reservoir):,} pairs from {total_lines:,} total lines")
    return reservoir

print("Loading data...")
all_pairs = load_and_sample_data(config_data_path, (config_train_pairs + config_val_pairs))

class BPETokenizer:
    def __init__(self, model_path: str):
        self.sp = spm.SentencePieceProcessor()
        self.sp.load(model_path)

    @classmethod
    def train(cls, text_file: str, model_prefix: str, vocab_size: int = 37000) -> "BPETokenizer":
        spm.SentencePieceTrainer.train(
            input=text_file, model_prefix=model_prefix, vocab_size=vocab_size,
            model_type="bpe", character_coverage=0.9995,
            pad_id=PAD_ID, unk_id=UNK_ID, bos_id=BOS_ID, eos_id=EOS_ID,
            pad_piece="<pad>", unk_piece="<unk>", bos_piece="<bos>", eos_piece="<eos>",
            split_digits=True, byte_fallback=False, minloglevel=2,
        )
        return cls(f"{model_prefix}.model")

    def encode(self, text: str, add_bos: bool = True, add_eos: bool = True) -> list[int]:
        ids = self.sp.encode(text, out_type=int)
        if add_bos: ids = [BOS_ID] + ids
        if add_eos: ids = ids + [EOS_ID]
        return ids

    def decode(self, ids: list[int], join_char: str = "") -> str:
        filtered = [int(i) for i in ids if int(i) not in (PAD_ID, BOS_ID, EOS_ID)]
        text = self.sp.decode(filtered)
        if join_char: text = text.replace(" ", join_char)
        return text

    def vocab_size(self) -> int: return self.sp.vocab_size()

# BPE 分词
bpe_text_path = os.path.join(config_checkpoint_dir, "bpe_train.txt")
with open(bpe_text_path, "w", encoding="utf-8") as f:
    for en, cn in all_pairs:
        f.write(en + "\n")
        f.write("".join(cn.strip().split()) + "\n")

tokenizer = BPETokenizer.train(bpe_text_path, model_prefix=os.path.join(config_checkpoint_dir, "bpe"), vocab_size=config_shared_vocab_size)
config_shared_vocab_size = tokenizer.vocab_size()
print(f"Vocab size: {config_shared_vocab_size:,}")

# 数据预处理
random.shuffle(all_pairs)
full_train = all_pairs[:config_train_pairs]
full_val = all_pairs[config_train_pairs : config_train_pairs+config_val_pairs]

def process_texts(texts, tokenizer, max_len):
    results = []
    chunk_size = 500_000
    for i in range(0, len(texts), chunk_size):
        chunk = texts[i:i+chunk_size]
        en_texts = [en for en, _ in chunk]
        cn_texts = ["".join(cn.strip().split()) for _, cn in chunk]
        src_ids_batch = tokenizer.sp.encode(en_texts, out_type=int)
        tgt_ids_batch = tokenizer.sp.encode(cn_texts, out_type=int)

        for src_ids, tgt_ids in zip(src_ids_batch, tgt_ids_batch):
            if len(src_ids) > max_len - 2: src_ids = src_ids[:max_len-2]
            if len(tgt_ids) > max_len - 2: tgt_ids = tgt_ids[:max_len-2]
            src_final = [BOS_ID] + src_ids + [EOS_ID]
            tgt_final = [BOS_ID] + tgt_ids + [EOS_ID]
            results.append((torch.tensor(src_final, dtype=torch.long), torch.tensor(tgt_final, dtype=torch.long)))
    return results

tokenized_train = process_texts(full_train, tokenizer, max_seq_len)
tokenized_val = process_texts(full_val, tokenizer, max_seq_len)

# 封装 DataLoader
class PreTokenizedDataset(Dataset):
    def __init__(self, pairs): self.pairs = pairs
    def __len__(self): return len(self.pairs)
    def __getitem__(self, idx): return self.pairs[idx]

def collate_fn(batch: list[tuple[torch.Tensor, torch.Tensor]]) -> tuple[torch.Tensor, ...]:
    src_batch, tgt_batch = zip(*batch)
    src_lens = [len(s) for s in src_batch]
    tgt_lens = [len(t) for t in tgt_batch]
    src_max_len, tgt_max_len = max(src_lens), max(tgt_lens)

    src_padded = torch.full((len(src_batch), src_max_len), PAD_ID, dtype=torch.long)
    tgt_padded = torch.full((len(tgt_batch), tgt_max_len), PAD_ID, dtype=torch.long)

    for i, s in enumerate(src_batch): src_padded[i, :len(s)] = s
    for i, t in enumerate(tgt_batch): tgt_padded[i, :len(t)] = t

    tgt_input = tgt_padded[:, :-1]
    tgt_output = tgt_padded[:, 1:]

    src_key_padding_mask = (src_padded == PAD_ID)
    tgt_key_padding_mask = (tgt_input == PAD_ID)

    return src_padded, tgt_input, tgt_output, src_key_padding_mask, tgt_key_padding_mask

train_loader = DataLoader(PreTokenizedDataset(tokenized_train),
        batch_size=config_batch_size,
        shuffle=True,
        collate_fn=collate_fn,
        num_workers=4)
val_loader = DataLoader(PreTokenizedDataset(tokenized_val),
        batch_size=config_batch_size,
        shuffle=False,
        collate_fn=collate_fn,
        num_workers=4)
这段代码执行后输出以下内容。
Loading data...
Sampling 4,500,000 lines from ./dataset/wmt_zh_en_training_corpus.csv...
 Sampled 4,500,000 pairs from 24,752,356 total lines
Vocab size: 37,000
6.7.2 照抄位置编码
PyTorch 里没有自带位置编码的实现,这一段我们抄过来。
class PositionalEncoding(nn.Module):
    def __init__(self, d_model: int, max_len: int = 5000, dropout: float = 0.1):
        super().__init__()
        self.dropout = nn.Dropout(p=dropout)
        pe = torch.zeros(max_len, d_model)
        position = torch.arange(0, max_len, dtype=torch.float).unsqueeze(1)
        div_term = torch.exp(torch.arange(0, d_model, 2).float() * (-math.log(10000.0) / d_model))
        pe[:, 0::2] = torch.sin(position * div_term)
        pe[:, 1::2] = torch.cos(position * div_term)
        pe = pe.unsqueeze(0) # (1, max_len, d_model)
        self.register_buffer("pe", pe)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        # x: (batch, seq_len, d_model)
        x = x + self.pe[:, :x.size(1)]
        return self.dropout(x)
6.7.3 照抄前馈网络
PyTorch 里没有自带的前馈网络,这一段我们抄过来。
class FeedForward(nn.Module):
    def __init__(self, d_model: int, d_ff: int, dropout: float = 0.1):
        super().__init__()
        self.linear1 = nn.Linear(d_model, d_ff)
        self.linear2 = nn.Linear(d_ff, d_model)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.linear2(self.dropout(torch.nn.functional.relu(self.linear1(x))))
6.7.4 PyTorch 内置层归一化
其实我们上面已经用上了 PyTorch 内置的层归一化,手写版本里唯一用了内置组件的部分。
内置的层归一化的调用方法是 nn.LayerNorm(d_model)。
它的第一个参数是指定从后面数有几个维度要做归一化。我们嵌入向量的所有维度都要归一化。我们是在 Sample 内部做归一化的嘛,把我们的嵌入向量维度传进去就好。
6.7.5 PyTorch 内置点积缩放注意力
2023 年 3 月,PyTorch 发布了 2.0 版本 。这个版本最重要的更新之一是增加了 内置的点积缩放注意力算子 或者简写为 SDPA。
具体来说,PyTorch 2.0 增加了 torch.nn.functional.scaled_dot_product_attention() 这个函数让我们可以更高效地计算注意力权重。
这个函数集成了 4 个后端来实际计算注意力。
- 来自斯坦福大学 Hazy Research 实验室的 flash-attn;
- 来自 Facebook xFormers 项目的 memory_efficient_attention;
- 来自 NVIDIA 的 cuDNN_attention;
- PyTorch 为没有 CUDA 的设备用 C++ 写的一份实现;
其中前三个后端共同使用了一个优化方法叫做 Flash Attention。
我们知道注意力是需要每个词和每个词去算注意力的,所以它的时间复杂度和空间复杂度都是 \(O(n^2)\)。一般正常的优化思路就是少算一点嘛,不要和全部的词去算注意力。比如说,只和自己周围的词去算。《Attention Is All You Need》里确实就是这样构想的,它在第 4 节这样表述到。
To improve computational performance for tasks involving very long sequences, self-attention could be restricted to considering only a neighborhood of size rin the input sequence centered around the respective output position.
这思路肯定没有问题,现在很多大模型也确实这么做的,这常常被称为是「稀疏注意力」。
但是,总有神人。2022 年 5 月,在斯坦福大学读博的 Tri Dao 发表了 《FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness》。他说他发现用降低模型质量的方式去换回计算的加速并非很有效,他发现注意力计算低效的根源在于重复的 IO 太多了。于是,他分片地把显存里的数据手动提到片上缓存里去计算,算完了再整体换回显存,直接把空间复杂度从 \(O(n^2)\) 降到了 \(O(n)\)。
图 6-19 Flash Attention
每个型号的 GPU 的片上缓存大小是不同的,而 Flash Attention 优化是基于手动交换片上缓存的,也就意味着它的实现是 per chip 的。动手实现这个优化需要读下 chip 的说明书,然后写 CUDA Kernel。这有点超出调用 PyTorch 的范畴,我们就不展开去理解它,也不手动实现它了。
总之,我们今天能用上这么上的上下文,Agent 应用能瞎往里堆提示词,是有这位仁兄的智力劳动的功劳在的。
图 6-20 Tri Dao
这 Tri Dao 也是个神人。他在公开 Flash Attention 这个想法后,动手实现了它。Meta、NVIDIA 等大厂也会实现自己的 Flash Attention。在这种情况下,Tri Dao 实现的版本在性能方面依然冠绝群雄。Github 仓库里 Tri Dao 的提交占了 90% 还多。并且,他一边迭代着 Flash Attention 各硬件的实现版本,保持着性能领先的同时,还能持续产出 Mamba 这种级别的创意。这是一位上可上天揽月、下可入海捉鳖的神人。
神人的劳动成果我们笑纳了。基于他的实现,我们实现我们新的多头注意力。
class MultiHeadAttention(nn.Module):
    # 基于 torch.nn.functional.scaled_dot_product_attention 的多头注意力,带可选的 QK-Norm。
    #
    # 掩码约定与 nn.MultiheadAttention 保持一致:传入的 attn_mask / key_padding_mask
    # 都是 True 表示遮蔽。注意 SDPA 的布尔 attn_mask 恰好相反(True 表示参与注意力),
    # 所以合并后要取反再交给 SDPA。

    # 类级开关:打开后 forward 会额外统计 max|score|,仅在要打印日志的那一步开启
    record_scores: bool = False

    def __init__(self, d_model: int, n_heads: int, dropout: float = 0.1, qk_norm: bool = True):
        super().__init__()
        assert d_model % n_heads == 0
        self.d_model = d_model
        self.n_heads = n_heads
        self.d_k = d_model // n_heads
        self.dropout_p = dropout

        # 三个投影分开写,而不是融合成一个 1536x512 的 in_proj_weight。
        # 这样 xavier_uniform_ 的 bound 是 sqrt(6/1024),与手写版一致
        self.w_q = nn.Linear(d_model, d_model)
        self.w_k = nn.Linear(d_model, d_model)
        self.w_v = nn.Linear(d_model, d_model)
        self.w_o = nn.Linear(d_model, d_model)

        # QK-Norm:把 q/k 每个头的向量归一化,模长被钉在 sqrt(d_k) 量级,
        # 注意力 logit 在数学上就无法跑飞,不需要任何截断阈值
        self.q_norm = nn.LayerNorm(self.d_k) if qk_norm else nn.Identity()
        self.k_norm = nn.LayerNorm(self.d_k) if qk_norm else nn.Identity()

        # 最近一次 record_scores 打开时记录的 max|score|
        self.last_max_score = 0.0

    def _split_heads(self, x: torch.Tensor, batch_size: int) -> torch.Tensor:
        return x.view(batch_size, -1, self.n_heads, self.d_k).transpose(1, 2)

    def forward(
        self,
        query: torch.Tensor,
        key: torch.Tensor,
        value: torch.Tensor,
        attn_mask: Optional[torch.Tensor] = None,
        key_padding_mask: Optional[torch.Tensor] = None,
    ) -> torch.Tensor:
        batch_size = query.size(0)

        q = self._split_heads(self.w_q(query), batch_size)
        k = self._split_heads(self.w_k(key), batch_size)
        v = self._split_heads(self.w_v(value), batch_size)

        q = self.q_norm(q)
        k = self.k_norm(k)

        # 合并因果掩码与 padding 掩码,True = 遮蔽
        masked: Optional[torch.Tensor] = None
        if attn_mask is not None:
            masked = attn_mask.view(1, 1, attn_mask.size(-2), attn_mask.size(-1))
        if key_padding_mask is not None:
            kpm = key_padding_mask.view(batch_size, 1, 1, -1)
            masked = kpm if masked is None else (masked | kpm)

        # 监控用:在 fp32 下显式算一次注意力分数,只统计不参与前向
        if MultiHeadAttention.record_scores:
            with torch.autocast(device_type=q.device.type, enabled=False):
                scores = torch.matmul(q.float(), k.float().transpose(-2, -1)) / math.sqrt(self.d_k)
                self.last_max_score = scores.abs().max().item()
                del scores

        # SDPA 的布尔掩码是 True = 参与注意力,与本模块的约定相反,故取反
        sdpa_mask = None if masked is None else ~masked
        out = torch.nn.functional.scaled_dot_product_attention(
            q, k, v,
            attn_mask=sdpa_mask,
            dropout_p=self.dropout_p if self.training else 0.0,
        )

        out = out.transpose(1, 2).contiguous().view(batch_size, -1, self.d_model)
        return self.w_o(out)
PyTorch 2.0 推出 SDPA 的同时,也基于 SDPA 更新了他们的 nn.MultiheadAttention 实现。拿我们实现的多头注意力和 PyTorch 实现的对比一下,看看误差有多大。
# 自检:验证 MultiHeadAttention 的掩码取反是否正确。
# 关掉 QK-Norm 和 dropout 后,本模块必须与 nn.MultiheadAttention 数值一致。
def selfcheck_attention_matches_pytorch(d_model=64, n_heads=4, batch=3, seq=7, tol=1e-5):
    torch.manual_seed(0)
    mine = MultiHeadAttention(d_model, n_heads, dropout=0.0, qk_norm=False).to(device).eval()
    ref = nn.MultiheadAttention(d_model, n_heads, dropout=0.0, batch_first=True).to(device).eval()

    with torch.no_grad():
        ref.in_proj_weight.copy_(torch.cat([mine.w_q.weight, mine.w_k.weight, mine.w_v.weight], dim=0))
        ref.in_proj_bias.copy_(torch.cat([mine.w_q.bias, mine.w_k.bias, mine.w_v.bias], dim=0))
        ref.out_proj.weight.copy_(mine.w_o.weight)
        ref.out_proj.bias.copy_(mine.w_o.bias)

        x = torch.randn(batch, seq, d_model, device=device)
        key_padding_mask = torch.zeros(batch, seq, dtype=torch.bool, device=device)
        key_padding_mask[:, seq - 2:] = True                                  # True = 遮蔽
        causal = torch.triu(torch.ones(seq, seq, dtype=torch.bool, device=device), diagonal=1)

        for label, am, kpm in [("padding only", None, key_padding_mask),
                               ("causal only", causal, None),
                               ("causal + padding", causal, key_padding_mask)]:
            got = mine(x, x, x, attn_mask=am, key_padding_mask=kpm)
            want, _ = ref(x, x, x, attn_mask=am, key_padding_mask=kpm, need_weights=False)
            diff = (got - want).abs().max().item()
            status = "OK" if diff < tol else "FAIL"
            print(f"  [{status}] {label:18s} max abs diff vs nn.MultiheadAttention: {diff:.3e}")
            assert diff < tol, f"attention mismatch on '{label}': {diff}"

print("Self-check: attention vs nn.MultiheadAttention")
selfcheck_attention_matches_pytorch()
print("Self-check passed.")
测试输出。
Self-check: attention vs nn.MultiheadAttention
  [OK] padding only       max abs diff vs nn.MultiheadAttention: 1.490e-07
  [OK] causal only        max abs diff vs nn.MultiheadAttention: 1.490e-07
  [OK] causal + padding   max abs diff vs nn.MultiheadAttention: 1.490e-07
Self-check passed.
还行,没啥问题。
6.7.6 拼装编码器和解码器
我们用内置的 nn.LayerNorm() 和刚刚基于 SDPA 实现的 MultiheadAttention ,重新拼装我们的编码器和解码器。
class EncoderLayer(nn.Module):
    def __init__(self, d_model: int, n_heads: int, d_ff: int, dropout: float = 0.1, qk_norm: bool = True):
        super().__init__()
        self.self_attn = MultiHeadAttention(d_model, n_heads, dropout=dropout, qk_norm=qk_norm)
        self.ff = FeedForward(d_model, d_ff, dropout)
        self.norm1 = nn.LayerNorm(d_model)
        self.norm2 = nn.LayerNorm(d_model)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x: torch.Tensor, src_key_padding_mask: Optional[torch.Tensor] = None) -> torch.Tensor:
        attn_out = self.self_attn(x, x, x, key_padding_mask=src_key_padding_mask)
        x = self.norm1(x + self.dropout(attn_out))
        ff_out = self.ff(x)
        x = self.norm2(x + self.dropout(ff_out))
        return x


class DecoderLayer(nn.Module):
    def __init__(self, d_model: int, n_heads: int, d_ff: int, dropout: float = 0.1, qk_norm: bool = True):
        super().__init__()
        # 自注意力
        self.self_attn = MultiHeadAttention(d_model, n_heads, dropout=dropout, qk_norm=qk_norm)
        # 交叉注意力
        self.cross_attn = MultiHeadAttention(d_model, n_heads, dropout=dropout, qk_norm=qk_norm)

        self.ff = FeedForward(d_model, d_ff, dropout)
        self.norm1 = nn.LayerNorm(d_model)
        self.norm2 = nn.LayerNorm(d_model)
        self.norm3 = nn.LayerNorm(d_model)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x: torch.Tensor, memory: torch.Tensor,
                tgt_mask: Optional[torch.Tensor] = None,
                tgt_key_padding_mask: Optional[torch.Tensor] = None,
                memory_key_padding_mask: Optional[torch.Tensor] = None) -> torch.Tensor:

        # 自注意力 (带因果掩码,True 表示遮蔽)
        attn_out = self.self_attn(x, x, x, attn_mask=tgt_mask, key_padding_mask=tgt_key_padding_mask)
        x = self.norm1(x + self.dropout(attn_out))

        # 交叉注意力 (Query 来自解码器,Key/Value 来自编码器)
        attn_out = self.cross_attn(x, memory, memory, key_padding_mask=memory_key_padding_mask)
        x = self.norm2(x + self.dropout(attn_out))

        # 前馈网络
        ff_out = self.ff(x)
        x = self.norm3(x + self.dropout(ff_out))
        return x


class Encoder(nn.Module):
    def __init__(self, d_model: int, n_heads: int, d_ff: int, n_layers: int, dropout: float, qk_norm: bool = True):
        super().__init__()
        self.layers = nn.ModuleList([
            EncoderLayer(d_model, n_heads, d_ff, dropout, qk_norm) for _ in range(n_layers)
        ])
        self.norm = nn.LayerNorm(d_model)

    def forward(self, x: torch.Tensor, src_key_padding_mask: Optional[torch.Tensor] = None) -> torch.Tensor:
        for layer in self.layers:
            x = layer(x, src_key_padding_mask=src_key_padding_mask)
        return self.norm(x)


class Decoder(nn.Module):
    def __init__(self, d_model: int, n_heads: int, d_ff: int, n_layers: int, dropout: float, qk_norm: bool = True):
        super().__init__()
        self.layers = nn.ModuleList([
            DecoderLayer(d_model, n_heads, d_ff, dropout, qk_norm) for _ in range(n_layers)
        ])
        self.norm = nn.LayerNorm(d_model)

    def forward(self, x: torch.Tensor, memory: torch.Tensor,
                tgt_mask: Optional[torch.Tensor] = None,
                tgt_key_padding_mask: Optional[torch.Tensor] = None,
                memory_key_padding_mask: Optional[torch.Tensor] = None) -> torch.Tensor:
        for layer in self.layers:
            x = layer(x, memory, tgt_mask=tgt_mask,
                      tgt_key_padding_mask=tgt_key_padding_mask,
                      memory_key_padding_mask=memory_key_padding_mask)
        return self.norm(x)
6.7.7 拼装 Transformer
我们把编码器和解码器拼装成 Transformer。
class Seq2SeqTransformer(nn.Module):
    def __init__(self, vocab_size, d_model, n_heads, d_ff, n_encoder_layers, n_decoder_layers, dropout, qk_norm=True):
        super().__init__()
        self.d_model = d_model
        self.embedding = nn.Embedding(vocab_size, d_model)
        self.pos_encoding = PositionalEncoding(d_model, dropout=dropout)

        self.encoder = Encoder(d_model, n_heads, d_ff, n_encoder_layers, dropout, qk_norm)
        self.decoder = Decoder(d_model, n_heads, d_ff, n_decoder_layers, dropout, qk_norm)

        self.fc_out = nn.Linear(d_model, vocab_size)
        # 权重共享
        self.fc_out.weight = self.embedding.weight

        # 记住这里一定要初始化
        # 注意 LayerNorm 的 weight/bias 和所有 bias 都是 1 维,会被跳过,保持 1 和 0
        for p in self.parameters():
            if p.dim() > 1:
                nn.init.xavier_uniform_(p)

    def forward(self, src, tgt, src_key_padding_mask=None, tgt_key_padding_mask=None, tgt_mask=None):
        src_emb = self.embedding(src) * math.sqrt(self.d_model)
        tgt_emb = self.embedding(tgt) * math.sqrt(self.d_model)

        src_emb = self.pos_encoding(src_emb)
        tgt_emb = self.pos_encoding(tgt_emb)

        memory = self.encoder(src_emb, src_key_padding_mask=src_key_padding_mask)
        outs = self.decoder(tgt_emb, memory, tgt_mask=tgt_mask, tgt_key_padding_mask=tgt_key_padding_mask, memory_key_padding_mask=src_key_padding_mask)

        return self.fc_out(outs)

model = Seq2SeqTransformer(
            config_shared_vocab_size,
            config_d_model,
            config_n_heads,
            config_d_ff,
            config_n_encoder_layers,
            config_n_decoder_layers,
            config_dropout,
            qk_norm=config_qk_norm).to(device)

print(f"Parameters: {sum(p.numel() for p in model.parameters()):,}")
可以看到输出以下内容。
说明我们这个网络有 63M 参数。
6.7.8 PyTorch 内置 LabelSmoothingLoss
PyTorch 内置的交叉熵损失支持 label_smoothing 参数,我们用这个就好。
6.7.9 照抄 Adam 优化器
Adam 是我们之前的老朋友了,照抄不变。
optimizer = torch.optim.Adam(
    model.parameters(),
    lr=1.0,
    betas=(config_adam_beta1, config_adam_beta2),
    eps=config_adam_eps,
)
6.7.10 PyTorch 内置 学习率调度器
PyTorch 内置了学习率调度器 Learning Rate Scheduler,它来帮助我们实现在训练过程中动态改变学习率。
我们把我们调学习率的函数和优化器一起传给它,它就会自动在优化器更新参数的时候帮忙去改学习率。
def lr_lambda(step: int):
    # torch.optim.lr_scheduler.LambdaLR 会从 step = 0 开始调用
    # 使用 step + 1 避免除零错误
    arg1 = (step + 1) ** (-0.5)
    arg2 = (step + 1) * (config_warmup_steps ** (-1.5))
    return config_d_model ** (-0.5) * min(arg1, arg2)

scheduler = torch.optim.lr_scheduler.LambdaLR(optimizer, lr_lambda=[lr_lambda])
6.7.11 训练函数
训练代码改变不大。
def short_attn_name(name: str) -> str:
    """encoder.layers.0.self_attn -> enc0.self ; decoder.layers.3.cross_attn -> dec3.cross"""
    parts = name.split(".")
    side = "enc" if parts[0] == "encoder" else "dec"
    layer = parts[2] if len(parts) > 2 else "?"
    kind = parts[-1].replace("_attn", "")
    return f"{side}{layer}.{kind}"


def collect_attn_modules(model):
    return [(short_attn_name(n), m) for n, m in model.named_modules()
            if isinstance(m, MultiHeadAttention)]


def peak_attention_score(attn_modules):
    # 返回 (最大 |score|, 所在模块简称)。调用前需要 record_scores 已经打开过一次前向。
    best_val, best_name = 0.0, "-"
    for name, mod in attn_modules:
        if mod.last_max_score > best_val:
            best_val, best_name = mod.last_max_score, name
    return best_val, best_name


@torch.no_grad()
def validate(model, dataloader, criterion, device):
    model.eval()
    total_loss, total_tokens = 0.0, 0
    for batch in dataloader:
        src, tgt_input, tgt_output, src_mask, tgt_mask = [x.to(device, non_blocking=True) for x in batch]
        tgt_seq_len = tgt_input.size(1)
        causal_mask = torch.triu(torch.ones(tgt_seq_len, tgt_seq_len, dtype=torch.bool, device=device), diagonal=1)

        with torch.amp.autocast('cuda', dtype=config_amp_dtype, enabled=config_use_amp):
            logits = model(src, tgt_input, src_key_padding_mask=src_mask, tgt_key_padding_mask=tgt_mask, tgt_mask=causal_mask)
            loss = criterion(logits.reshape(-1, logits.size(-1)).float(), tgt_output.reshape(-1))

        n_tokens = (tgt_output != PAD_ID).sum().item()
        total_loss += loss.item() * n_tokens
        total_tokens += n_tokens

    model.train()
    return total_loss / max(total_tokens, 1)


def train_epoch(model, dataloader, optimizer, criterion, device, global_step, epoch, scaler=None):
    model.train()
    use_scaler = scaler is not None and scaler.is_enabled()
    attn_modules = collect_attn_modules(model)

    # 整个 epoch 的累计(只用于 epoch summary)
    total_loss = torch.tensor(0.0, device=device)
    total_tokens = torch.tensor(0, device=device)
    # 打印窗口的累计,每次打印后重置。
    # 原版用整个 epoch 的累计平均,一个 micro-batch 出 NaN 会锁死本 epoch 剩下所有日志行。
    step_loss = torch.tensor(0.0, device=device)
    step_tokens = torch.tensor(0, device=device)

    accum_count = 0
    nonfinite_batches = 0
    skipped_updates = 0
    epoch_start = time.time()
    lr = optimizer.param_groups[0]["lr"]
    attn_peak, attn_where = 0.0, "-"

    for batch_idx, batch in enumerate(dataloader):
        src, tgt_input, tgt_output, src_mask, tgt_mask = [x.to(device, non_blocking=True) for x in batch]

        # 生成因果掩码 ,True 表示遮蔽
        tgt_seq_len = tgt_input.size(1)
        causal_mask = torch.triu(torch.ones(tgt_seq_len, tgt_seq_len, dtype=torch.bool, device=device), diagonal=1)

        is_log_batch = (batch_idx + 1) % config_log_every_steps == 0
        MultiHeadAttention.record_scores = is_log_batch

        with torch.amp.autocast('cuda', dtype=config_amp_dtype, enabled=config_use_amp):
            logits = model(src, tgt_input,
                           src_key_padding_mask=src_mask,
                           tgt_key_padding_mask=tgt_mask,
                           tgt_mask=causal_mask)
            loss = criterion(logits.reshape(-1, logits.size(-1)).float(), tgt_output.reshape(-1))
            loss = loss / config_grad_accum_steps

        MultiHeadAttention.record_scores = False
        if is_log_batch:
            attn_peak, attn_where = peak_attention_score(attn_modules)

        # 非有限值守卫:出现 NaN/Inf 就直接跳过这个 micro-batch,
        # 不做 backward,已经累积的梯度不受污染
        if not torch.isfinite(loss):
            nonfinite_batches += 1
            if nonfinite_batches <= 5:
                print(f" [warn] non-finite loss at epoch {epoch} batch {batch_idx + 1}, micro-batch skipped")
            del logits, loss
        else:
            if use_scaler:
                scaler.scale(loss).backward()
            else:
                loss.backward()

            n_tokens = (tgt_output != PAD_ID).sum()
            contrib = loss.detach() * config_grad_accum_steps * n_tokens
            total_loss += contrib
            total_tokens += n_tokens
            step_loss += contrib
            step_tokens += n_tokens
            accum_count += 1

        # 参数更新
        should_step = ((batch_idx + 1) % config_grad_accum_steps == 0) or ((batch_idx + 1) == len(dataloader))
        if should_step and accum_count > 0:
            if use_scaler:
                scaler.unscale_(optimizer)

            # 累积组不完整时把梯度放大回一个完整组的量级
            if accum_count != config_grad_accum_steps:
                correction = config_grad_accum_steps / accum_count
                for p in model.parameters():
                    if p.grad is not None:
                        p.grad.mul_(correction)

            torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=config_grad_clip_norm)

            if use_scaler:
                before = scaler.get_scale()
                scaler.step(optimizer)
                scaler.update()
                if scaler.get_scale() < before:
                    skipped_updates += 1
            else:
                optimizer.step()

            optimizer.zero_grad(set_to_none=True)
            scheduler.step()
            global_step += 1
            accum_count = 0
            lr = scheduler.get_last_lr()[0]

        # 日志打印
        if is_log_batch:
            elapsed = time.time() - epoch_start
            steps_done = batch_idx + 1
            eta_seconds = (elapsed / steps_done) * (len(dataloader) - steps_done) if steps_done > 0 else 0.0

            window_tokens = max(step_tokens.item(), 1)
            avg_loss = step_loss.item() / window_tokens
            ppl = math.exp(avg_loss) if math.isfinite(avg_loss) and avg_loss < 20 else float("nan")
            ppl_str = f"{ppl:.1f}" if math.isfinite(ppl) else "n/a"

            print(f" Epoch {epoch:2d}/{config_max_epochs} | Step {global_step:6d} | "
                  f"Batch {steps_done:5d}/{len(dataloader)} | "
                  f"Loss {avg_loss:.4f} | PPL {ppl_str} | LR {lr:.2e} | "
                  f"AttnMax {attn_peak:.1f} @{attn_where} | "
                  f"ETA {int(eta_seconds // 60)}m{int(eta_seconds % 60)}s")

            step_loss = torch.tensor(0.0, device=device)
            step_tokens = torch.tensor(0, device=device)

    avg_loss = total_loss.item() / max(total_tokens.item(), 1)
    ppl = math.exp(avg_loss) if math.isfinite(avg_loss) and avg_loss < 20 else float("nan")
    return global_step, avg_loss, ppl, nonfinite_batches, skipped_updates
6.7.12 开始训练
def state_dict_is_finite(state_dict) -> bool:
    return all(torch.isfinite(v).all().item() for v in state_dict.values() if v.is_floating_point())


def save_ckpt(path, model, optimizer, scheduler, scaler, step, epoch, best_val_loss):
    # 保存前检查参数是否有限。之前 checkpoints/latest.pt 就是一个 186 个张量全 NaN 的存档:
    # val_loss 是 NaN 时 `val_loss < best_val_loss` 为 False,于是走 else 分支照存不误。
    sd = model.state_dict()
    if not state_dict_is_finite(sd):
        raise RuntimeError(f"refusing to save non-finite model state to {path}")
    torch.save({
        'model': sd,
        'optimizer': optimizer.state_dict(),
        'scheduler': scheduler.state_dict(),
        'scaler': scaler.state_dict() if scaler is not None else None,
        'step': step,
        'epoch': epoch,
        'best_val_loss': best_val_loss,
    }, path)


print("\n--- Start Training ---")
import gc

for epoch in range(1, config_max_epochs + 1):
    print(f"\n--- Epoch {epoch}/{config_max_epochs} ---")
    gc.collect()

    global_step, train_loss, train_ppl, nonfinite_batches, skipped_updates = train_epoch(
        model, train_loader, optimizer, criterion, device, global_step, epoch, scaler)

    val_loss = validate(model, val_loader, criterion, device)
    val_ppl = math.exp(val_loss) if math.isfinite(val_loss) and val_loss < 20 else float("nan")

    attn_peak, attn_where = 0.0, "-"
    print(f"Epoch {epoch} Summary | Train Loss: {train_loss:.4f} | Val Loss: {val_loss:.4f} | "
          f"Val PPL: {val_ppl:.1f} | non-finite micro-batches: {nonfinite_batches} | "
          f"skipped updates: {skipped_updates}")

    if not math.isfinite(val_loss):
        print(" Validation loss is not finite, stopping.")
        break

    if val_loss < best_val_loss:
        best_val_loss = val_loss
        save_ckpt(os.path.join(config_checkpoint_dir, "best_model.pt"),
                  model, optimizer, scheduler, scaler, global_step, epoch, best_val_loss)
        print(" New best model saved.")
    else:
        save_ckpt(os.path.join(config_checkpoint_dir, "latest.pt"),
                  model, optimizer, scheduler, scaler, global_step, epoch, best_val_loss)
训练代码输出以下内容。
--- Start Training ---

--- Epoch 1/12 ---
 Epoch  1/12 | Step      5 | Batch    50/90625 | Loss 10.5265 | PPL 37289.0 | LR 1.05e-06 | AttnMax 5.1 @enc3.self | ETA 140m38s
 Epoch  1/12 | Step     10 | Batch   100/90625 | Loss 10.5135 | PPL 36809.1 | LR 1.92e-06 | AttnMax 5.5 @dec1.cross | ETA 130m43s
 Epoch  1/12 | Step     15 | Batch   150/90625 | Loss 10.4876 | PPL 35867.3 | LR 2.80e-06 | AttnMax 5.3 @enc3.self | ETA 126m24s
 Epoch  1/12 | Step     20 | Batch   200/90625 | Loss 10.4547 | PPL 34706.8 | LR 3.67e-06 | AttnMax 5.1 @enc3.self | ETA 123m31s
 Epoch  1/12 | Step     25 | Batch   250/90625 | Loss 10.4144 | PPL 33334.9 | LR 4.54e-06 | AttnMax 4.7 @dec3.cross | ETA 121m39s
 Epoch  1/12 | Step     30 | Batch   300/90625 | Loss 10.3789 | PPL 32174.6 | LR 5.42e-06 | AttnMax 4.7 @enc1.self | ETA 118m37s
 Epoch  1/12 | Step     35 | Batch   350/90625 | Loss 10.3477 | PPL 31184.9 | LR 6.29e-06 | AttnMax 4.8 @enc2.self | ETA 116m43s
 Epoch  1/12 | Step     40 | Batch   400/90625 | Loss 10.3171 | PPL 30244.9 | LR 7.16e-06 | AttnMax 4.6 @dec1.self | ETA 114m5s
 Epoch  1/12 | Step     45 | Batch   450/90625 | Loss 10.2829 | PPL 29227.6 | LR 8.04e-06 | AttnMax 4.6 @enc0.self | ETA 111m24s
 Epoch  1/12 | Step     50 | Batch   500/90625 | Loss 10.2576 | PPL 28498.5 | LR 8.91e-06 | AttnMax 4.9 @enc1.self | ETA 109m11s
 Epoch  1/12 | Step     55 | Batch   550/90625 | Loss 10.2298 | PPL 27717.1 | LR 9.78e-06 | AttnMax 5.1 @enc1.self | ETA 108m1s
 Epoch  1/12 | Step     60 | Batch   600/90625 | Loss 10.2007 | PPL 26920.9 | LR 1.07e-05 | AttnMax 4.8 @dec1.self | ETA 107m12s
 Epoch  1/12 | Step     65 | Batch   650/90625 | Loss 10.1694 | PPL 26093.6 | LR 1.15e-05 | AttnMax 4.6 @dec2.cross | ETA 106m24s
 Epoch  1/12 | Step     70 | Batch   700/90625 | Loss 10.1417 | PPL 25378.5 | LR 1.24e-05 | AttnMax 4.6 @enc0.self | ETA 105m14s
 Epoch  1/12 | Step     75 | Batch   750/90625 | Loss 10.1099 | PPL 24584.8 | LR 1.33e-05 | AttnMax 4.6 @enc0.self | ETA 104m31s
 Epoch  1/12 | Step     80 | Batch   800/90625 | Loss 10.0806 | PPL 23875.3 | LR 1.42e-05 | AttnMax 4.7 @dec1.self | ETA 103m29s
 Epoch  1/12 | Step     85 | Batch   850/90625 | Loss 10.0461 | PPL 23064.5 | LR 1.50e-05 | AttnMax 5.1 @enc1.self | ETA 102m45s
 Epoch  1/12 | Step     90 | Batch   900/90625 | Loss 10.0137 | PPL 22330.8 | LR 1.59e-05 | AttnMax 4.5 @enc0.self | ETA 102m37s
 Epoch  1/12 | Step     95 | Batch   950/90625 | Loss 9.9773 | PPL 21532.7 | LR 1.68e-05 | AttnMax 4.7 @enc1.self | ETA 102m30s
 Epoch  1/12 | Step    100 | Batch  1000/90625 | Loss 9.9411 | PPL 20766.2 | LR 1.76e-05 | AttnMax 4.7 @dec0.cross | ETA 102m17s
 Epoch  1/12 | Step    105 | Batch  1050/90625 | Loss 9.8986 | PPL 19902.8 | LR 1.85e-05 | AttnMax 4.8 @dec1.self | ETA 102m17s
...
 Epoch 12/12 | Step 108748 | Batch 90550/90625 | Loss 2.9296 | PPL 18.7 | LR 1.34e-04 | AttnMax 223.2 @enc4.self | ETA 0m5s
 Epoch 12/12 | Step 108753 | Batch 90600/90625 | Loss 2.8980 | PPL 18.1 | LR 1.34e-04 | AttnMax 222.2 @enc4.self | ETA 0m1s
Epoch 12 Summary | Train Loss: 2.9238 | Val Loss: 2.8777 | Val PPL: 17.8 | non-finite micro-batches: 0 | skipped updates: 0
 New best model saved.
可以观察到,我们的 Loss 一直在顺利下降,直到最后一轮都有所改善。
最后 PPL 降到了 17.8,比手动版的 18.1 要略低一点。
训练期间,机器的资源占用如下。
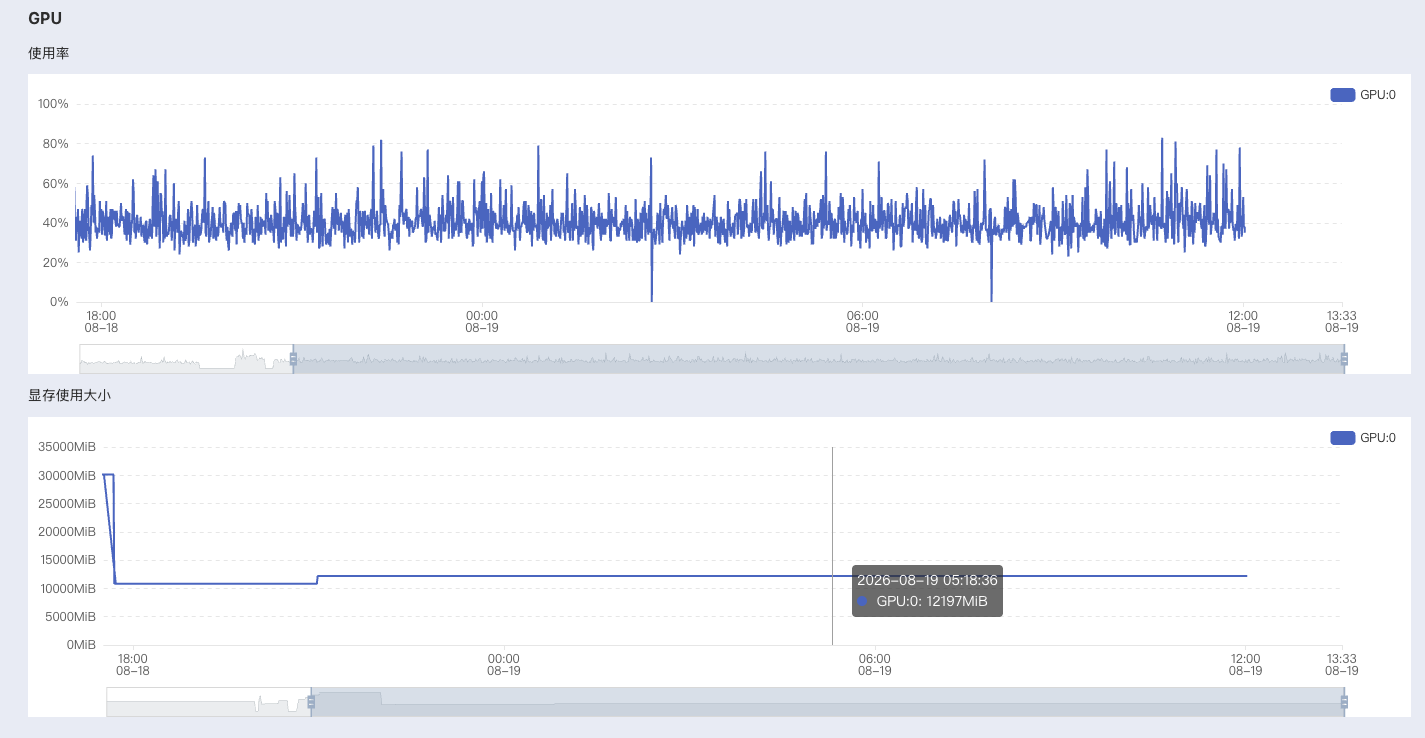
图 6-21 Torch 版 GPU 和显存的使用情况
可以观察到,我们 GPU 的使用率从 30% 提升到了 40%。同时,显存的占用下降了 40% 多。如果我们用更长的上下文,这个下降还会更明显。
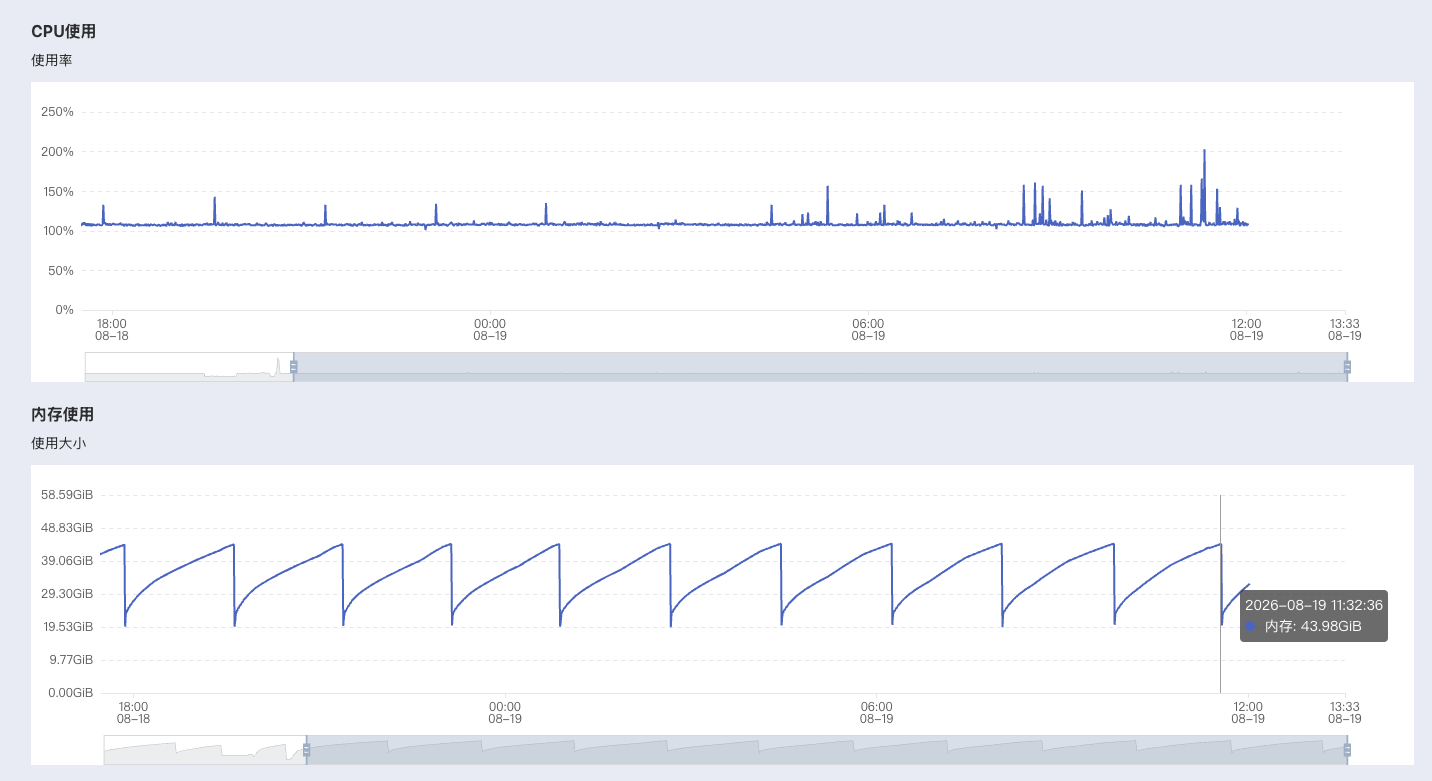
图 6-22 Torch 版 CPU 和内存的使用情况
CPU 和内存的情况没怎么变。
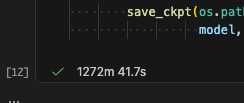
图 6-23 Torch 版训练时长
看看我们的注意力头训练得咋样。
# 数值余量检查:跑若干个真实 batch,打印每个注意力模块每个头的 max|score|。
# 判定标准:全部 < 500,且没有单个 head 比同层其它 head 高两个数量级。
@torch.no_grad()
def report_attention_scores(model, dataloader, n_batches=20):
    model.eval()
    stats = {}
    handles = []

    def make_hook(name, mod):
        def hook(_m, inputs, _out):
            query, key = inputs[0], inputs[1]
            with torch.autocast(device_type=query.device.type, enabled=False):
                b = query.size(0)
                q = mod._split_heads(mod.w_q(query.float()), b)
                k = mod._split_heads(mod.w_k(key.float()), b)
                q, k = mod.q_norm(q), mod.k_norm(k)
                sc = torch.matmul(q, k.transpose(-2, -1)) / math.sqrt(mod.d_k)
                per_head = sc.abs().amax(dim=(0, 2, 3)).cpu()
            prev = stats.get(name)
            stats[name] = per_head if prev is None else torch.maximum(prev, per_head)
        return hook

    for name, mod in model.named_modules():
        if isinstance(mod, MultiHeadAttention):
            handles.append(mod.register_forward_hook(make_hook(name, mod)))

    try:
        for i, batch in enumerate(dataloader):
            if i >= n_batches:
                break
            src, tgt_input, _, src_mask, tgt_mask = [x.to(device, non_blocking=True) for x in batch]
            n = tgt_input.size(1)
            causal_mask = torch.triu(torch.ones(n, n, dtype=torch.bool, device=device), diagonal=1)
            with torch.amp.autocast('cuda', dtype=config_amp_dtype, enabled=config_use_amp):
                model(src, tgt_input, src_key_padding_mask=src_mask, tgt_key_padding_mask=tgt_mask, tgt_mask=causal_mask)
    finally:
        for h in handles:
            h.remove()
        model.train()

    worst = 0.0
    print(f"{'module':34s} {'max|score|':>12s}   per-head")
    for name in sorted(stats):
        heads = stats[name]
        worst = max(worst, heads.max().item())
        print(f"{name:34s} {heads.max().item():12.2f}   " + " ".join(f"{v:7.2f}" for v in heads.tolist()))
    print(f"\nglobal max |score| = {worst:.2f}   (expected < 500 with QK-Norm; "
          f"fp16 overflow threshold in the hand-written version is 8188)")
    return worst

report_attention_scores(model, val_loader)
测试输出结果如下。
module                               max|score|   per-head
decoder.layers.0.cross_attn               19.18     16.19   16.39   19.18   16.56   16.54   16.14   18.88   18.66
decoder.layers.0.self_attn                21.99     16.12   11.86   21.99   13.41   11.05   10.54   15.76   17.87
decoder.layers.1.cross_attn               22.54     14.65   17.53   13.06   13.44   17.53   12.41   16.97   22.54
decoder.layers.1.self_attn                18.77     18.57   16.77   18.77   16.37   10.07   15.26   15.89   12.48
decoder.layers.2.cross_attn               25.74     15.41   15.45   17.38   18.75   25.74   19.32   22.25   22.05
decoder.layers.2.self_attn                15.86     12.64   10.18   13.58   15.86   12.21   12.13   14.70   12.49
decoder.layers.3.cross_attn               36.37     36.37   32.95   29.45   34.00   34.73   33.64   35.80   30.71
decoder.layers.3.self_attn                16.25      9.18    8.37   13.42    8.73   16.25   13.92   11.97   12.34
decoder.layers.4.cross_attn               48.28     48.28   47.21   45.13   40.64   44.57   46.85   44.82   45.01
decoder.layers.4.self_attn                28.99     26.86   19.35   24.49   27.75   27.93   27.45   24.07   28.99
decoder.layers.5.cross_attn               59.90     55.25   57.48   58.36   58.61   54.72   59.66   58.27   59.90
decoder.layers.5.self_attn                60.43     52.76   59.40   57.66   41.95   57.46   52.53   60.43   54.35
encoder.layers.0.self_attn                24.41     24.39   19.41   13.74   16.06   20.96   19.73   23.78   24.41
encoder.layers.1.self_attn                35.47     33.17   27.79   34.21   35.47   30.97   34.19   31.65   19.10
encoder.layers.2.self_attn                79.33     71.54   59.73   73.00   68.01   68.30   79.33   69.74   69.64
encoder.layers.3.self_attn               122.63     99.25   97.78  113.33  122.63  114.30  103.83  122.51  109.06
encoder.layers.4.self_attn               223.76    204.87  199.25  223.76  217.44  206.82  216.62  210.84  212.80
encoder.layers.5.self_attn               205.40    201.11  196.93  198.37  202.69  195.96  196.48  203.48  205.40

global max |score| = 223.76   (expected < 500 with QK-Norm; fp16 overflow threshold in the hand-written version is 8188)
223.75674438476562
6.7.13 推理测试
@torch.no_grad()
def translate(model, tokenizer, text, max_len=256, beam_size=4, length_penalty=0.6, device=torch.device("cuda")):
    model.eval()
    src_ids = tokenizer.encode(text)[:max_len]
    src_tensor = torch.tensor([src_ids], dtype=torch.long).to(device)
    src_key_padding_mask = torch.zeros_like(src_tensor, dtype=torch.bool).to(device)

    # 编码
    src_emb = model.embedding(src_tensor) * math.sqrt(model.d_model)
    src_emb = model.pos_encoding(src_emb)
    memory = model.encoder(src_emb, src_key_padding_mask=src_key_padding_mask)

    # 束搜索
    beams = [([BOS_ID], 0.0, False)]
    completed = []

    for _ in range(max_len):
        if not beams: break
        candidates = []
        for tokens, score, finished in beams:
            if finished:
                candidates.append((tokens, score, True))
                continue
            if tokens[-1] == EOS_ID:
                completed.append((tokens, score))
                candidates.append((tokens, score, True))
                continue

            tgt_tensor = torch.tensor([tokens], dtype=torch.long).to(device)
            # 生成当前步的因果掩码
            causal_mask = torch.triu(torch.ones(len(tokens), len(tokens), dtype=torch.bool, device=device), diagonal=1)

            # 解码
            tgt_emb = model.embedding(tgt_tensor) * math.sqrt(model.d_model)
            tgt_emb = model.pos_encoding(tgt_emb)
            decoder_out = model.decoder(tgt_emb, memory, tgt_mask=causal_mask, memory_key_padding_mask=src_key_padding_mask)
            logits = model.fc_out(decoder_out[:, -1, :])

            log_probs = torch.log_softmax(logits, dim=-1)
            log_probs[0][UNK_ID] = float("-inf")

            topk_log_probs, topk_indices = torch.topk(log_probs[0], beam_size)
            for i in range(beam_size):
                new_score = score + topk_log_probs[i].item()
                new_tokens = tokens + [topk_indices[i].item()]
                candidates.append((new_tokens, new_score, topk_indices[i].item() == EOS_ID))

        candidates.sort(key=lambda x: x[1] / (len(x[0]) ** length_penalty), reverse=True)
        beams = candidates[:beam_size]
        if all(f for _, _, f in beams): break

    if not completed:
        for t, s, _ in beams: completed.append((t, s))
    completed.sort(key=lambda x: x[1] / (len(x[0]) ** length_penalty), reverse=True)

    best_ids = [i for i in completed[0][0] if i not in (BOS_ID, EOS_ID, PAD_ID)]
    return tokenizer.decode(best_ids), completed[0][1]
试试短句。
model.load_state_dict(torch.load(os.path.join(config_checkpoint_dir, "best_model.pt"), map_location=device)['model'])
test_sentences = ["The weather is nice today .", "I have two brothers ."]
for sent in test_sentences:
    res, score = translate(model, tokenizer, sent, device=device)
    print(f"EN: {sent}\nCN: {res}\nScore: {score:.2f}\n")
看看翻译结果。
EN: The weather is nice today .
CN: 今天天气很好。
Score: -1.91

EN: I have two brothers .
CN: 我有两个兄弟。
Score: -1.40
还不错。再试试长难句。
long_sent = "The fact that the scientist who the committee had appointed to oversee the project which was funded by the government ignored the safety protocols resulted in a catastrophic failure."
res, score = translate(model, tokenizer, long_sent, device=device)
print(f"EN: {long_sent}\nCN: {res}\nScore: {score:.2f}\n")

long_sent = "I have nothing in common with lazy people who blame others for their lack of success; I believe that if you are not willing to learn, no one can help you, and if you are determined to learn, no one can stop you."
res, score = translate(model, tokenizer, long_sent, device=device)
print(f"EN: {long_sent}\nCN: {res}\nScore: {score:.2f}\n")
看看翻译结果。
EN: The fact that the scientist who the committee had appointed to oversee the project which was funded by the government ignored the safety protocols resulted in a catastrophic failure.
CN: 委员会任命监督由政府资助的项目的科学家忽视了安全协议,从而造成了灾难性的失败。
Score: -14.73

EN: I have nothing in common with lazy people who blame others for their lack of success; I believe that if you are not willing to learn, no one can help you, and if you are determined to learn, no one can stop you.
CN: 我和懒散的人没有什么共同之处,他们因为失败而责备别人,我相信如果你不愿意学习,没有人能帮助你,如果你决心学习,没有人能阻止你。
Score: -23.23
小惊喜。第 2 个长句比我们之前的手写版翻译质量还要再高一些。
6.8 Transformer 小结
2022 年的 ChatGPT 是大模型产品爆发的起点,作为它核心架构的 Transformer 则是技术爆发的起点。
相对于之前的网络一次只给几个概念,它一下子塞给我们一堆东西。对于学习者来说,身体有点乏,脑子有点乱,都是正常的。毕竟那个时期已经是一大票天才和资本在共同努力。他们共同爆发输出了这几年,我们要在几个小时内全部跟上,累是正常的。
我们稍微总结一下 Transformer 给我们带来了些什么?对未来我们去创造自己的网络有什么启发?
首先,最重要的当然就是自注意力。当初,面对翻译场景时,拿着原文去找对应译文,是自然的想法。但 Transformer 用自注意力机制告诉我们,翻译之前要先把原文给读明白。先要让原文内部的 token 互相拉扯一阵子,在源文本内部产生一个全盘的理解。而且,要一目十行,要快。正是这一点,让 Transformer 未来跨出了翻译场景,走向更为广阔的因果模型。
岔出去一下…… 理解「注意力」的时候,我们别被这个词迷惑。不要去望文生义地从「一个词主动去注意另一个词」这个角度出发,从 ten 这个「词被另一个词拉扯」的词根去理解,可能更容易理解注意力机制是在干嘛。
再来, Transformer 首次把大模型的网络结构变成了一个多元化的复合结构。在当时来说,它的网络结构算得上是相当异构了。回头看,之前的网络都是零件。跟之前混沌一片的神经网络不同的是,Transformer 把网络的功能分门别类,异构的子模块们各司其职,共同解决复杂的语言问题。这样带来 2 个好处。一个是类似脑把功能分为大脑、小脑、脑干,研究们可以让已经确定完成任务的子模块稳定下来,集中精力改进那些仍不完善的子模块。另一个是它给未来的大模型去完成更复杂的任务留下了一个插件架构,比如多模态大模型插进去的视觉理解子模块。
最后,它奠定了大模型最基础的框架。就像迈巴赫确立的「方向盘-发动机-低重心四轮-独立车架」的汽车架构, Transformer 也为语言大模型确立了「词嵌入-位置编码-注意力-前馈网络」的架构。现在我们可以读到的论文数量有点爆炸,但是这些论文的主题大多是可以被分类的。今天模型架构的论文大多是在嵌入式向量、位置编码、语言自理解方法、注意力变体、归一化、推理预测效率、上下文长度等方面去改进,框架是没有大变的。Transformer 奠定的这个架构,给学习者和研究者都带来了极大的便利。既有利于他们分门别类地去跟上最新的技术进展,也有利于去思考自己的创新点在哪里。毕竟,突破边界得先有一个边界。
6.8.1 收拾魔法袋
魔法袋再次扩充了。
现在一页显示不下了,我们给它换一个收纳方式。
| 序号 | 类目 | 组件示例 | 功能说明 |
|---|---|---|---|
| 1 | 数据工具 | utils.data.Dataset |
数据集基类 |
| 2 | utils.data.DataLoader |
数据分批次使用 | |
| 3 | data.to('cuda') |
数据移至 GPU | |
| 4 | hf - load_dataset() |
数据加载器 | |
| 5 | sentencepiece.SentencePieceProcessor |
BPE 分词器 | |
| 6 | 容器 | nn.Module |
自定义网络 |
| 7 | nn.Sequential |
顺序层连接器 | |
| 8 | nn.ModuleList |
模块列表 | |
| 9 | 功能层 | nn.Linear |
线性层 / 全连接层 |
| 10 | nn.Flatten |
展平层 | |
| 11 | nn.Conv2d |
卷积层 | |
| 12 | nn.AvgPool2d |
平均池化层 | |
| 13 | nn.Embedding |
嵌入层 | |
| 14 | 算子 | torch.nn.functional.scaled_dot_product_attention() |
缩放点积注意力 |
| 15 | nn.functional.one_hot() |
独热编码 | |
| 16 | 损失函数 | nn.MSELoss |
均方误差损失,回归任务用 |
| 17 | nn.CrossEntropyLoss |
交叉熵损失,分类任务用 | |
| 18 | 优化器 | optim.SGD |
随机梯度下降 |
| 19 | optim.Adam |
Adam优化器 | |
| 20 | 激活函数 | nn.ReLU |
ReLU 激活函数 |
| 21 | 稳定训练工具 | nn.BatchNorm2d |
批归一化层 |
| 22 | nn.LayerNorm |
层归一化 | |
| 23 | nn.init.*() |
参数初始化 | |
| 24 | nn.utils.clip_grad_norm_() |
梯度裁剪 | |
| 25 | 防止过拟合工具 | nn.Dropout |
随机失活 (正则化/抑制过拟合) |
| 26 | torchvision.transforms |
数据预处理 / 图像变换 (数据增强) | |
| 27 | nn.CrossEntropyLoss(label_smoothing=0.1) |
标签平滑交叉熵损失 | |
| 28 | 精度工具 | torch.autocast |
混合精度自动转换 |
| 29 | torch.amp.GradScaler |
混合精度梯度缩放 | |
| 30 | 成品网络 | nn.RNN |
循环神经网络 |
| 31 | nn.LSTM |
长短期记忆网络 | |
| 32 | nn.GRU |
门控循环单元 | |
| 33 | nn.Transformer |
Transformer 模型 | |
| 34 | nn.MultiheadAttention |
多头注意力机制 |
这次确实有点多了。我们来稍微回顾一下如何使用这些工具。
-
数据准备 : 使用「数据工具」;
-
搭建网络 :使用「容器」、「功能层」、「算子」 和 「激活函数」;
-
更新参数 :选定「损失函数」和「优化器」;
-
训练失败了,调优网络:
- Loss 训飞了,选用「稳定训练工具」;
- 训出来了但是效果不好,选用「防止过拟合工具」;
- 资源不足,训练太慢,想做性能优化,选用「精度工具」;
如果不是创造新的网络构件,训练一个网络的主要挑战在第 4 步。
一方面,我们希望网络能顺利学出来,于是就不停地给它去除噪音,这就叫「归一化」。归一化的极致就是真的所有数据都变成 1 了,那网络肯定学出来了。
另一方面,这样学出来的网络去测试集上一跑,那肯定废废的。于是,我们又得给它加入随机性,那就是「正则化」。所以归一和正则某种程度上其实是一个数轴的两端,是留给训练者去权衡定夺的事。
当然,还有额外再制造麻烦的「精度工具」。活够细的话,可以在搭建网络的初期就想好每一层的动态范围,直接用上「精度工具」。
6.8.2 未竟事宜
今天我们真是做了一个「大」工作。有点累,但真值。动手回味神经网络的历史一刻,这一天的光阴也算没有虚度。
但是,学无止境,更何况我们才追到 10 年前呢。Transformer 2017 年出生,现在已经 2026 年了,同志仍须努力。
今天我们也有 2 个未竟的事宜:
-
nn.Transformer 实现 今天我们用了 PyTorch 2.0 发布的 SPDA 算子来实现了我们的 Transformer。在 SPDA 之上 PyTorch 还封装了 nn.MultiheadAttention 和 nn.Transformer 这两个更高级的 API 供我们使用。我们可以尝试用这两个更高级的 API 再去搭建一次我们的网络。需要注意的是,因为这两个 API 都出生在 SPDA 之前,所以里面留了不少兼容逻辑,玩的时候千万别因为它是高层 API 而轻视它。
-
性能优化 我们 2 个版本的 GPU 使用率都没到 50%。浪费 GPU 直接等于浪费钱,更是浪费模型上市的时间成本。现在高速显存 HBM 很贵,相关股票疯涨就是这个原因。我们的程序主要可以考虑从 2 个方向去优化。一个是从内存进入显存的过程,这是 CPU 、磁盘 IO 和内存负责的部分,优化指标是 GPU 使用率。手段的话,可以考虑把数据集整个放到 /dev/shm 或者做个 mmap 内存映射。再一个是从显存进入片上缓存的过程,也就是 Flash Attetion 优化的部分,优化指标是 MFU。手段的话,可以考虑使用更加融合的算子,或是使用更高速的显存,比如从 GDDR 换到 HBM。
-
KV Cache 都见识过 KV Cache 吃显存的厉害了。跑一个长上下文的大模型时,有时它吃掉的显存比大模型本体吃掉的还多。即使它这么废,也从没听过说有人关闭 KV Cache 去节省显存的。可见这个优化无可或缺的程度。KV Cache 和 Flash Attention 一样是一个在比较长的上下文才能发挥威力的优化,所以今天我们这个翻译场景并没有实现它。
顾名思义,KV Cache 就是把 \(K\) 和 \(V\) 的计算结果给缓存下来,以避免重复计算。KV Cache 是一个纯应用于 Decoder 的优化。因为 Encoder 一次能读到全部的原文,一下子就把隐变量算出来了,没啥可以去读 Cache 的机会。但是 Decoder 是一个词一个词蹦的,在这个过程中,虽然新来的词的 \(Q\) 没算过得重新计算,但是前面 Token 的 \(K\) 和 \(V\) 都是算过了的,非常适合搞个 Cache 给它们存下来。这也是为什么大家都说 Prefill 是一个计算密集型的场景,而 Decode 是一个带宽敏感的场景,就是因为到了长上下文 Decode 蹦词的时候,大部分的 \(K\) 和 \(V\) 已经被 Prefill 给算完了,只有一小部分 \(K\) 和 \(V\) 需要重新计算,大部分的 \(K\) 和 \(V\) 是可以从 Cache 里读出来的。
具体到我们的代码里,如果要实现 KV Cache,我们大概应该从 class MultiHeadAttention 类的 forward 函数下手。
def forward() :
    # 这里就变成只计算当前 Token 的 Q、K、V
    Q = self.W_q(query).view(batch_size, -1, self.n_heads, self.d_k).transpose(1, 2)
    K = self.W_k(key).view(batch_size, -1, self.n_heads, self.d_k).transpose(1, 2)
    V = self.W_v(value).view(batch_size, -1, self.n_heads, self.d_k).transpose(1, 2)

    # 在这里读取 KV Cache
    # 把之前的 K, V 计算结果直接拼上
    # 就是这一步费显存带宽,把 HBM 带得奇贵无比
    if k_cache is not None and v_cache in not None:
        # 因为每次 Decode 都需要前面的所有词
        # KV Cache 是不存在「缓存命中」的,全都得拼上
        # 自然,也就不存在缓存写入和缓存更新,拼上就自动更新了
        K = torch.cat([k_cache, K], dim=2)
        V = torch.cat([v_cache, V], dim=2)

    # 后续逻辑保持不变
    scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(self.d_k)
当然,调用它的代码也得跟着改,得找个地方存住这 2 个 Cache,再一层层的把 Cache 传进来。
就像代码中演示的,我们所有的 Token 都要占 KV Cache。而且,因为我们有好几层 Decode 叠拼呢,每层肯定算出来都不一样,所以每一层都得有一个自己的独立的 KV Cache。这样,我们就能理解计算 KV Cache 大小的这个公式了。
式 6-33 KV Cache 大小的计算方法
其中最开始那个 2 是指的 \(K\) 和 \(V\) 是要分别开两个独立的 Cache 的。
一个问题: KV Cache 这么难算,为啥不直接把所有的 \(K\) 和 \(V\) 都算完了预存起来呢?
答: 好想法。但很不幸,每个 \(K\) 和 \(V\) 在第一步就混了位置编码进来。要是遍历所有的 \(K\) 和 \(V\) 和所有位置的结果,那也太大了。
那另一个问题: 既然位置编码导致我们无法跨 Session 去 Cache,那 vLLM 的 Prefix Cache 和 sgLang 的 RadixAttention 是咋回事?
答: 其实它们也无法无视位置编码跨 Session 去 Cache。它们生效都有一个共同的前提:2 个不同的 Session 是以一段相同的前缀开始的。这样的话,位置编码就不会出来捣乱,其实就和同一个 Session 是一回事了。看名字 RadixAttention 能看出来,这部分实现也是嵌入在注意力的那一坨代码里的。
最后一个问题: 如果跨 Session 做 Cache 这么难,为啥 DeepSeek 的缓存命中率这么高?似乎明显高于其它家的实现?
答: 这就是人家厉害且闭源的部分了。根据 DeepSeek 在官网公开的信息 来看,他们把 KV Cache 给落硬盘了。而且,切出共同前缀的逻辑写得相当用心。这缓存代码要实现显存、内存、硬盘 3 级同步,没准还会加上网络 4 级同步,想要写明白想来是有点水平的。
那当然,持久化到硬盘的生命周期肯定比显存或者内存高上好几个数量级。而且,还有一个合理的猜测是,硬盘缓存的跨节点分发和共享成本也明显低于显存缓存和内存缓存,既然落硬盘了,这一点想来也会好好利用。
总之,这应该是命中了 DeepSeek 相当擅长的推理优化的部分。但是,这样也是无法打破位置编码屏障的。对于网上晒出来那些 99% 的命中率,站在 DeepSeek 外面猜的话,我只能理解为现在的 Agent 废话实在是太多了……
我们今天没有实现 KV Cache,是因为 Transformer 还没有真正遇到长句的挑战。甚至注意力在论文中还是作为一个性能优化手段被剔除的,因为它的计算是常数时间。
a self-attention layer connects all positions with a constant number of sequentially executed operations, whereas a recurrent layer requires O(n) sequential operations. In terms of computational complexity, self-attention layers are faster than recurrent layers when the sequence length n is smaller than the representation dimensionality d, which is most often the case with sentence representations used by state-of-the-art models in machine translations
彼时彼刻,KV Cache 和性能优化还不是一个 MUST。
彼时彼刻, 《Attentionion Is All You Need》 的作者们点燃了引线,但他们还不知道这个引线的后面是连了多大的一颗大爆竹。
5 年之后,震惊世界的一声惊雷即将炸响。
6.9 Small Talk:和 AI 扯扯淡
6.9.1 提问
Kimi 你好,很遗憾你不让我用你最新的 K3。我有一个问题想请教:未来大模型理解人类语言时,会采用什么结构?
如果用我读书来类比的话,显然我读书并不是像 RNN 那样一个字一个字读的。但我肯定也不是像自注意力样一秒把所有的字都映射到脑子里了。我读书的方式还是一页一页的,但是一目十行的,会自动过滤修辞等不重要的字,然后一边读一边在脑子里概括作者用意。现在的 Mamba 结构是不是就有点这个意思?它或者它的变体未来会有机会吗?kimi 你觉得这块的下一个大的突破可能会出现在哪个方向呢?
6.9.2 Kimi-2.6 答
你的直觉非常敏锐,这个"读书"的类比其实抓住了当前架构争论的核心矛盾。让我从几个层面来回答你:
6.9.2.1 一、你的类比为什么特别准
你说得对——人类阅读确实处于 RNN 和 Transformer 两个极端之间:
| 方式 | 机制 | 问题 |
|---|---|---|
| RNN | 逐字读,每个新词都要经过同一个窄门(隐藏状态) | 像是一个字一个字啃书,前面的内容会不断被"冲刷"掉 |
| Transformer | 一眼把整页所有字都扫进脑子里,两两之间建立联系 | 像是一秒钟把全书摊开在眼前,但代价是注意力计算的复杂度随长度平方爆炸 |
| 人类阅读 | 一页一页翻,一目十行,自动过滤修辞,边读边在脑子里压缩成"作者想说什么" | 需要 选择性注意 + 层次化压缩 + 增量式状态更新 |
你提出的"一页一页、一目十行、自动过滤、边读边概括"这四个特征,其实恰好对应了下一代架构正在探索的四个方向。
6.9.2.2 二、Mamba 确实有点这个意思,但还不够
Mamba(以及更广泛的 State Space Model, SSM)的核心创新是 选择性状态空间(Selective State Space) 。
这确实很像你描述的阅读方式:
- 选择性 :遇到"然而""因此"这种逻辑词时,Mamba 会动态调整"步长"(step size ∆),像人读到关键转折句时会放慢速度、仔细品味
- 状态压缩 :它维护一个紧凑的隐藏状态,把历史信息压缩进去,而不是像 Transformer 那样把整段历史都摊在 KV Cache 里
- 线性复杂度 :处理长文本时,计算量随长度线性增长,不像 Transformer 那样平方爆炸
但是,Mamba 目前的局限性也很明显:
- 它仍然是"一行一行"读的 ——虽然比 RNN 快,但本质上还是序列扫描,缺乏人类"先扫目录再决定重点读哪章"的 层次化浏览 能力
- 状态的压缩是有损的 ——就像你读完一本书后,脑子里留下的"概要"可能丢失了很多细节。Mamba 在需要精确检索(比如"第三段第二行说了什么")时,表现不如 Transformer
- 缺乏显式的"工作记忆"和"长期记忆"分离 ——人脑有短期工作记忆(能同时保持 4-7 个组块)和长期记忆之分,而 Mamba 只有一个状态向量
最新的 Mamba-3 在推理效率上做了很大优化,引入了复数值状态跟踪和 MIMO(多输入多输出)投影,但它的基本范式仍然是"维护一个压缩状态",没有解决层次化阅读的问题。
6.9.2.3 三、下一个大突破可能出现在哪里?
结合 2026 年最新的研究动向,我认为下一个质变可能来自以下几个方向的 交叉融合 ,而不是单一架构的胜出:
方向 1:层次化稀疏注意力(Hierarchical Sparse Attention)
这是对你"一页一页、一目十行"最直接的工程实现。最新的 Double-P 框架 采用了两层结构:
- 第一层:先在"簇"(cluster)级别做粗筛,像人先扫一眼段落大意
- 第二层:再对重要的簇分配精确的 token 级注意力,像人对关键段落逐句细读
微软的 SPIN 系统 更进一步,把层次化稀疏注意力和分层存储(GPU HBM + CPU DRAM)结合起来,让模型能像人脑一样,把"当前在看的几页"放在快速工作记忆里,把"整本书"放在慢速长期记忆里按需调取。
这已经非常接近你描述的阅读方式了: 不是全看,也不是只看一个字,而是有层次地、按需地、动态地分配注意力。
方向 2:显式记忆系统(如 Titans)
Google DeepMind 的 Titans 提出了一个三层记忆架构:
- 持久记忆 :模型权重本身(像你已经学会的知识)
- 长期记忆 :一个可微分的记忆模块,能在推理时持续写入新信息(像你做笔记)
- 短期记忆 :标准 Transformer 的注意力窗口(像你眼前正在看的这段文字)
这比 Mamba 的"单一压缩状态"更接近人类认知。人读书时确实会一边读一边在脑子里形成"笔记"——可能是几个关键词、一个论点框架、一种情绪印象。Titans 试图显式地建模这个过程。
方向 3:世界模型与 JEPA(Joint Embedding Predictive Architecture)
Yann LeCun 一直在推动的 JEPA 代表了另一种思路:不是让模型去"预测下一个 token",而是让模型去学习 世界的抽象表征 ,并预测未来状态。
这对应你所说的"一边读一边在脑子里概括作者用意"——JEPA 的核心不是语言序列建模,而是 因果推理和状态预测 。LeCun 认为,纯从文本训练永远达不到人类水平的理解,因为"世界比语言复杂得多"。
方向 4:混合架构(Hybrid)与扩散语言模型
腾讯的 Hunyuan-T1 采用了"混合 Transformer-Mamba 专家混合"架构 ——让 Transformer 专家处理需要精确注意力的局部细节,让 Mamba 专家处理长程依赖和状态压缩。
另一个值得关注的方向是 扩散语言模型(Diffusion LLM) ,如 LLaDA 和 Mercury 。它们不是从左到右生成,而是像人构思文章一样,先搭框架再逐步细化——先写出所有段落的大意,再回头打磨措辞。这种"全局到局部"的生成方式,某种程度上也模拟了人脑的组织过程。
6.9.2.4 四、我的判断:下一个大突破会是什么?
如果让我押注,我认为 下一个质变不会来自单一的 Mamba 变体,而会来自"认知架构"层面的重新设计 ——也就是把以下三个东西显式地分离并协同起来:
- 感知/浏览层 :像人眼一样快速扫描,做层次化稀疏注意(对应 Double-P、SPIN)
- 工作记忆层 :像 Mamba/Titans 一样维护一个紧凑的、可选择性更新的状态
- 长期记忆/世界模型层 :像 JEPA 一样,不是记文本,而是记"这个世界是怎么运转的"
现在的 Transformer 把这三件事都混在"注意力权重"里做了;Mamba 把 1 和 2 混在一起做了;未来的模型可能会把这三层 显式分离 ,让它们各自用最合适的机制运行,再通过一个"认知控制器"来协调。
你的"读书"类比其实暗合了认知科学里的 "全局工作空间理论"(Global Workspace Theory) ——人脑不是均匀处理所有信息的,而是有一个"聚光灯"式的注意力系统,把关键信息送进一个全局可访问的工作空间,其他模块(记忆、推理、情感)再围绕这个工作空间进行协作。
如果大模型架构能朝着这个方向演进—— 有选择地关注、有层次地压缩、有结构地记忆 ——那可能才是真正意义上的"像人一样理解语言"。Mamba 是这个方向的一块重要拼图,但恐怕不是最后一块。